CosmoH2G: 面向复杂空间运动物体操作的手到夹爪迁移数据集与基线方法
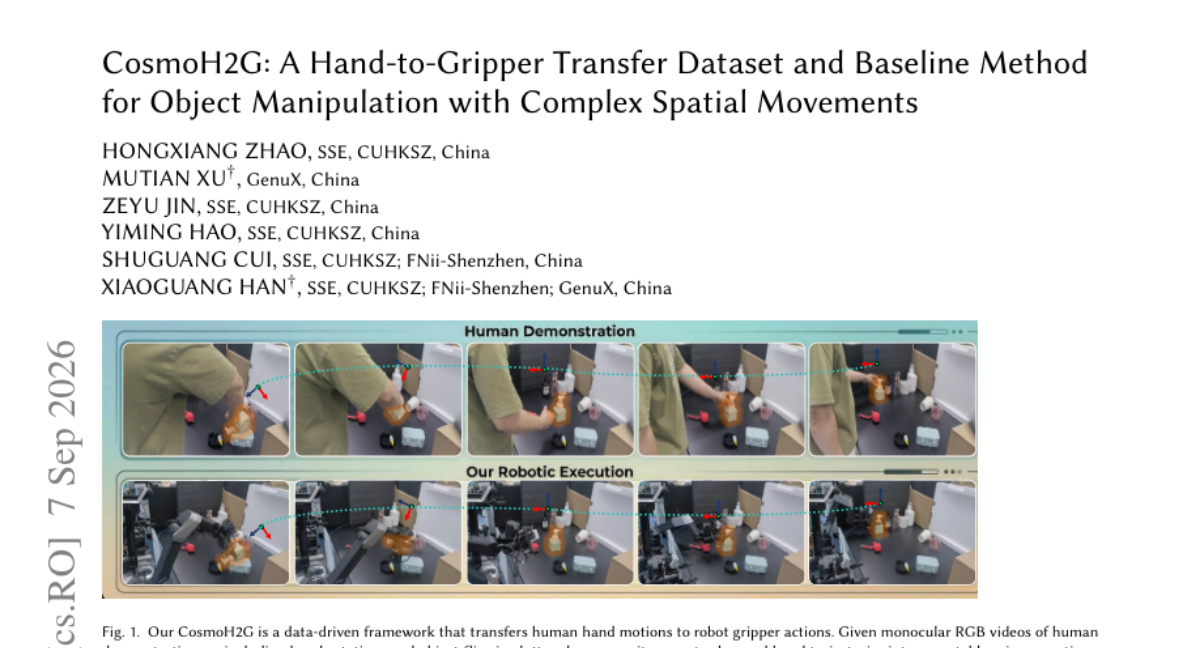
近年来,将人类手部演示迁移到机器人夹爪已成为一种低成本且高效的机器人学习方案。然而,现有方法大多局限于简单的平面任务,难以处理复杂空间运动(例如涉及旋转或翻转的精细轨迹),而这些运动对机器人操作至关重要。为弥补这一空白,我们采用隐式、数据驱动的方式,以细粒度的 hand-pose motions 作为引导。 为此,我们提出一套可扩展的采集流程,在严格的协议下收集 hand-gripper paired demonstrations:该协议优先考虑运动复杂度,并借助手持夹爪实现动作的无缝模仿。最终构建出大规模配对数据集,包含 1,254 个不同物体、共 6,189 条 episode,其空间复杂度显著高于现有 benchmark。 然而,学习如此复杂的映射仍具挑战。我们发现,直接端到端生成完整夹爪位姿序列并不可行,细微的轨迹偏差在复杂动力学下会迅速累积。为此,我们提出 two-stage framework: - Stage I 预测 sparse gripper keyframes(初始与终止帧),以简化映射目标; - Stage II 以这些关键帧为条件,生成完整的连续动作序列。 此外,为缓解累积漂移,我们保持夹爪朝向为可学习状态,同时基于 grasping heuristic 与 kinematic consistency 对其平移进行后优化。 在仿真与真实机器人实验中,我们的框架实现了稳定且精确的复杂空间 hand-to-gripper 操作迁移,显著优于传统 baseline。项目主页:https://cosmoh2g.github.io。
论文精读
TL;DR CosmoH2G 构建了包含复杂空间运动的手-夹爪配对数据集,并提出两阶段框架:先预测稀疏关键帧,再生成连续动作并做运动学后优化,实现稳定精确的复杂操作迁移。
问题
问题背景:跨实体学习(cross-embodiment learning)正成为降低机器人数据采集成本的关键路径,其中从人手演示迁移到机器人夹爪(hand-to-gripper)的方法因可直接利用互联网视频或普通摄像头采集示范而备受关注。
现有方法局限:当前多数 hand-to-gripper 迁移方法假设任务轨迹近似平面,仅处理简单抓取或平移运动,无法表达物体翻转、绕多轴旋转等复杂空间运动。端到端直接回归完整夹爪位姿序列在长时序、强非线性轨迹下会快速累积误差:初始微小的姿态偏差在后续步骤中被放大,导致抓取偏移或碰撞。此外,公开数据集普遍缺乏高空间复杂度的成对手-夹爪演示,训练出的映射模型难以泛化到三维空间中的精细操作。
为什么难/重要:人手与夹爪在自由度和观测模态上存在显著差异,从单目 RGB 视频中恢复稳定的 3D 手部姿态本身具有歧义,再映射到夹爪的 6DoF 位姿需要解决跨实体、高维时序对齐。复杂空间运动(例如翻转物体)要求同时控制位置、朝向以及抓取稳定性,传统基于启发式或解析解的映射难以泛化。在物流分拣、装配、服务机器人等应用中,非平面操作普遍存在,因此业界亟需能处理三维空间运动的低成本示教迁移方案。
行业类比:类似自动驾驶中从人类驾驶员视频学习端到端策略,但需要更精细地将人手自由度压缩到夹爪约束下,同时保持三维轨迹的物理一致性。
核心洞察
- CosmoH2G 数据集突破了现有 hand-to-gripper 学习局限于平面任务的瓶颈,通过手持夹爪采集和运动复杂度优先协议,构建了大规模、高空间复杂度的配对演示。现有数据集大多关注简单抓取或平面移动,缺乏旋转、翻转等复杂 3D 轨迹,而 CosmoH2G 包含 6,189 个 episode、1,254 个物体,覆盖显著更高的运动复杂度,为评估跨具身迁移算法提供了更贴近真实操作需求的基准。
- 两阶段框架将完整 gripper 位姿序列生成解耦为稀疏关键帧预测与连续动作生成,并对平移进行基于抓取启发式和运动学一致性的后优化,有效抑制了长序列累积漂移。端到端生成在复杂动态下微小轨迹偏差会迅速放大,而该工作先预测起始和终止关键帧降低学习目标复杂度,再生成中间动作,同时保持方向学习、后优化平移,显著提升了复杂空间操作中迁移的稳定性和精度,在与传统 baseline 的对比中表现出明显优势。
方法
输入与数据预处理
- 输入为单目 RGB 手部演示视频,通过手部网格跟踪与 Hand-Object-Interaction 接触图,提取精细的 3D 手部姿态运动序列。
- 手部运动数据经注册对齐后,作为跨实体映射的条件信号。
关键模块:两阶段生成框架
- 阶段一:稀疏关键帧预测
从手部姿态序列中预测夹爪的起始与终端关键帧(包含位置与方向),将高维连续轨迹映射问题简化为少量关键姿态估计,降低学习难度。 - 阶段二:条件动作序列生成
以关键帧为条件,生成完整连续动作序列。其中方向序列由生成模型学习;位置序列则先进行初始化,随后进行后优化。
后优化与运动一致性
- 针对直接生成位置序列易出现漂移的问题,引入 抓取启发式 与 逆运动学约束,对位置轨迹进行优化,确保夹爪姿态与物体几何及机器人运动学一致。
- 方向保持学习所得,不做额外优化,以保留复杂空间旋转语义。
输出
输出为可直接执行的夹爪运动序列(位置 + 方向),支持物体翻转、旋转等复杂空间操作。
与同类方法的差异点:现有工作多采用端到端回归完整夹爪姿态序列,在长时程复杂轨迹下误差累积严重;本方法通过“关键帧预测 + 条件生成 + 运动学后优化”的分解策略,显著提升空间操作的稳定性与精度。
实验
实验设计
CosmoH2G 数据集包含 6,189 个演示片段、1,254 个物体,通过手持夹爪采集手-夹爪配对动作,强调复杂空间运动(旋转、翻转)。实验在仿真与真实机器人两个环境验证,评估指标涵盖轨迹相似度、成功率与目标姿态放置精度(具体数值见原论文)。
关键发现
- 两阶段框架优于单阶段端到端生成:先预测稀疏关键帧降低映射难度,再生成连续动作序列。
- 后优化策略有效:保持夹爪方向学习结果,仅基于抓取启发式与运动学一致性优化平移,可缓解轨迹累积漂移。
- 在复杂空间操作上,方法实现稳定且精确的手到夹爪迁移,显著超过传统 baseline(如直接模仿、单阶段回归等)。
与基线对比解读
传统方法通常局限于平面任务,难以应对旋转/翻转等三维运动。本文观察到端到端生成完整位姿序列在小误差累积下会快速发散,因此引入两阶段与后优化。与直接使用手持夹爪采集的数据驱动方法相比,CosmoH2G 强调高复杂度动作的覆盖,并通过关键帧约束与运动学一致性来提升执行可靠性。对工程而言,该框架可降低对精确动作捕捉的依赖,利用低成本单目视频演示,提升机器人操作泛化能力。
行业影响
落地场景
- 电商仓储自动化:处理易碎或形状不规则物品的抓取、翻转、装箱等复杂动作,从人类操作视频直接生成机器人夹爪轨迹,减少手工编程。
- 家用服务机器人:通过模仿人类日常整理(如叠衣服、翻转容器)学习复杂空间运动,提高任务泛化能力。
- 精密制造与装配:涉及非平面旋转、插入等动作的装配线,降低示教成本。
商业价值
- 降本:人类手部演示视频易获取,替代遥操作或专家编程,显著降低数据采集与技能开发成本。
- 增收:机器人能处理更多复杂操作任务,扩大自动化覆盖范围,提升产线柔性和吞吐量。
- 体验提升:服务机器人动作更自然、成功率更高,用户接受度上升。
跟现有产品/工作流的接口
- 前端可对接手部姿态估计模块(如 MediaPipe、FrankMocap),输入单目 RGB 视频,输出手部关键点序列。
- 中间层使用 CosmoH2G 的两阶段框架,生成稀疏关键帧后再预测连续动作序列,可直接嵌入现有模仿学习栈(如 Diffusion Policy、ACT)。
- 后端驱动运动规划器或抓取检测器(如 AnyGrasp),利用抓取启发式和运动学一致性优化平移,降低漂移。集成成本低,适合已有 Robot Learning 基础设施的团队。
局限
- **数据采集范式引入配准偏差**:采用手持夹爪采集演示虽然简化了动作模仿,但手持设备的运动学特性与真实机器人末端夹爪存在差异(如质量分布、阻尼、人手抖动等),后续依赖 3D 配准和对齐,可能引入系统性偏差。与直接遥操作或动捕数据相比,这种偏差在精细操作或接触密集任务中可能被放大,影响策略迁移的准确性。工程上需额外设计校准流程,增加了部署复杂度。
- **对前置手部姿态估计的依赖较强**:方法以单目 RGB 手部姿态估计为输入,在遮挡、快速运动或手-物交互频繁的场景下,估计误差会传递到关键帧预测和后续序列生成,导致动作偏差。与端到端 visuomotor 策略相比,该框架引入了额外的感知模块,其鲁棒性成为整体系统瓶颈。实际应用中需要冗余感知或滤波手段,否则难以应对真实环境的视觉噪声。
- **泛化边界尚不清晰**:数据集覆盖 1,254 个物体与 6,189 条轨迹,但动作类别和场景多样性有限,实验主要在受控仿真和少量真实机器人场景中验证。对于长时程任务、多物体交互或未见物体的大范围位姿变化,性能可能下降。此外,两阶段框架中第一阶段关键点预测错误会传播到第二阶段,虽然后优化可缓解,但无法完全纠正根本性错误。与大规模预训练策略相比,该方法的泛化能力仍需更多跨环境和跨任务测试支撑。