利用 CLIP 与 DINO:一种不确定性感知的级联融合网络用于可泛化的深度伪造图像检测
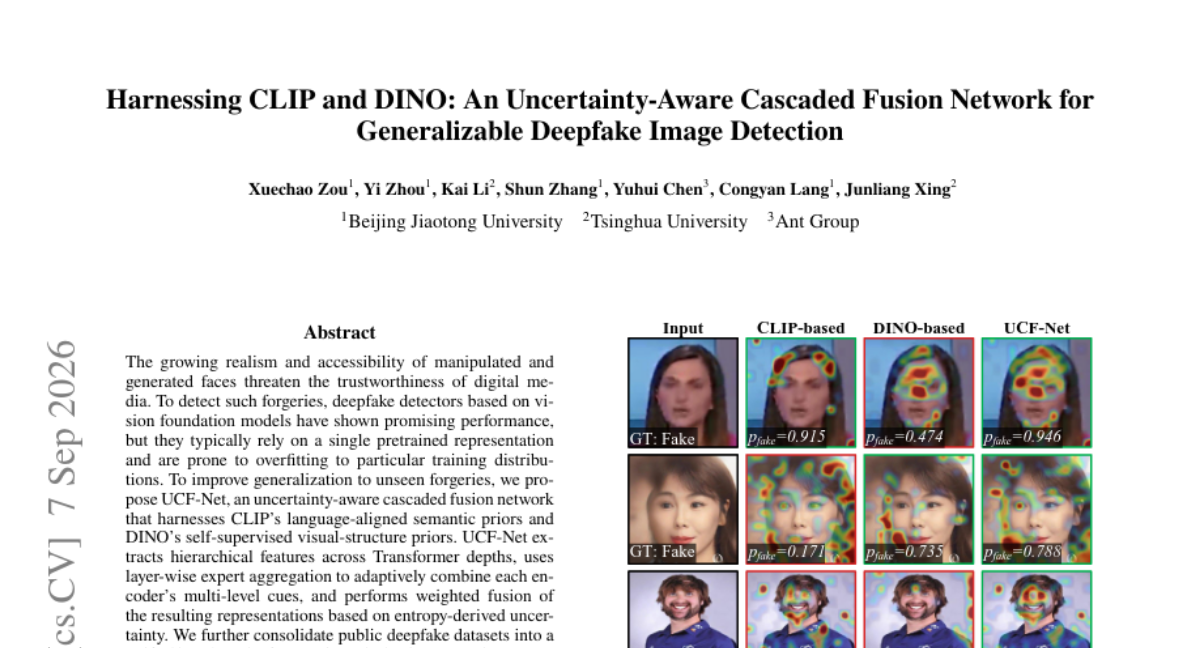
生成人脸的真实感与易得性不断上升,威胁着数字媒体的可信度。基于视觉基础模型的深度伪造检测器虽表现良好,但通常依赖单一预训练表征,且易对特定训练分布过拟合。 为提升对未知伪造样本的泛化能力,本文提出 UCF-Net,一种不确定性感知的级联融合网络,同时利用 CLIP 的语言对齐语义先验与 DINO 的自监督视觉结构先验。UCF-Net 提取跨 Transformer 层级的层次化特征,通过逐层专家聚合自适应地组合各编码器的多级线索,并基于熵衍生的不确定性对所得表征进行加权融合。 实验方面,作者将公共深度伪造数据集整合为约 4M 图像的统一基准,并构建了包含来自 8 个近期生成器的超 8K 人脸图像的独立跨生成器评估集。在统一基准上,UCF-Net 在域内与跨域评估中均取得最佳平均 AUC;在跨生成器集合上,模型能以有限的目标准域数据有效适应,但零样本迁移仍具挑战。
论文精读
TL;DR UCF-Net 融合 CLIP 语言对齐语义与 DINO 自监督视觉结构,通过层级专家聚合与不确定性加权,显著提升深度伪造检测的跨生成器泛化能力。
问题
问题背景
Deepfake 检测正在从单一模型特征转向视觉基础模型(CLIP、DINO)的表示利用,核心目标是提升跨生成器、跨数据集的泛化能力。
现有方法局限
- 多数检测器只依赖单一预训练表示,难以同时捕捉语义先验和视觉结构先验,容易过拟合训练分布。
- 特征提取通常只取最后一层或简单拼接,忽略 Transformer 不同深度的层次线索,导致对局部伪造痕迹不敏感。
- 与近期多模型集成方法相比,缺乏对特征可靠性的显式建模,不同模型输出冲突时误判风险高。
- 训练数据多按数据集孤立划分,模型在未见生成器上 AUC 明显下降。
为什么这个问题难/重要
- 伪造生成器快速演进,新架构(如扩散模型人脸生成)不断出现,训练与测试分布偏移大。
- 不同伪造方式在特征空间中痕迹重叠,单一模型可能高置信度出错,需要不确定性估计来动态调节融合权重。
- 实际部署要求检测器能用少量目标域数据快速适应,而零样本迁移仍困难,直接影响内容审核、身份认证等系统的可靠性。
作者构建的统一 benchmark 与 cross-generator set 表明:跨域泛化仍是当前检测器的核心瓶颈。
类似自动驾驶多传感器融合中,视觉与激光雷达信号互补且需不确定性加权,单一传感器难以应对所有天气和路况。
核心洞察
- 核心洞察:融合 CLIP 的语言对齐语义先验与 DINO 的自监督视觉结构先验,比单一基础模型更能泛化到未知伪造。以往工作通常仅选用一种预训练表示,导致对特定训练分布过拟合;UCF-Net 同时利用两者互补性质,捕捉语义不一致与局部结构异常,提升跨生成器检测鲁棒性。
- 核心洞察:层级专家聚合与不确定性加权融合是提升跨域性能的关键设计。传统方法常固定使用 Transformer 某一深度的特征或简单拼接多模态特征,忽略了不同层特征贡献差异和模态可靠性。UCF-Net 的 layer-wise expert aggregation 自适应选择各编码器多层线索,并用基于熵的不确定性加权融合,抑制不可靠表示,与直接融合方式形成明确对比。
- 核心洞察:在大规模统一基准与跨生成器评测集上,零样本迁移仍是主要瓶颈。论文整合约 4M 图像训练并构建 8K 跨生成器评测集,发现尽管有监督微调后适应良好,但零样本迁移表现有限,为社区提供了更严格的评估协议与改进方向。
方法
输入人脸图像后,UCF-Net 首先通过 CLIP 和 DINO 两个冻结的 Vision Transformer 提取多层特征。CLIP 提供语言对齐的语义先验,DINO 提供自监督的视觉结构先验。为利用跨 Transformer 深度的层次信息,模型从每个编码器的不同层收集特征图。
逐层专家聚合 将每个编码器的各层特征视为独立专家,通过可学习的门控权重或注意力机制,自适应地融合多级线索,生成该编码器的单一表示。此设计能捕捉从低级纹理到高级语义的伪造痕迹。
随后,不确定性感知特征融合 计算两个编码器表示的熵派生不确定性(例如分类 logits 的熵),并将其作为融合权重。不确定性低的表示获得更高权重,从而在决策时侧重更可靠的分支。融合后的表示输入二分类头,输出真实/伪造概率。
工程启示:该方法无需联合微调两个大模型,可通过 LoRA 等参数高效微调适配下游任务,降低过拟合风险。与简单拼接或平均池化多模型特征的方法不同,UCF-Net 通过层级聚合和不确定性加权,显式建模不同模型在不同样本上的可靠性,从而提升跨生成器泛化能力。
实验
实验设计
- 统一基准: 整合多个公开 deepfake 数据集为约 4M 图像 的基准,包含 in-domain 与 cross-domain 划分。
- 跨生成器评估集: 额外构造 8K+ 人脸图像,覆盖 8 个近期生成器,考察对未知伪造的泛化能力。
- 评估指标: 使用 mean AUC 作为主要指标,报告 in-domain、cross-domain 与 cross-generator 三类结果。
关键发现
- 在统一基准上,UCF-Net 取得所有对比方法中 最佳 mean AUC,且 in-domain 与 cross-domain 均领先,证明 CLIP 语义先验 + DINO 结构先验 的融合有效提升分布外性能。
- 在 cross-generator 集上,少量目标域微调 即可带来明显提升,但 zero-shot 迁移仍具挑战,说明跨生成器泛化尚未完全解决。
- 消融实验表明: 双编码器比单编码器更有优势;层级聚合与不确定性加权融合是性能提升的关键组件。
与基线对比解读
- 以往方法通常依赖 单一视觉基础模型表示,容易过拟合训练伪造类型,跨域泛化不稳定。
- UCF-Net 通过 多层级专家聚合 + 熵不确定性融合,动态调整 CLIP 与 DINO 的贡献,缓解了单一先验的偏差,在跨域场景下保持更稳健的 AUC。
- 工程启示: 多模态基座融合可降低数据分布偏移风险;但 zero-shot 能力有限,实际部署仍建议预留少量目标域数据做快速适配。
行业影响
落地场景
UCF-Net 适合 内容审核平台、远程身份认证、新闻事实核查 等需对抗不断更新伪造手法的场景。视频平台可在上传链路中检测换脸/生成人脸;金融服务可在 eKYC 人脸比对前过滤合成人脸。
商业价值
主要价值来自 降低人工审核成本 与 减少漏检导致的合规/信任损失。跨生成器泛化强可减少频繁采集新伪造样本与重训开销;不确定性输出可让低置信样本优先人工复核,提升人机协作效率。对反欺诈/内容认证 API 厂商,可按调用量变现。
与现有产品/工作流接口
封装为 同步/异步检测 API,输入人脸帧,输出 p(fake) 与熵派生不确定性分数,接入现有审核 pipeline。项目提供 GitHub 与预训练权重,支持 LoRA 轻量适配垂直域。CLIP + DINO 双编码器可部署于 GPU 服务或边缘节点,串联现有人脸检测模块。
具体落地用例
- 视频分享平台:对上传视频逐秒抽帧,用 UCF-Net 检测生成人脸;低不确定性且高伪造概率自动拦截,高不确定性转人工复核。
- 远程开户 KYC:在活体检测前增加 deepfake 图像过滤,阻止合成人脸绕过身份验证。
零样本跨生成器仍具挑战,生产环境建议结合少量目标域数据微调 LoRA,并用不确定性分数设置阈值,避免误杀。
局限
- - **Zero-shot 跨生成器泛化仍有限**。论文在摘要中明确承认 `zero-shot transfer remains challenging`,在 cross-generator set 上,当没有目标域数据时,UCF-Net 对来自未见生成器的伪造图像检测能力不足。这表明所利用的 CLIP 语义先验和 DINO 结构先验仍不能完全消除伪造生成器之间的分布偏移,实际部署中若不给少量新生成器样本微调,性能可能显著下降。这与完全通用的 deepfake 检测目标仍有差距。
- - **计算与训练开销较高**。UCF-Net 同时加载 CLIP 和 DINO 两个大型 ViT 编码器,并在多个 Transformer 层提取层级特征,再通过 layer-wise expert aggregation 和不确定性融合,推理时需多次前向传播并维护额外专家模块,内存和 FLOPs 明显高于单编码器方法。虽然论文包含参数与效率分析章节,但从方法设计看,4M 训练图像和双骨干的联合训练对数据、算力要求高,不利于资源受限场景或实时检测系统,工程落地成本需要权衡。
- - **融合机制的增益可能依赖特定数据分布**。与现有基于单一 foundation model 或简单特征拼接的 deepfake 检测器相比,UCF-Net 的 uncertainty-aware cascaded fusion 提升在统一基准上显著,但其设计高度依赖大规模多源数据整合,且摘要中 cross-domain 提升幅度未给出细节。如果评估数据分布与训练集不同,层级专家聚合可能过拟合到训练集中的伪影模式,导致跨域优势缩小。缺少更细粒度的消融(如不同生成器单独性能方差)也限制了对其稳健性的全面判断。