RelightFormer: 面向多视图物体重光照的前馈生成式 Transformer
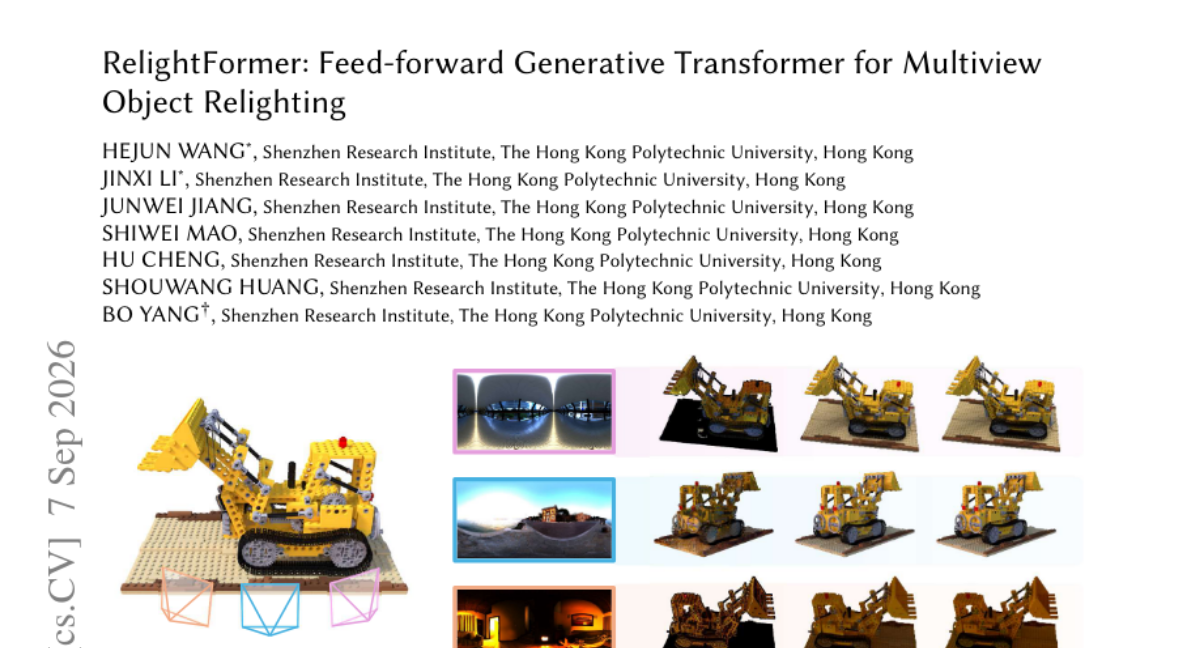
图像重光照通常依赖复杂的逆渲染 流程,面临病态优化难题;或采用单图像生成模型,却忽略了理解 3D 几何与材质交互所必需的多视图线索。 为突破这些限制,我们提出 RelightFormer:一种前馈生成式 Transformer,可直接完成单视图与多视图图像重光照,完全绕过显式本征属性估计。该架构改编自视频基础模型,核心是潜在光照模块,通过 cross-attention 将目标环境图动态注入空间特征;同时采用置换不变位置编码,对称处理无序的多视图输入,避免顺序偏置。 为训练这一稳健的数据驱动模型,我们构建了大规模 Laval Objaverse Dataset (LOD),包含 9 万个物体与 3.9 万种独特光照。大量实验表明,该方法在单视图、多视图及新视角重光照任务上均达到最先进 的视觉质量与照片级真实 的重光照效果,并具备强大的零样本泛化 能力。
论文精读
TL;DR RelightFormer 是一种前馈生成式 Transformer,跳过逆渲染直接重光照单/多视图物体,通过跨注意力注入光照并处理无序视图,在大型合成数据上训练实现高保真与零样本泛化。
问题
问题背景:图像重光照(image relighting)处于计算机视觉与图形学交叉前沿,旨在根据对象多视角图像和目标环境光照生成逼真重光照图像,是三维内容生成、增强现实与虚拟制片的共性基础,业界对高效数据驱动方案的需求持续上升。
现有方法局限:传统逆渲染(inverse rendering)管线需显式估计几何、材质与光照,该过程属严重欠定优化,对输入噪声敏感且误差在多步骤间累积,难以稳定泛化。单图生成模型虽绕过显式估计,但只利用单视角信息,无法完整理解三维形状与材质空间分布,导致多视角间阴影、反射不一致,尤其在遮挡区域或非朗伯材质上产生不真实效果。这些方法在未见光照或视角组合下泛化能力有限,与本工作形成明显差异:本工作采用前馈生成 Transformer 直接从多视角图像合成目标光照结果,完全避免显式本征属性估计。
为什么这个问题难/重要:重光照要求同时对三维几何、表面 BRDF 与全局光照传输进行隐式建模,这些因素高度耦合且观测输入有限。多视角输入带来无序集合处理问题,模型需对视角排列不变,同时保持跨视角几何一致性。训练数据方面,真实成对数据难以采集,大规模多样化合成数据构建成本高。工程启示在于:架构设计必须内建光照注入模块与排列不变编码,而非依赖数据隐式学习,这直接关系到模型是否具备零样本泛化到新物体、新光照的能力。业界关注其能否替代传统渲染管线以加速数字内容生产。
行业类比:类似文本到视频生成中保持角色外观与光照跨帧一致,多视角重光照的核心难点是统一不同视角下的几何与材质信息,这与自动驾驶多传感器融合中跨视角对齐需求有共通之处,提示可借鉴排列不变编码等跨领域技术。
核心洞察
- 将重照明问题重构为多视角条件生成,而非显式逆渲染或单图生成。RelightFormer 直接从无序多视角图像和目标环境图映射到重照明图像,绕过几何与材质估计。这与传统逆渲染(优化病态、耗时)及单图生成模型(忽略多视角几何线索)形成根本差异。模型基于视频基础模型架构,但引入置换不变位置编码消除顺序依赖,使多视角输入可任意排列而不损失一致性,更适合真实采集场景中视角无序的情况。
- 潜在光照模块通过交叉注意力将环境图作为动态条件注入空间特征,而非仅作为全局嵌入或拼接。该模块在潜在扩散 Transformer 的特征层级使用目标环境图的特征参与交叉注意力,使光照信息能针对每个空间位置调制特征,从而准确还原高光位置、阴影软硬度等材质相关光照交互。相比于将光照编码为全局向量或显式估计光源,此设计更灵活,能适应复杂环境图,并促进零样本泛化到未见光照。
- 大规模合成数据集 LOD 使前馈生成模型学习到光照-材质交互的通用先验,支撑强零样本泛化。LOD 包含 90K 个物体和 39K 种唯一光照,远超以往重照明数据集规模,覆盖多样几何与材质。在这样数据上训练,RelightFormer 无需微调即可处理真实图像、新视角和新光照,证明数据驱动的前馈生成方案在重照明任务上具有可扩展性和实用性,为后续研究提供了数据基础。
方法
整体架构与输入
RelightFormer 是一种前馈生成式 Transformer,基于视频基础模型改编,采用 Latent Diffusion Transformer 架构。输入由两部分组成:单视图或多视图的物体图像(无特定顺序)以及目标光照表示(环境贴图)。模型直接在隐空间执行重照明,避免显式估计反照率、法线或 BRDF 等中间属性。
关键模块
- Latent Illumination Module:该模块通过 cross-attention 将目标环境贴图动态注入到空间特征中。环境贴图编码为条件 token,与图像特征进行交叉注意力计算,使光照信息在特征层面融合,而非简单拼接或全局调制。
- Permutation-Invariant Multi-view Encoding:对于多视图输入,模型采用 排列不变的 positional encodings,确保输入视图的先后顺序不影响结果。这避免了传统序列模型对输入顺序的依赖,使模型能对称地利用所有视图的几何与材质线索。
- 训练数据与优化:模型在大规模合成数据集 Laval Objaverse Dataset (LOD) 上训练,包含 90K 个物体和 39K 种光照。训练目标为生成图像与真实重照明图像的感知重建损失,辅以扩散模型的去噪目标。
输出与效果
模型输出重照明后的高保真图像,支持任意目标光照。在单视图、多视图和 novel-view relighting 任务上均展现出 strong zero-shot generalization。
与同类方法的差异点:传统 inverse rendering 依赖病态优化和显式内在属性估计,单图像生成模型忽略多视图几何线索;本方法以纯前馈方式绕过内在属性估计,同时利用多视图输入的光度一致性,实现更鲁棒的重照明。
实验
实验设计叙述
- 论文在 Laval Objaverse Dataset (LOD) 上训练,该数据集包含 90K 个物体和 39K 种独特光照环境贴图。
- 实验覆盖单视图、多视图、新视角重光照,以及真实世界泛化与材质消融。
- 评估采用视觉质量与重光照真实感指标,并与 SOTA 基线对比。
关键发现
- RelightFormer 在前馈生成式 Transformer 框架下,通过 latent illumination module 和 permutation-invariant positional encodings 实现高质量重光照。
- 单视图与多视图任务均达到 SOTA 视觉质量,且零样本泛化至真实图像。
- 多视图输入可改善 3D 几何与材质交互的理解,避免单视图歧义。
与基线对比深度解读
- 相较传统反渲染管道,RelightFormer 绕过显式本征属性估计,规避病态优化问题。
- 相比单图像生成模型,多视图线索提升几何一致性,尤其在新视角重光照中更具优势。
- permutation-invariant encodings 消除顺序偏置,使模型对视角排列鲁棒。
行业影响
落地场景
RelightFormer 提供前馈式多视图重光照,适合需要快速生成物体在不同光照下真实图像的产品。典型场景包括:
- 电商商品展示:为同一 3D 商品模型自动生成多种光照环境下的渲染图,让用户交互切换光照查看材质细节,无需多组实物拍摄。
- 3D 内容与游戏资产预览:在建模工具或资产库中,输入多视图截图和目标 HDR 环境贴图,即时预览资产在不同光照下的外观,辅助美术决策。
商业价值
- 降本:替代传统多光照影棚拍摄或人工逆渲染调参,显著减少商品图制作时间和设备成本。
- 增收:高质量光照展示可提升用户对材质真实感的信任,降低退货率,提高电商转化。
- 体验提升:用户可实时调整光照,获得个性化视觉体验,增强互动性。
与现有工作流集成
模型为前馈推理,单次前向即可输出结果,适合封装为 REST API 或边缘推理服务。集成方式:
- 在 3D 资产浏览器(如 Blender 插件、Unity/Unreal 编辑器)中嵌入重光照节点,用户导入多视图截图和环境贴图,一键生成预览。
- 作为神经渲染替代,与现有光栅化/路径追踪渲染器并行:先用物理渲染器生成基础图,再用模型做光照增强或风格化。
- 在云端 AI 服务平台(如模型即服务)中部署,电商平台通过 API 调用,批量生成商品多光照图。
关键优势:无需逆向渲染或材质估计,直接端到端生成,大幅简化现有重光照管线。
局限
- - **数据与泛化局限**:模型训练依赖 **Laval Objaverse Dataset (LOD)**,虽然规模达 90K 对象、39K 独立光照,但本质仍是合成数据,材质与光照模式可能与真实世界分布存在 gap。论文虽报告了 real-world generalization 实验,但未公开大规模真实场景定量评估,跨域泛化上限不明确。此外,光照数量 39K 相对对象数量 90K 偏少,平均每个对象对应不到 0.5 种光照,可能限制光照多样性学习。
- - **方法假设与视图几何利用**:采用 **permutation-invariant positional encodings** 处理多视图输入,虽然消除顺序偏置,但也丢弃了视图间的相对位姿几何线索。当输入视图存在已知相机位姿时,该方法无法显式利用这些信息,可能影响遮挡推理与视图一致性。与显式 3D 表示(如 NeRF 或逆渲染管线)相比,黑盒生成方式缺乏几何可解释性,难以保证物理精确的材质响应。
- - **计算成本与可扩展性**:适配自 **video foundation model** 的架构可能保留较大参数量与训练开销,虽然前向推理是 feed-forward,但大规模训练需要高算力。论文未详细报道推理延迟与显存占用,实际部署到交互式应用存在不确定性。与其他单图重光照方法相比,多视图输入增加计算负担,但收益是否随视图数增长而单调提升仍需更多实验验证。