Marigold V2: 重新审视用于单目深度估计的扩散变换器
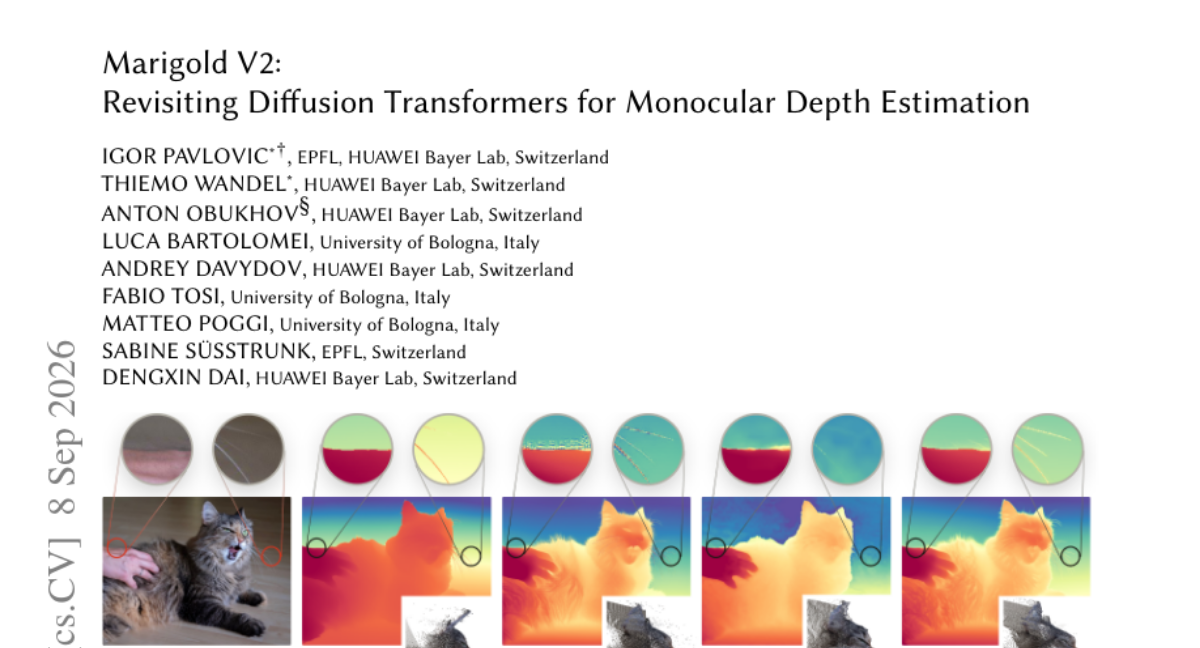
单目深度估计是一项应用广泛但高度不适定的计算机视觉任务,下游应用涵盖场景重建、计算摄影与机器人等领域。尽管该领域已较为成熟,现有模型仍难以泛化至分布外输入,且生成的深度图往往不够锐利、细节不足。本文重新审视 Marigold,这是一套将现代图像生成与编辑模型(基于 扩散变换器 DiT 架构)改造为先进单目深度估计器的技术。 我们的方案聚焦于从预训练的多步流匹配模型出发,实现单步推理,并在必要时进行量化,从而在保持模型容量的同时降低运行成本。我们分析了朴素训练产生的伪影,并提出了两项有效补救措施:一是将模型内部表示与从真值中提取的语义特征对齐,二是采用围绕新型 Sinkhorn 损失构建的两阶段微调协议。 在 KITTI 和 ETH3D 数据集上,我们的方法将 AbsRel 指标较先前最优结果提升 16%–26%,生成的深度图更清晰、更干净,且能更好地泛化至分布外场景。定性结果中,模型能够解析先前方法难以处理的毛皮、树叶和发丝级边缘。此外,Marigold V2 在表面法线估计和内在图像分解等其他密集回归任务上也取得了领先成果。
论文精读
TL;DR Marigold V2 将扩散 Transformer 重构为单目深度估计器,通过单步流匹配、语义对齐与 Sinkhorn 两阶段微调,输出更锐利且泛化强的深度图,并在表面法线等任务上达 SOTA。
问题
问题背景
单目深度估计是场景重建、计算摄影与机器人导航的基础任务,当前社区高度关注模型在分布外数据 上的泛化能力与输出高频细节 的保真度。
现有方法局限
传统判别式模型(如 DPT、MiDaS)依赖大规模标注数据,在域外场景预测易退化,且输出深度图常过度平滑。基于扩散先验的方法(如 Marigold、Lotus)虽显著提升泛化,但多步采样推理慢,且对毛发、树叶等细粒度结构易产生模糊或伪影。近期单步蒸馏工作(Pixel-Perfect Depth、InfiniDepth)提速明显,却牺牲了边缘锐度或几何一致性。根本原因在于:训练时缺乏对模型内部表征与真实语义特征的对齐约束,且常用回归损失(如 MSE、Scale-Invariant Loss)对高频误差惩罚不足,导致模型倾向于输出“安全”的平均深度。
为什么这个问题难 / 重要
单目深度估计是典型病态问题:单一 2D 图像对应无限多 3D 场景,缺乏多视图几何约束。真实世界光照、材质与遮挡复杂,标注成本高昂且噪声大,导致域外泛化困难。下游应用(AR/VR 遮挡处理、自动驾驶障碍物检测、3D 重建)对深度图的精度 与分辨率 要求极高,且需要实时推理。因此,如何在保持单步推理效率的同时,实现与多步扩散模型相当的细节与泛化,是该领域核心工程挑战。
行业类比
类似图像超分辨率从 CNN 回归转向扩散生成以获得逼真纹理,单目深度估计正经历从纯判别式到生成式先验的迁移,以解决细节缺失与域外退化问题。
核心洞察
- 单步流匹配推理结合预训练 DiT 的生成先验,实现了低成本、高泛化的稠密回归。与之前 Marigold 依赖多步扩散去噪、推理成本高不同,Marigold V2 通过 flow-matching 公式直接从预训练 DiT 做单步预测,并借助 VAE 解码器上采样,避免了 task-specific decoder 带来的额外参数和过拟合。同时融合量化手段,在单张 32GB GPU 上不到一周完成微调,显著降低了计算门槛,且保持了对 out-of-distribution 图像的泛化能力,在 KITTI 和 ETH3D 上提升 16-26% AbsRel。这为利用大型生成模型做稠密回归提供了实用的工程范式。
- 表示对齐与 Sinkhorn 损失的两阶段微调,针对生成先验的伪影和几何模糊提供了系统性解法。朴素训练 DiT 做深度回归容易产生“边缘模糊”和“内部表示与语义不一致”的伪影。Marigold V2 引入 iREPA(内部表示对齐)把模型特征拉向 ground-truth 提取的语义特征,而 Sinkhorn loss 在第二阶段进行全局分布匹配,优化深度排序和轮廓清晰度。这种组合不仅保持像素级精度,还显著提升毛发、枝叶等细薄结构的边缘保持。与仅依赖 L1/L2 或对抗损失的判别式方法相比,它从表示和分布两个层面修正生成模型回归偏差,并且该两阶段微调方案可迁移至表面法线估计、本征图像分解等任务。
方法
输入与整体流程
输入单张 RGB 图像,经 深度归一化 预处理映射到适配模型数值范围。核心是利用预训练 DiT 图像编辑模型(Qwen-Image-Edit),将其从多步 flow-matching 生成模型改造为单步推理的深度估计器。
关键模块
- 单步 flow-matching 推理:从预训练多步 flow-matching 模型微调为单步前向,必要时引入 量化 降低显存开销,同时保留模型容量。
- 语义特征正则化 iREPA:对齐模型内部表示与 ground-truth 深度图提取的语义特征,抑制 naive 训练产生的伪影。
- 两阶段微调协议:第二阶段采用基于 Sinkhorn 的损失(
SinkLoss),优化深度图的细节与几何一致性。
输出与工程启示
输出稠密深度图,保持 VAE 模型的高效推理。相比先前 Marigold 及 DiT 变体,在 KITTI 和 ETH3D 上 AbsRel 提升 16-26%,显著改善毛发、树叶、发丝级边缘。差异点:用 Sinkhorn 损失与表示对齐替代传统 L1/L2 监督,在单步推理下实现更锐利、泛化更强的深度估计,且可迁移至表面法线、内禀分解等密集回归任务。
实验
实验设计
作者在 KITTI 和 ETH3D 上进行零样本仿射不变深度估计评测,并与先前最佳方法(含 Pixel-Perfect Depth、InfiniDepth)对比。此外,还测试了 表面法线估计、本征图像分解 等密集回归任务,验证方法迁移性。训练采用 Qwen-Image-Edit 作为初始化,单卡 32GB GPU 内一周完成两阶段微调。
关键发现
Marigold V2 在 KITTI 和 ETH3D 上 AbsRel 较之前最佳提升 16-26%,且边界感知指标显著改善。定性结果展示毛发、树叶、极细边缘清晰锐利,而 PPD 与 InfiniDepth 常出现模糊或丢失。核心贡献为 语义特征正则化(iREPA)与 两阶段 Sinkhorn 损失,有效抑制朴素训练中的伪影。模型还保持了 VAE 推理效率,适用于 表面法线、反照率 等任务。
与基线对比
不同于先前依赖多步扩散采样的生成式深度估计方法,Marigold V2 直接从预训练 流匹配 模型做单步推理,无需额外精细化网络。相比之下,PPD 侧重细节但几何一致性不足,InfiniDepth 虽泛化强但高频细节差。iREPA 对齐语义特征与真值,Sinkhorn 损失在第二阶段精细几何,二者协同带来锐利且鲁棒的深度图。
行业影响
落地场景:单目深度估计 可应用于增强现实(AR)、移动端人像模式、自动驾驶与机器人感知、3D场景重建、电商商品展示、内容平台视频特效等。Marigold V2 的单步推理与量化特性使其适合端侧部署,无需专用深度传感器。
商业价值:降本体现在用单目RGB替代昂贵LiDAR或深度相机,减少硬件与数据采集成本;开源扩散Transformer微调成本低(单卡 < 1 周),降低研发投入;单步推理降低云端算力消耗。体验提升在于深度图边缘更清晰,改善AR遮挡、人像分割、3D建模质量,增强用户沉浸感与产品竞争力。
接口:Marigold V2 可作为即插即用模块嵌入现有CV pipeline。其VAE 架构与扩散模型天然兼容,可对接图像生成/编辑流程;提供预训练权重与微调脚本,支持自定义数据适配;支持ONNX/TensorRT量化,便于集成到移动端或边缘计算框架;损失函数组件可复用至其他密集回归任务。
具体用例:电商平台使用 Marigold V2 为商品图片实时生成深度图,驱动3D展示与虚拟试穿,提升转化率;自动驾驶公司将其作为单目深度感知模块,作为LiDAR的低成本冗余,加速L2/L3功能落地。
局限
- **依赖大规模预训练扩散模型**:方法基于 **Qwen-Image-Edit** 这类图像编辑 DiT 模型,尽管单步推理降低了计算量,但模型本身参数量大,量化后性能可能下降。论文仅提及“在需要时量化”,未系统评估低比特量化对细节保留和精度的影响,因此实际部署到资源受限设备(如移动端、嵌入式)仍有挑战。
- **训练流程复杂度较高**:**iREPA** 语义特征正则化需要额外的语义特征提取器,增加了训练阶段的依赖和计算开销。该特征源的选择(例如 CLIP 或其他 backbone)对最终深度质量的影响未被消融验证,可能成为复现或迁移到新域时的潜在障碍。
- **评估范围有限**:实验主要在 **KITTI**、**ETH3D** 等常用基准上做零样本测试,缺乏对极端场景(如低光照、恶劣天气、透明/反射表面)的系统性评测。此外,扩展到其他密集回归任务(表面法线、反照率)时可能需要任务特定的微调策略,并非完全即插即用,其泛化边界尚不明确。