Iris: 攀登搜索前沿
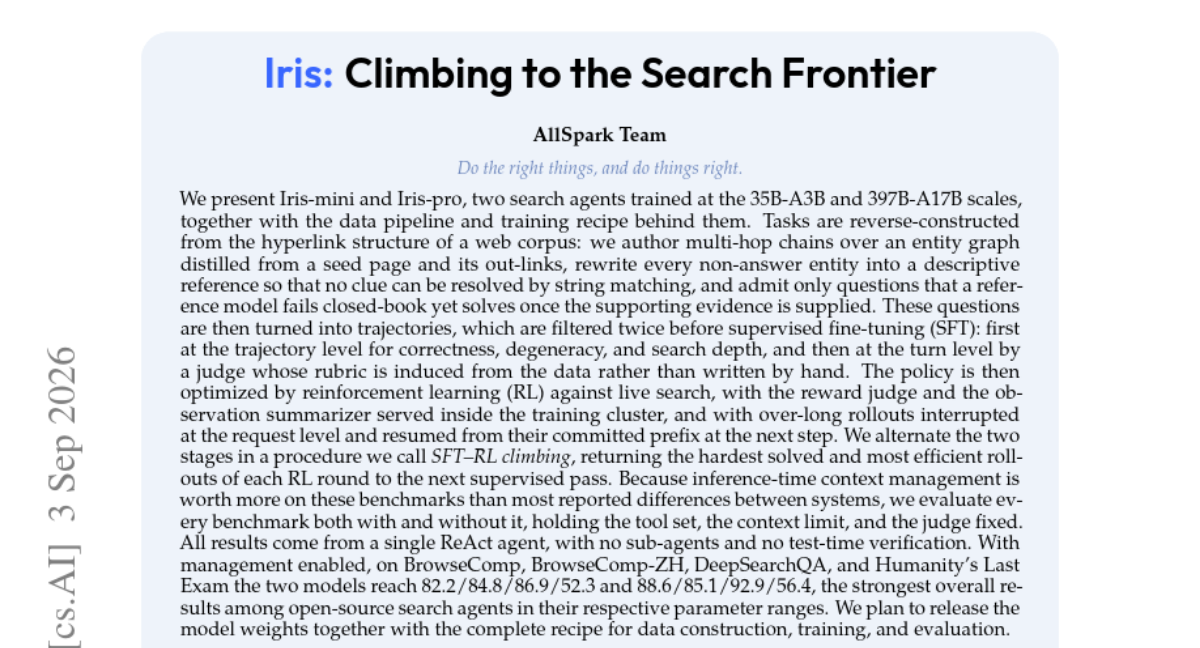
我们提出 Iris-mini 和 Iris-pro,两个搜索智能体,训练规模分别为 35B-A3B 与 397B-A17B,并完整公开其数据流水线与训练方案。 任务构造:从网页语料的超链接结构反向构建任务——在由种子页面及其外链提炼的实体图上编写多跳链接链,将所有非答案实体改写为描述性指代,使线索无法通过字符串匹配解决;只有参考模型在封闭式下失败、但提供支持证据后能解出的问题才被保留。这些问答对被转化为轨迹,并在 SFT 前经轨迹级与回合级双重过滤。此后,策略通过 强化学习 对实时搜索进行优化:奖励评判器与观测摘要器运行在训练集群内部,超长 rollout 在请求层中断,并在下一步从其已提交前缀恢复。我们交替进行两个阶段,称之为 SFT-RL 攀登,将每轮 RL 中最难解决且最高效的 rollout 回传给下一轮监督学习。 评测:由于推理期上下文管理在这些基准上的收益超过多数系统间报告差异,我们在开启与关闭该机制两种条件下评估每个基准,并固定工具集、上下文长度与评判器。所有结果均来自单个 ReAct 智能体,无子智能体,亦无测试期验证。开启上下文管理后,在 BrowseComp / BrowseComp-ZH / DeepSearchQA / HLE 上,两个模型分别达到 82.2/84.8/86.9/52.3 与 88.6/85.1/92.9/56.4,在各自参数范围内均为开源搜索智能体的最强综合表现。 我们计划公开模型权重,以及数据构建、训练与评估的完整配方。
论文精读
TL;DR Iris 从网页超链接结构反向构建难倒闭卷模型的多跳搜索问题,经轨迹双重过滤后 SFT 与 RL 交替训练,在 BrowseComp 等基准上取得开源搜索代理 SOTA,并揭示推理时上下文管理的关键作用。
问题
问题背景
当前搜索智能体领域关注通过多跳推理解决开放域复杂问答(如 BrowseComp、DeepSearchQA),模型需自主调用搜索工具、浏览网页并综合证据。
现有方法局限
- 数据构造:依赖模板或人工标注,生成的多跳问题常存在字符串匹配漏洞(实体名称可直接命中答案),导致模型跳过真实检索;反向构造虽有探索,但未能系统性地从超链接图蒸馏实体关系。
- 训练流程:SFT 与 RL 往往割裂,RL 独立运行,难以持续利用 RL 中发现的困难且高效轨迹;轨迹过滤只做整体级别,忽略回合级别质量。
- 评估:多数工作未控制推理时上下文管理(context management),导致基准对比不公平;基准分数混杂了上下文截断策略的差异。
为什么这个问题难/重要
- 数据难度控制:需保证问题在闭卷下失败、提供证据后可解,且线索不可由字符串匹配解析,对合成 pipeline 要求高。
- RL 与实时搜索结合:训练时需在集群内部署奖励裁判和观察摘要器,处理超长 rollout 并支持前缀复用,工程复杂度高。
- 公平评估:上下文管理常被低估,但论文显示其价值超过系统差异,若不对齐工具、上下文限制和裁判,结果不可比。业界关注度高因搜索智能体是通向通用工具使用智能体的关键路径。
行业类比
类似自动驾驶中传感器融合与决策规划需在仿真和实车间闭环迭代,搜索智能体也需要数据合成与实时检索的闭环训练才能稳步提升。
核心洞察
- 通过从网页超链接结构提取实体图并逆向构造多跳问题,Iris 的数据管道实现了难度可控且无法字符串匹配的训练样本生成。该方法将非答案实体改写为描述性引用,并用参考模型闭卷失败但开卷成功的双重验证过滤,确保每个问题都需要真实多步搜索推理。这区别于依赖人工标注或简单模板的做法,能够从海量网络语料中自动挖掘高质量搜索代理训练数据,极大降低了获取复杂推理轨迹的成本。
- SFT–RL climbing 循环将监督微调与强化学习交替进行,每轮 RL 后将最高难度且最高效的 rollout 返回给下一轮 SFT,实现模型能力的阶梯式上升。与单纯 SFT 或独立 RL 相比,这种交替机制让 SFT 提供稳定基础,RL 探索新难度边界,再将探索成果蒸馏回 SFT,既避免了灾难性遗忘,又持续扩展可解决的搜索深度,形成自我驱动的课程学习,是训练搜索代理的高效范式。
- 论文明确指出推理时上下文管理对基准分数的影响超过多数系统间差异,并主张评估时固定工具集、上下文限制和评判器,分别报告有无上下文管理的结果。这一观点挑战了仅关注模型参数或训练算法的评估惯例,提醒部署者上下文压缩、状态修剪等工程优化可能比模型升级带来更高性价比的性能提升,同时为搜索代理提供了更严谨的基准对比协议。
方法
输入构造
从 web 语料超链接结构反向构建任务:先从种子页面蒸馏出实体图,在图上生成多跳链;将链上所有非答案实体改写为描述性引用,使线索无法通过字符串匹配直接命中。只有满足双重标准的问题才保留:参考模型闭卷失败,但提供支持证据后能正确回答。
关键训练模块
- SFT 阶段
将问题转为轨迹,先做轨迹级过滤(正确性、退化、搜索深度),再做回合级过滤,由从数据中诱导出的 judge 打分,不使用手写规则。 - RL 阶段
与 live search 交互,集群内部署 reward judge 与 observation summarizer;超长 rollout 在请求级中断,下一步从先前 committed prefix 恢复,避免丢弃已探索路径。 - SFT–RL climbing
交替执行 SFT 与 RL,每轮 RL 后返回最难解决且最高效的 rollouts 到下一轮 SFT,形成训练数据质量爬坡。
输出
最终得到 Iris-mini 与 Iris-pro 两个单一 ReAct agent,无子代理、无测试时验证;支持推理时上下文管理,显著影响最终评测分数。
与同类工作不同,该方法强调从超链接结构逆向构造多跳问题,并用 SFT–RL 交替“攀爬”持续提升数据难度与效率,而非仅依赖固定合成模板或单独 RL 微调。
实验
实验设计
- 评估基准:BrowseComp、BrowseComp-ZH、DeepSearchQA、HLE
- 两个模型:Iris-mini (35B-A3B) 和 Iris-pro (397B-A17B)
- 推理设置:单一
ReAct代理,无子代理,无测试时验证 - 关键控制变量:对所有基准分别测试启用 / 禁用 context management,固定工具集、上下文长度和评判器
关键发现
- 启用 context management 后,Iris-mini / Iris-pro 在 BrowseComp 上达到
82.2 / 88.6,在 BrowseComp-ZH 上84.8 / 85.1,在 DeepSearchQA 上86.9 / 92.9,在 HLE 上52.3 / 56.4 - 作者强调 context management 的收益超过许多系统间报道的差异,凸显推理时上下文调度的重要性
- 在各自参数范围内取得开源最强综合成绩
与基线对比
- 对比对象:对应参数范围的开源搜索代理
- 优势来源:数据构造中采用双重过滤与 anchor abstraction,确保问题无法靠字符串匹配解决;训练流程采用 SFT-RL climbing 迭代回灌高质量轨迹
- 严格评估协议:固定评判器和上下文限制,避免间接优化带来的虚高;不使用测试时验证或多代理,结果更具说服力
行业影响
落地场景
Iris 这类多跳搜索代理可嵌入企业知识管理、市场情报、金融尽调、学术文献调研等需要跨文档推理的场景。例如,在电商选品中,代理可自动聚合商品参数、用户评价、竞品动态,构建“某品类性价比最优且近期有降价趋势”的多跳证据链;在金融投研中,代理能串联财报、新闻、监管公告,回答“某政策对某行业供应链的影响”类复杂问题。
商业价值
核心价值在于降低人工调研时间成本与提升决策信息密度。Iris 通过 SFT–RL climbing 从真实搜索轨迹中挖掘“最难且最高效”的样本,使模型在少量参数下达到接近闭源代理的效果,从而降低部署成本。其上下文管理策略可减少无效上下文累积,直接降低 LLM token 消耗,对按量计费的搜索类产品有显著成本优化意义。
与现有产品/工作流的接口
- 可作为插件式搜索代理接入 LangChain / LlamaIndex 等 Agent 框架,替代简单 RAG 管线中的“检索+生成”模块,增强多跳查询能力。
- 其轨迹级与轮次级双过滤的 SFT 数据管线可复用,用于生成高质量工具调用训练集,提升企业自有代理的可靠性。
- 上下文管理模块可作为独立中间件,集成到已有长上下文任务(如代码库问答、长文档总结)中,优化推理效率。
具体 Use Case
- 电商选品分析:代理跨多个电商平台抓取商品信息、用户评论、价格历史,生成“某品类中评分≥4.5、价格低于均值且近7日销量上升”的推荐列表,并附证据引用。
- 医疗文献综述:代理从 PubMed、临床试验注册库等来源检索并串联多篇论文,回答“某药物在特定人群中的有效性证据链”,自动生成带引用的综述初稿。
局限
- **数据构造偏差**:任务反向构建于特定 web 语料库的超链接结构,实体图蒸馏和链式改写高度依赖该语料库的覆盖度与链接密度。对于时间敏感信息或需要实时数据库交互的任务,该方法可能无法生成有效样本。此外,anchor abstraction 要求模型不能通过字符串匹配解析线索,但实际部署环境中存在大量可字符串匹配的简单查询,训练分布与真实使用分布存在偏移,可能影响模型在通用搜索场景下的鲁棒性。
- **奖励与摘要器泛化风险**:RL 阶段的奖励判断与观察摘要器均在训练集群内部实现,其拟合质量受限于内部数据集和评估标准,与外部搜索环境的真实质量可能存在偏差。同时,推理时上下文管理在评估中作为独立变量控制,虽然展示了其重要性,但也可能掩盖模型自身在长上下文压缩、无关信息过滤等能力上的不足,使跨系统对比时难以分离上下文管理与模型能力的贡献。
- **评估范围有限**:论文仅在 BrowseComp、BrowseComp-ZH、DeepSearchQA、HLE 四个基准上报告结果,这些基准都偏向复杂多跳搜索任务,缺乏对更广泛 web 交互任务(如电商、代码检索、实时问答)的覆盖。此外,虽声称开源 SOTA,但未与闭源搜索智能体直接对比,无法充分说明模型绝对能力;且评估中固定了工具集、上下文长度和 judge,可能掩盖系统在其他配置下的表现差异。