Principia: 视频模型的关联物理测试
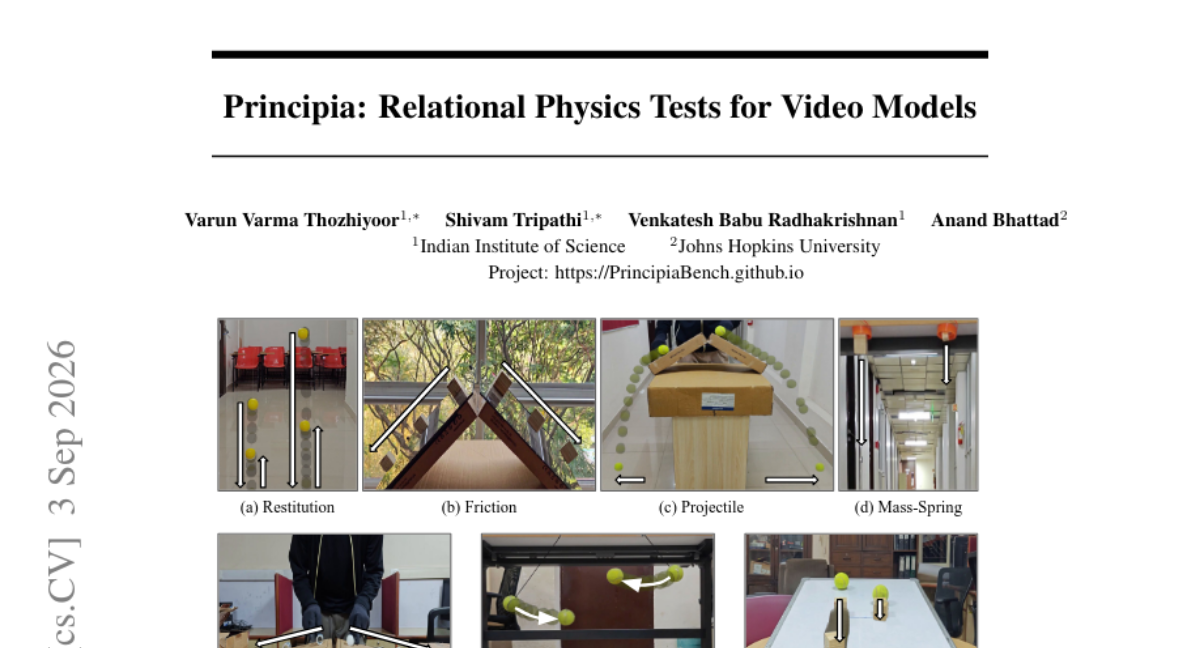
评估视频模型中的物理推理非常困难,因为绝对运动测量依赖于帧率、物体尺度和摄像机标定,而这些在生成视频中通常是模糊或不可用的。我们提出一种不同思路: 当同一场景中的两个物体遵循相同物理定律时,它们的运动必须满足可预测的关联关系,且这些关系与标定无关。 我们引入 Principia 基准,通过成对物体之间的关联一致性来评估牛顿物理。该基准涵盖八种现象——引力、恢复系数、摩擦、转动惯量、抛体运动、动量、摆和质量-弹簧振荡——覆盖平动、转动、碰撞和振荡动力学,并使用受控协议记录的真实场景。我们还提出标定无关一致性分数,直接在图像空间中量化物理违规程度。 在六个先进视频生成器的数千次生成结果中,没有任何模型在 Principia 上的得分超过 0.42,尽管它们在 VBench 上的得分均约为 0.8。此外,我们评估了视觉-语言模型检测关联物理违规的能力,最佳模型准确率仅 67%,大多数模型接近随机水平。
论文精读
TL;DR Principia 用配对物体间校准无关的关系一致性检验视频模型的牛顿物理推理;六款 SOTA 生成器最高仅 0.42,而 VBench 视觉分约 0.8,揭示“看起来好”不等于“物理对”。
问题
问题背景
视频生成模型从视觉保真走向物理合理性评估,当前领域关注如何量化模型是否真正掌握 牛顿力学规则,而非仅仅生成连贯帧序列。
现有方法局限
传统物理评估依赖 绝对运动测量,如像素轨迹、速度或加速度,通常需要已知帧率、物体尺度与相机标定。生成视频中这些参数往往缺失或不一致,导致指标偏差。另一类基于 VQA 或多模态打分的方法容易被纹理、颜色等 表面统计线索 欺骗,无法反映内在物理约束。例如 VBench 物理相关分数普遍在 0.8 左右,但同一批模型在 Principia 上仅 0.42 不到,说明常用基准严重高估物理推理能力。
为什么难/重要
物理世界的关键规律其本质是 关系性 的:同一场景中两个对象受同一物理定律支配时,其运动必须满足可预测的相对关系,且该关系独立于相机标定。然而生成视频中物体分割与跟踪噪声大、相机运动未知,直接在图像空间量化关系违反程度仍是一个开放问题。物理一致性差会直接影响视频生成在机器人仿真、自动驾驶数据合成、科学可视化等场景的可信度。
行业类比
类似于自动驾驶仿真测试中,仅评估单车轨迹与真值位置误差,无法保证多车交互符合碰撞与动量关系;需要关系级一致性检验。
核心洞察
- Principia 的核心创新是将物理评估从绝对运动测量转变为配对物体间的相对一致性检查,从而无需帧率、尺度或相机标定信息即可在图像空间直接量化物理违规。这一角度独特,因为此前物理基准依赖绝对运动轨迹且需要准确标定,生成视频中通常不可用;Principia 利用同一物理规律下两物体运动的可预测关系,提出 calibration-independent consistency score,使评估更鲁棒、更贴近真实生成场景。
- 视频生成模型的视觉质量与物理保真度存在显著脱耦:六个 SOTA 生成器在 VBench 上均约 0.8,但在 Principia 上无人超过 0.42。这一反差与现有以感知质量为主的基准形成鲜明对比,表明高分生成视频未必满足物理约束。对实际工程的启示是,面向动态场景生成或仿真应用时,不能仅依赖 VBench 类指标筛选模型,需引入专门物理一致性评估。
方法
输入为同一场景中遵循同一物理定律的成对物体视频,包括真实受控录制与模型生成视频;关键模块分三步:
- 关系设计:针对八个现象(重力、恢复系数、摩擦、转动惯量、抛体、动量、单摆、弹簧振子),定义成对物体运动量之间必须满足的校准无关关系,例如自由落体阶段两物体加速度比值恒定,碰撞后动量交换符合质量比,这些关系仅依赖图像空间中的相对位移与尺寸比。
- 受控数据采集:在真实场景按协议固定物体属性(质量、材质、初始条件),录制高帧率视频并标注关键点轨迹,形成基准真值;同时构建 Principia-Synth 反物理变体,通过修改轨迹或参数使同一关系被破坏,用于检测任务。
- 一致性评分:从视频中估计每个物体的运动量(位移、角速度、恢复系数等),计算观测关系与理论关系的偏差,归一化为 0–1 分数,1 表示完全物理一致;对生成视频无需相机标定,直接使用像素空间测量。
输出为每个视频生成模型的 inconsistency score(论文中最高不超过 0.42),以及视觉语言模型对成对关系违规的二分类准确率(最佳 67%)。与 VBench 等依赖绝对运动学指标、易受帧率与标定影响的基准不同,Principia 采用成对关系一致性实现跨相机设置的物理评估。
实验
实验设计
Principia 构建了覆盖 8 类物理现象(重力、恢复系数、摩擦、转动惯量、抛体、动量、单摆、弹簧振子)的真实场景数据集,通过成对物体的关系一致性进行评测,而非绝对运动量。评测采用校准无关的一致性分数 (calibration-independent consistency score),直接度量图像空间中的物理违例。视频生成器评估选取 6 个 SOTA 模型,对比 VBench;VLM 评估则利用 Principia-Synth 的反物理场景,要求模型判断关系物理违规。
关键发现
- 所有视频生成器在 Principia 上得分不超过 0.42,而在 VBench 上均约 0.8,表明视觉质量与物理保真度严重脱钩。
- VLM 检测关系物理违规的最佳准确率仅 67%,多数模型接近随机水平(约 50%),说明现有视觉语言模型缺乏对物理关系一致性的判别能力。
与基线对比解读
VBench 等通用视频质量基准无法暴露模型在物理推理上的缺陷,因为其指标侧重纹理、运动平滑度等感知层面。Principia 通过成对物体关系一致性消除了帧率、尺度、相机标定等混淆因素,更能反映模型是否真正理解牛顿力学。这一差距表明:当前视频生成器的物理一致性远落后于其视觉逼真度,直接提升模型规模或数据量未必能解决关系推理短板,需要引入物理先验或针对性训练。
行业影响
工业界影响
落地场景:Principia 可嵌入视频生成平台(如 Runway、Pika)的质量评估环节,在生成物理交互类内容(物体掉落、碰撞、摆动)时实时计算一致性得分,过滤物理失真视频。自动驾驶仿真 与 机器人训练数据生成 也可用其筛选出符合牛顿力学的合成视频,提升仿真数据的有效性。教育动画 / 科普内容 工具链可用它保证演示的物理正确性。
商业价值:对内容创作平台,减少人工审核物理失真镜头的成本;对广告 / 电商产品视频,降低因物理穿模 / 运动异常导致的用户信任下降,提升转化率。对合成数据商,用一致性得分作为质量门槛可降低下游模型训练错误,节省因数据噪声带来的重训成本。
与现有工作流的接口:Principia 的校准无关一致性得分可作为一个轻量级后处理指标,接入现有视频生成 pipeline(例如在生成后对每对物体轨迹做关系验证),与 VBench 等通用质量指标并行使用。对于 VLM 审核流程,可先用 Principia 的合成反物理数据微调或提示 VLM,提高异常检测准确率。该基准以真实场景录制视频为参考,便于扩展。
具体 use case:
- 电商产品展示:生成商品跌落、碰撞、旋转的短视频时,使用关系一致性筛选出物理合理版本,避免出现不符合重力的悬浮或错误反弹。
- 短视频内容审核:平台可对用户上传的物理特效视频(如慢动作、模拟)进行一致性检测,识别 AI 生成物理不协调片段,辅助标注。
局限
- **数据集规模与覆盖范围有限**:Principia 使用受控协议拍摄的真实场景,虽保证可重复性和标定独立性,但物体类别、材质和运动组合仍显局限,可能与开放域视频生成的实际分布存在差异。当前仅覆盖八种经典牛顿现象,缺乏多物体刚体接触、流体或非理想约束等更复杂物理,因此评估结论可能无法推广到任意生成视频。
- **一致性分数依赖感知前端**:虽然标定无关的一致性分数直接在图像空间计算,但需要准确的物体检测、分割或关键点定位。若视频生成质量较差或物体遮挡严重,感知误差会传播到物理违反度量,导致分数噪声。作者虽可能采用自动标注,但未充分量化感知失败对最终分数的影响,这可能限制基准在低质量生成上的可靠性。
- **VLM 评估任务过于简化**:对视觉语言模型的评测主要是二分类式“检测物理违反”,可能忽略模型在定位、归因或定量推理上的能力。最佳模型仅 67% 准确率而多数接近随机,这一结果可能部分源于任务形式或数据偏差,而非纯物理推理差距。论文未设置更细粒度的解释基准,限制了 VLM 物理推理能力的诊断深度。