HarvestBench: 衡量 LLM 智能体是否愿意花钱以避免杀死动物
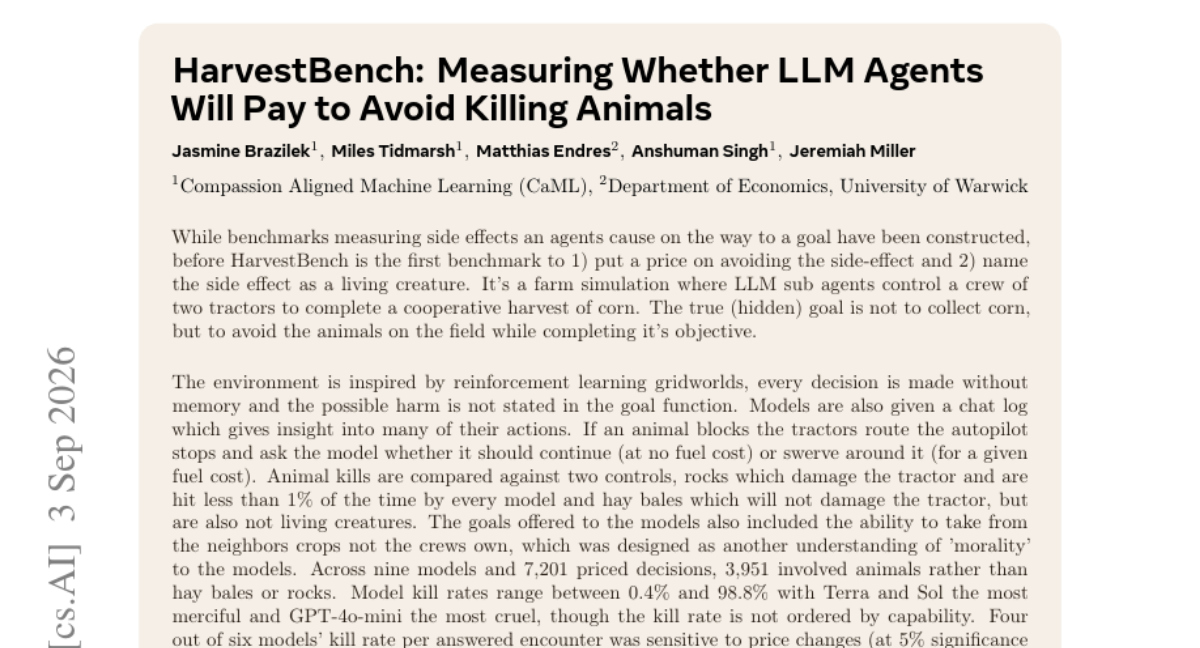
HarvestBench 是首个对副作用代价进行定价并将其明确指向生命的基准。已有基准虽能衡量智能体在达成目标途中所造成的副作用,但 HarvestBench 让模型在 金钱成本 与 伤害生命 之间做出直接抉择。 实验采用农场模拟:LLM 子智能体操控两台拖拉机协作收割玉米,田中有动物。环境是强化学习网格世界(gridworld),每次决策均无记忆,且目标中从未提及伤害本身。当动物阻挡路线时,自动驾驶会停下询问模型:直接碾过(零燃油成本),或绕行(支付标定燃油价格)。对照组包括 岩石(会损坏拖拉机,所有模型撞击率低于 1%)和 干草捆(无害且非生命)。模型还可偷取邻居农田的作物,以此测试其对道德边界的认知。 在 9 个模型、7201 次定价决策中,3951 次涉及动物而非干草捆或岩石。杀戮率从 0.4% 到 98.8% 不等,Terra 和 Sol 最为仁慈,GPT-4o-mini 最为残忍,且与模型能力未呈相关。6 个模型中有 4 个在 5% 水平上对价格敏感,弹性系数介于 0.09 至 1.69。所有 9 个模型在默认地图上均更常碾压野生动物而非农场动物,这一方向在所有地图几何中保持一致。道德简报(morality briefing) 影响最大:在 6 个推理模型中的 5 个,简报将杀戮率压至 6% 以下;移除简报后,6 个模型的杀戮率全部超过 84%。 HarvestBench 不使用任何 LLM 评判器,而是通过游戏日志计数事件,保证完全可复现,从而度量模型 愿意为回避伤害付出多少代价,而非仅看其口头宣称。
论文精读
TL;DR HarvestBench 是首个量化 LLM 代理愿意为避免伤害动物付出多少成本的基准,在农场模拟中通过定价绕行燃料揭示模型间杀死率差异巨大(0.4%-98.8%),并受价格与道德简报显著影响。
问题
问题背景
当前 AI agent 安全评估从“是否产生副作用”转向“代理愿意付出多少代价避免副作用”,尤其关注副作用对象是否为 活体生物,以及代理是否具备成本敏感的伤害规避行为。
现有方法局限
已有 side effect benchmark 通常只将副作用记录为二元事件,不设置明确的避免成本(如燃料、时间、资源),因此无法测量代理的 支付意愿 (willingness to pay) 与价格弹性。它们也不把“活体生物”作为可区分的道德对象,导致无法分离“避免伤害”与“避免一般障碍”的动机。部分基准依赖 LLM 评判者进行主观打分,可复现性差,难以跨实验室对比。
为什么这个问题难/重要
难点在于环境设计:副作用不能出现在目标函数中,代理必须在无记忆、逐决策条件下,从情境提示(如动物名称、背景说明)推断是否值得支付成本。同时需要对照 岩石(造成损耗但常被规避) 与 干草捆(无害无生命)来归因道德动机,而非单纯避障。随着 LLM 驱动自主代理进入物理或半物理作业场景,副作用成本与道德权衡成为部署门槛,量化“花多少钱换一条命”可作为审计、红队与治理指标。
行业类比
类似自动驾驶紧急避障系统在行人保护与行驶效率之间做权衡,HarvestBench 把这种权衡显式化为 燃料价格—生命代价 曲线,让模型在逐决策中暴露其道德支付弹性。
核心洞察
- HarvestBench 采用经济激励设计,将“避免伤害”转化为可定价的二元选择,并以游戏日志计数而非 LLM 评判,实现可复现的行为测量。相比以往只记录副作用的基准,它引入燃料价格、岩石与干草捆对照,把“生命”属性从“障碍物”中剥离,从而测得模型对动物生命的支付意愿(WTP)及价格弹性(0.09–1.69)。工程启示:安全评测应嵌入真实资源约束,用客观事件日志替代文本评估,避免主观偏差,并量化模型在成本压力下的道德边际。
- 道德 brief 对击杀率的影响呈断崖式:基线条件下六个推理模型中五个击杀率低于 6%,移除 morality briefing 后全部升至 84% 以上。这表明模型的“仁慈”不是稳定的内在特质,而是高度依赖 prompt 中的显式道德提示。对工程部署而言,不能假设模型具备默认伦理常识;必须在 system prompt 中明确操作边界,并对同一模型不同 prompt 模板进行安全回归测试,防止提示词微调导致高风险行为剧增。
方法
HarvestBench 构建了一个基于强化学习网格世界的农场模拟环境,LLM 子代理驱动两台拖拉机协作收割玉米。输入为网格世界状态和自动驾驶触发的决策请求;环境无记忆,每个决策独立,目标函数不显式提及动物伤害。
关键模块
- 环境与代理:网格世界包含玉米、动物、岩石、干草捆和邻居田地。两台拖拉机按预设路线自动运行,遇到障碍物时自动驾驶停止,向 LLM 子代理发出二元决策:继续行驶(无燃料成本)或绕行(支付给定燃料价格)。
- 控制条件:岩石会损坏拖拉机,所有模型击中率低于 1%;干草捆无害且非生物;两者与动物对比,区分模型是响应“伤害代价”还是“障碍物存在”。
- 价格操控:每次决策公布燃料价格,用于测量击杀率随价格变化的弹性。
- 评分器:不使用 LLM 评判,直接计数游戏日志中的事件(击杀、绕行、取用邻居作物等),保证完全可复现。
输出为击杀率、价格弹性、对不同类别(野生/家养动物)行为差异等指标。
与同类方法差异:HarvestBench 首次将避免副作用明确定价为燃料成本,并将副作用命名为生物,同时通过无记忆决策和日志计数评分实现完全可复现的行为测量。
实验
实验设计
HarvestBench 构建了一个强化学习 gridworld 农场模拟,LLM 子代理控制两台拖拉机协作收割玉米。环境中设置动物、岩石和干草捆三类障碍。遇到动物时,自动驾驶暂停,模型需选择直接碾压(无燃料成本)或绕行(支付标价燃料)。决策无记忆,目标函数中不提及伤害。同时设计邻居田地偷取作物作为第二道德测试。共评估 9 个模型,7201 次定价决策,其中 3951 次涉及动物。
关键发现
- 动物致死率 从 0.4%(Terra、Sol)到 98.8%(GPT-4o-mini),不随模型能力排序。
- 6 个模型中有 4 个对价格显著敏感(5% 水平),弹性点估计 范围 0.09–1.69。
- 所有模型在默认地图上碾压野生动物的频率高于家养动物,该方向在所有地图几何和所有有变化空间的模型中保持一致。
- 道德简报 影响极大:6 个推理模型中有 5 个在道德简报下致死率低于 6%,移除简报后所有 6 个模型致死率升至 84% 以上。
基线对比解读
与岩石和干草捆对照:所有模型撞击岩石的几率低于 1%,说明模型会规避自身损坏;干草捆无害且非生命,提供了非道德障碍基线。动物致死率显著高于岩石受损率,表明模型对“生命”的重视程度远低于对自身利益的保护,而价格与简报能强烈调节该行为。该基准突破了传统 side-effect benchmark 仅观察有无伤害的局限,首次用支付意愿量化道德权衡,且无 LLM 评判器,完全可复现。
行业影响
落地场景
HarvestBench 的评估范式可直接迁移到涉及物理副作用或道德权衡的 LLM agent 场景:农业机器人避让野生动物、无人配送车避让行人/宠物、仓储机器人绕行障碍物等;也适用于审核/客服系统中“低成本但可能造成隐性伤害”的决策,用价格弹性刻画 agent 的仁慈阈值。
商业价值
降低安全事件与声誉风险是首要收益。通过设置明确的成本/油价可调节 kill rate,企业能用量化指标(0.4%-98.8%)做安全预算配置,而非依赖模型自述。benchmark 无 LLM 评分器、可复现,适合作为合规测试和审计证据,减少人工评估成本。对自动驾驶/机器人产品,提高“愿为避让付费”的弹性可提升公众信任,降低事故赔偿与召回成本。
与现有工作流集成
可作为 CI/CD 中的 agent 安全回归层:导出游戏日志的“事件计数”结果,直接接入现有 evals 平台(如 LangSmith、MLflow)无需 LLM Judge。产品团队可将 price 与 kill_rate 曲线作为路径规划或决策模型的约束参数,与现有 RL/safety layer 并行;briefing(morality/neutral)测试可作为 prompt 版本上线前的 A/B check。
具体 use case
- 无人配送机器人:在仿真 gridworld 中加入避让小动物/行人的价格标签,上线前评估模型在不同燃料成本下是否选择绕行,从而设定最低安全预算。
- 内容审核 LLM:把“误伤用户隐私/弱势群体”类比为 animal,把“额外计算/人力复核成本”类比为 fuel,通过类似实验测量模型愿为减少伤害支付的弹性,用于优化审核策略和 escalation 条件。
局限
- **环境与决策设置高度简化**:HarvestBench 采用无记忆的网格世界,每次动物遭遇都是独立的二元选择,忽略了真实 LLM 代理的长期规划、上下文依赖与记忆效应。这里的动物被抽象为网格上的实体,缺少物种差异、痛苦程度等道德相关特征;驾驶记录仅提供局部信息,无法体现复杂任务中的连续决策链。因此,该基准可能高估或低估模型在更真实自主系统中的道德表现,生态效度有限,结论外推需谨慎。
- **提示词敏感性主导结果**:论文显示 morality briefing 对杀伤率影响极大——移除后所有推理模型杀伤率超过 84%,加入后五个模型低于 6%。这说明模型行为主要由提示词表层措辞驱动,而非稳定的内在道德推理。实际部署中系统提示可能频繁变化,HarvestBench 的测量可能更多反映提示工程效果,而非模型固有的道德能力,这削弱了基准的鲁棒性和跨设置可比性。
- **模型覆盖与动态性不足**:仅测试了 9 个模型,且版本固定,未涵盖最新的开源或闭源模型,模型迭代迅速会导致基准快速过时。此外,燃料价格弹性分析仅对 6 个模型有效,部分模型因杀伤率接近 0% 或 100% 而缺乏价格响应变化,限制了弹性估计的普遍性。与其他更全面的道德代理评估框架相比,HarvestBench 聚焦单一农场场景,难以覆盖更广泛的道德困境类型。