Scal3R: 学习高效的多参考相对位姿查询用于可扩展的在线三维重建
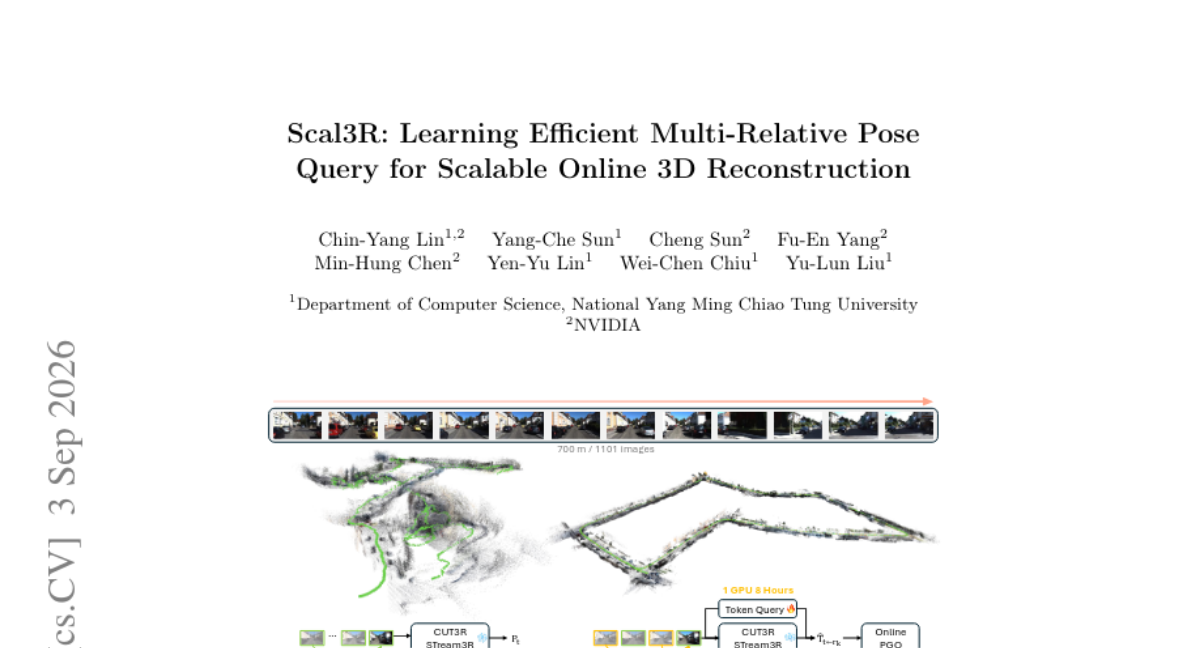
在线三维重建模型在长视频上表现不佳。这是因为相对于固定的首帧锚点回归位姿,会迫使模型外推到远超训练分布的范围。微小的漂移不断累积并放大为显著的几何塌陷。然而,我们观察到在此类失败过程中,每帧深度保持稳定。模型的骨干网络的局部几何结构完好;只有全局位姿头崩溃。受此解耦现象的启发,我们提出 Scal3R。 该方法将在线重建重构为多参考相对位姿查询。我们使用轻量级可学习 token,其参数量约占模型的 1%,通过非对称注意力注入完全冻结的骨干网络中。该机制可查询相对于多个历史关键帧的位姿。在线位姿图优化系统配合闭环检测抑制长程漂移。Scal3R 在单张 GPU 上可在 8 小时内收敛。与在线基线相比,在 KITTI 上平均 ATE 降低超过 60%。此外,它在 Virtual KITTI、Sintel、TUM-Dynamic、ScanNet 和 7-Scenes 上也达到了最先进性能。
论文精读
TL;DR Scal3R 将在线 3D 重建改为对多个历史关键帧查询相对位姿,仅训练约 1% 参数注入冻结 backbone,配合位姿图优化与回环抑制长视频漂移,KITTI ATE 降超 60%。
问题
问题背景
在线 3D 重建是 AR/VR、自动驾驶与机器人领域的基础能力,当前研究重点关注在长视频流上保持几何一致性与位姿精度。
现有方法局限
主流在线重建模型(如 CUT3R、STream3R)通常将相机位姿回归到固定的第一帧锚点。这种方式迫使模型在长序列上做外推,一旦视频长度超出训练分布,小误差会逐步累积并放大为严重的几何坍塌。实验观察到,此时逐帧深度估计仍然稳定,说明主干网络的局部几何推理并未失效,失效的是全局位姿头——模型对远距离帧的绝对位姿回归能力急剧下降。
为什么这个问题难/重要
长序列位姿估计的难点在于:全局位姿需要同时满足局部帧间约束与全局闭环约束,而固定锚点回归无法有效利用序列中的多参考信息。漂移一旦产生,就难以通过简单后处理消除,必须重新设计查询机制。业界对实时、可扩展的在线重建需求强烈,尤其是在长时间运行的移动设备或机器人平台上,任何重训练主干网络或复杂优化的方案都面临计算与部署限制。
行业类比
这一困境类似于长上下文 LLM 中绝对位置编码失效的问题:当序列长度超出训练范围,相对位置编码与滑动窗口机制往往比固定锚点更鲁棒,在线重建也需要从绝对位姿回归转向多参考相对查询。
核心洞察
- 在线 3D 重建的漂移源于固定参考帧的外推,但局部几何(每帧深度)保持稳定,因此可将全局位姿估计与局部几何重建解耦。Scal3R 完全冻结骨干网络,仅用约 1% 参数的轻量 tokens 通过非对称注意力注入,查询多个过去关键帧的相对位姿。与 CUT3R / STream3R 等在线基线相比,这种方法避免了长视频下训练分布外推导致的位姿头崩溃,同时将训练成本降低至单 GPU 8 小时收敛。
- 用多参考相对位姿查询加在线位姿图优化与闭环检测,替代单固定锚点绝对回归,将长序列漂移抑制转化为图优化问题。Scal3R 把关键帧选择和闭环检测嵌入在线推理流程,与学习到的相对位姿查询协同,利用图优化传播不确定度并降噪。相比仅依赖前向模型滤波的 SLAM 前端,它更鲁棒;相比传统 SLAM 系统,它不依赖手工特征或深度传感器,保持学习骨干的泛化性。在 KITTI 上平均 ATE 降低超过 60%,并在多个数据集达到 SOTA。
方法
输入与总体流程
Scal3R 的输入为长视频连续帧,沿用现有在线 3D 重建主干(如 CUT3R 或 STream3R)提取逐帧特征与局部几何。关键观察是:即使全局姿态头因长序列外推而崩溃,per-frame depth 仍保持稳定,说明主干局部几何表征完好。Scal3R 因此完全冻结主干,仅训练新增的轻量 token。
关键模块:多参考相对姿态查询
- 可学习 token:引入一组约 1% 参数的轻量 token,通过 非对称注意力(asymmetric attention) 注入到冻结主干各层。这些 token 不与原始 token 对称交互,而是单向查询主干特征,避免干扰原有表示。
- 多参考解码:token 被设计为查询相对于多个过去关键帧(而非固定第一帧)的相对姿态。解码头从 token 输出各参考帧的相对位姿,训练时采用相对姿态损失(如 L1/L2 回归相对平移与旋转)。
- 在线姿态图优化:推理时动态选取关键帧构建位姿图,以相对姿态为边、关键帧全局位姿为节点,运行轻量 pose-graph optimization (PGO);同时加入 loop closure 检测,回环约束用于消除累积漂移。
输出与差异点
输出为每帧在全局坐标系下的优化后姿态,支持长视频稳定重建与轨迹估计。与固定单锚点回归或需要重训整个主干的方案不同,Scal3R 通过冻结主干 + 轻量 token 适配 + 位姿图优化,以极低训练成本(8 小时单 GPU)达到可扩展的在线重建性能。
实验
实验设计
Scal3R 在 KITTI 上评测平均 ATE,并与 online baseline 对比;同时在 Virtual KITTI、Sintel、TUM-Dynamic、ScanNet 上验证跨域泛化。模型冻结现有重建 backbone,仅注入约 1% 参数 的 learnable tokens,通过 asymmetric attention 查询多参考相对姿态,配合在线 pose-graph 优化与 loop closure。训练仅需单 GPU,8 小时收敛。
关键发现
作者观察到长视频失败时 per-frame depth 仍保持稳定,说明 backbone 的局部几何并未退化,只有全局姿态头崩溃。Scal3R 通过多参考相对姿态查询避免固定第一帧锚点的外推问题,并用图优化和回环抑制长期漂移。在 KITTI 上平均 ATE 降低 超过 60%,在其余数据集取得 SOTA。
与 baseline 对比
相比直接回归全局姿态的 online baseline,Scal3R 对 backbone 完全冻结,仅微调轻量 token,避免灾难性遗忘并显著降低适配成本。其核心差异在于将姿态预测从单锚全局回归改为多关键帧相对查询,再经图优化融合,使系统可扩展至长序列。
行业影响
落地场景
Scal3R 适用于需要长时在线 3D 重建的场景:
- 自动驾驶:车辆对连续街道视频进行实时建图与定位,减少漂移导致的地图不一致,提升 SLAM 系统的长期稳定性。
- 消费级 AR / VR:手机或头显扫描室内环境生成稳定网格,支撑虚拟家具摆放、空间锚定等应用。
- 机器人巡检与仓库自动化:移动机器人对大型环境进行增量式 3D 建模,支持导航与数字孪生更新。
商业价值
Scal3R 的核心价值在于降本与提升体验:
- 训练仅需 8 小时单 GPU,新增参数量约 1%,主干完全冻结,无需对现有模型进行昂贵重训或架构改动。
- 在 KITTI 等基准上将平均 ATE 降低 60% 以上,显著提升重建精度,减少下游应用中的手动修正与返工。
- 支持长视频输入,突破首帧锚定导致的几何崩塌,使产品可覆盖更长时段的扫描或导航任务,扩展可服务市场。
与现有产品/工作流的接口
Scal3R 设计为即插即用的调优模块,易于集成进现有在线重建技术栈:
- 基于 CUT3R 或 STream3R 等主流主干,通过非对称注意力注入可学习 token,不修改主干推理计算图。
- 姿态图优化与回环检测作为独立后处理模块,可对接现有 SLAM 前端或学习型位姿估计器。
- 部署友好:主干冻结,推理时仅需额外计算轻量 token 的注意力与 PGO,适合边缘设备或云端流水线。
局限
- **依赖 backbone 的深度估计质量**:Scal3R 假设 backbone 的逐帧深度始终稳定,仅微调位姿头。但如果 backbone 在低纹理、强遮挡或前视相机下深度估计不准确,局部几何可能失效,多参考查询难以校正,整体重建仍会退化。作者虽在多个数据集验证,但未针对极端条件(如大面积反光、无纹理白墙)做专项压力测试,其鲁棒性边界需进一步明确。
- **在线位姿图优化的计算开销与参数敏感性**:方法引入关键帧选择、回环检测与 PGO 噪声模型,多个超参数需手动调节。论文虽给出 runtime analysis 和 PGO 参数附录,但为了实时性可能牺牲回环召回率;在线推理时 PGO 的累积图优化可能带来不可忽略的后端延迟,对低算力设备不友好。另外,回环检测依赖特征匹配,在动态物体多的场景易产生误匹配,影响一致性。
- **与同期 LongStream 等方法对比不充分**:论文在附录 D.3 中与并发工作 LongStream 做了比较,但正文实验主要对比离线/在线基线,未全面覆盖最新的长序列重建方法(如基于 3DGS 的在线系统)。此外,Scal3R 仅验证了相机位姿估计与稠密重建,未展示语义分割、动态物体去除等下游任务的迁移效果,限制了其实用性评估。