基于冻结VLMs的无训练语音中心全模态理解
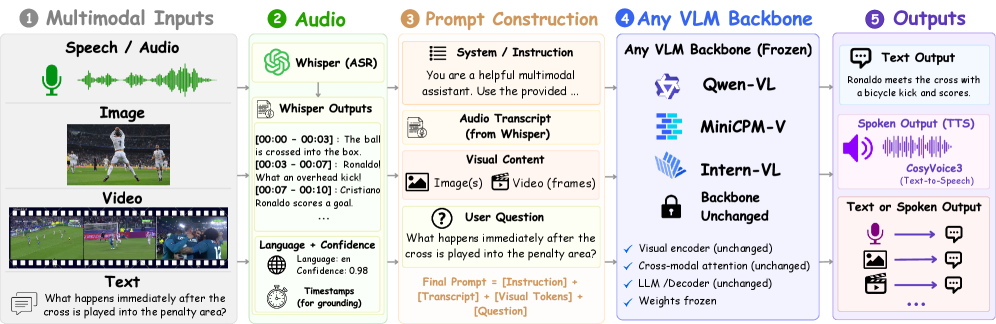
音视频理解任务需要模型同时解析语音内容、视觉事件及其时间关系,而现有全模态模型通常引入专用音频编码器,并依赖昂贵的音视频-文本训练,导致全模态能力与特定VLM骨干绑定,可能削弱原有视觉及推理能力。这引发三个问题:每个新VLM是否都需要原生全模态训练?能否在不改变骨干的前提下添加语音中心的全模态能力?以及何种场景下仍需更丰富的声学表征? TFO(Training-Free Omni)作为一种即插即用框架,无需修改冻结VLM的架构或进行多模态重对齐。它利用Whisper提取经过置信度过滤且带时间戳的转录,将其接入VLM现有的语言接口,同时保持视觉通路完全不变。 在56个基准及21种语言上与原生全模态模型进行配对比较,TFO在音视频理解上表现相当,在全部五种模型设置中均提升了平均纯音频性能,并带来显著的多语言语音增益。冻结VLM还通常在图像/视频理解、视觉定位、编程、数学推理及医学问答方面优于对应的原生全模态检查点。综上所述,强大的语音中心全模态理解往往可通过模块化的音频到语言路由实现,而非依赖成本高昂的骨干定制训练。
论文精读
TL;DR TFO 用 Whisper 提取带时间戳转录并路由到冻结 VLM 的语言接口,不改架构、不训练,实现语音中心的全模态理解;在 56 基准与 21 种语言上保持原视觉推理能力并提升音频表现。
问题
问题背景
音频-视觉理解任务要求模型同时处理语音内容、视觉事件及其时间关系。当前领域关注如何构建通用 omni 模型,使单一 backbone 覆盖语音、图像、视频等模态。
现有方法局限
主流 omni 模型引入专用音频编码器,并进行大规模音频-视频-文本联合训练。这种做法导致 omni 能力与特定 VLM backbone 深度耦合:每发布一个新 VLM 都需要重新训练;新增训练可能灾难性遗忘原有视觉和推理能力。音频模态的序列长度与高噪声特性,也容易在联合训练中引入模态干扰,降低已有图像/视频任务表现。
为什么难/重要
技术难点在于:在不修改架构、不做多模态重对齐的前提下,利用已有大模型的泛化能力处理新模态。业界关注点是训练成本与模型生态——VLM 迭代速度远快于 omni 模型,训练专用 omni backbone 的成本和周期难以跟上。TFO 通过模块化路由解决这一问题,证明了语言接口作为中间表示的有效性,对实际部署很重要:可快速为现有 VLM 接入语音视频理解,无需预训练或微调。
行业类比
类似用现成 ASR(如 Whisper)的转录结果直接喂给通用 LLM 实现语音对话,而不是从零训练语音 LLM;TFO 把这一思路扩展到视频场景的语音-视觉联合理解。
核心洞察
- TFO 证明,通过 Whisper 提取转录并路由到冻结 VLM 的语言接口,就能为任意 VLM 增加语音中心的 omni 理解能力,无需训练或架构修改。与原生 omni 模型相比,后者需要为每个 VLM 骨干单独训练音频编码器并进行多模态对齐,成本高且可能损害原有视觉和推理能力。TFO 的 plug-and-play 方法利用 VLM 已有的语言理解路径,避免重复训练,同时在 56 个 benchmark 和 21 种语言上验证了竞争力,并保留了原始 VLM 在图像/视频理解、coding、数学、医疗问答等任务上的更强性能。
- TFO 揭示了一个关键边界:多数 speech-centric 音频-视觉任务仅依赖语言级转录(文本)即可解决,不需要原始声学特征。通过在音频-only 和音频-视觉任务上的消融,TFO 表明 Whisper 提取的置信度过滤带时间戳的转录足够,而需要副语言信息(如情感、语调、说话人状态)的任务才真正需要专用音频编码器。这一发现直接回答了“哪里需要更丰富的声学表示”,并为实际工程提供权衡:通用场景可优先采用轻量级转录路由,只有特定声学分析场景才值得投入更复杂的音频编码。
方法
TFO 采用与原生 omni 模型完全不同的免训练路由范式,将语音理解转化为语言接口的附加输入,避免对 VLM 进行任何架构修改或权重更新。
输入与预处理
系统接收音频流与视觉帧(图像或视频)。音频部分通过 Whisper 进行语音识别,得到带时间戳的转录文本;随后根据置信度阈值过滤低质量片段,保留高置信度转录,确保文本输入可靠。视觉帧则直接送入冻结的 VLM 视觉编码器,生成视觉 token。
核心模块:Audio-to-Language Routing
过滤后的转录文本(含时间戳信息)被转换为语言 token 序列,与视觉 token 一起注入 VLM 现有的语言接口(即文本输入通道)。该过程无需新增音频编码器,也无需多模态对齐训练;VLM 的视觉路径完全不变。对于视频输入,时间戳用于将转录与对应视觉片段在 prompt 中显式关联,形成时空对齐的多模态上下文。
输出生成
VLM 在冻结权重下接收融合后的 token 序列,直接生成文本答案。由于语音信息已通过语言接口表达,输出无需额外的跨模态解码器。
与原生 omni 模型(如 Video-LLaMA 等)相比,TFO 不引入专用音频编码器,也不进行音频-视觉-文本联合训练,因此可以即插即用地适配任意 VLM 骨干,同时保持原 VLM 的视觉与推理能力不退化。
实验
实验设计
TFO 与原生 omni 模型在 OmniEvalKit 评估套件上进行匹配对比,覆盖 56 个基准、21 种语言。评估维度包括音频-视觉理解、纯音频任务、图像/视频理解、视觉定位、代码、数学推理、医学问答。TFO 保持 VLM 冻结,仅将 Whisper 提取的置信度过滤、带时间戳的转录文本通过现有语言接口输入,视觉通路不变。
关键发现
- 在音频-视觉理解上,TFO 与原生 omni 模型竞争力相当。
- 在纯音频任务上,所有 五个模型设置 的平均性能均有提升。
- 多语言语音识别/理解提升显著。
- 冻结 VLM 通常保留比对应原生 omni 检查点更强的图像/视频理解、视觉定位、代码、数学推理、医学问答能力。
与基线对比解读
原生 omni 模型通常引入专用音频编码器并依赖昂贵的音频-视频-文本联合训练,这会将 omni 能力与特定 VLM 骨干耦合,可能削弱原有视觉与推理能力。TFO 展示了模块化音频到语言路由的可行性:无需为每个新 VLM 重复原生 omni 训练,即可获得较强的语音中心 omni 理解。然而,摘要也指出“更丰富的声学表示在哪些场景仍不可或缺”仍是开放问题,暗示纯转录可能丢失韵律、情感、环境声等非语言信息。
行业影响
落地场景
TFO 提供免训练、即插即用的方案,将冻结 VLM 快速升级为语音中心多模态模型。典型应用:
- 视频内容平台:自动为视频生成带时间戳的语音转录并与视觉帧对齐,支持基于语音的语义检索、片段定位与自动标签提取。
- 在线教育:针对课程录像,将讲师语音转为文本并结合幻灯片/板书画面,实现知识点问答、字幕生成与内容摘要。
- 企业会议记录:整合会议录音与屏幕共享画面,输出带时间轴的发言人转写与视觉要点,支持后续问答式检索。
商业价值
核心价值在于大幅降低多模态模型升级成本:
- 降本:无需为每个新 VLM 主干重复进行昂贵的音视频文本联合训练;复用 Whisper 与现有 VLM,训练成本为零。
- 提效:快速为现有产品增加语音理解能力,缩短上线周期;同时保留原 VLM 在图像/视频理解、推理、代码等任务上的能力,避免“能力退化”,减少回归测试与调优人力。
- 体验提升:语音驱动的多模态交互(如“找到视频中提及某关键词的片段并总结画面”)成为可能,提升内容消费与信息获取效率。
与现有产品/工作流的接口
TFO 天然适合作为中间件集成到现有 VLM 推理栈:
- 音频预处理:调用 Whisper 提取置信度过滤的转录文本及时间戳,作为语言输入。
- 视觉通路不变:原 VLM 的图像/视频编码与 token 化流程保持不变。
- 融合提示:将转录文本与视觉 token 通过提示模板结合,输入现有 VLM 完成推理。
工程上,TFO 可作为独立服务(如 audio-to-text 微服务)输出结构化转录,再与 VLM API 对接。无需改动模型权重或推理框架,支持流式与批处理,便于云端或边缘部署。相关评估套件 OmniEvalKit 提供基准与协议,便于团队快速验证效果。
局限
- **依赖 ASR 转录丢失副语言与非语言声学信息**:TFO 将音频完全转化为 Whisper 的文本转录,仅通过语言通道进入 VLM,因此无法利用韵律、语调、情感状态、重音等副语言特征,也无法捕捉非语言声音事件(如笑声、环境音、音乐)。对于需要这些信号的音频理解任务(如情感识别、说话人识别、音频场景分析),TFO 的性能上限受制于 ASR 的文本表达,无法替代专用音频编码器。作者也提到 'richer acoustic representations remain essential',说明这类任务仍需原生声学建模。
- **转录误差与置信度过滤导致信息损失**:TFO 使用 Whisper 的置信度过滤来减少错误文本,但这可能丢弃低资源语言、重口音或嘈杂语音中的有效信息,导致语音内容不完整或错误传播到 VLM。在 21 种语言上虽然整体增益,但个别语言或方言可能因为 Whisper 识别率低而表现不佳。而且两阶段推理(ASR + VLM)增加延迟和计算成本,对实时交互或多轮对话场景不友好。
- **与原生 Omni 模型相比在部分音频-视觉任务仅持平而非领先**:论文报告 TFO 在 audio-visual understanding 上 'competitive',表明它并未在所有相关基准上超越专门训练的 omni 模型。当视觉与语音存在强时间对齐或需要联合注意力时,仅靠文本时间戳可能不足以建模细粒度跨模态交互。由此,TFO 更适合语音内容为主的场景,对复杂音视频协同推理能力有限。