Mendel Gödel Machine: 通过比较进化实现递归自改进的编码智能体
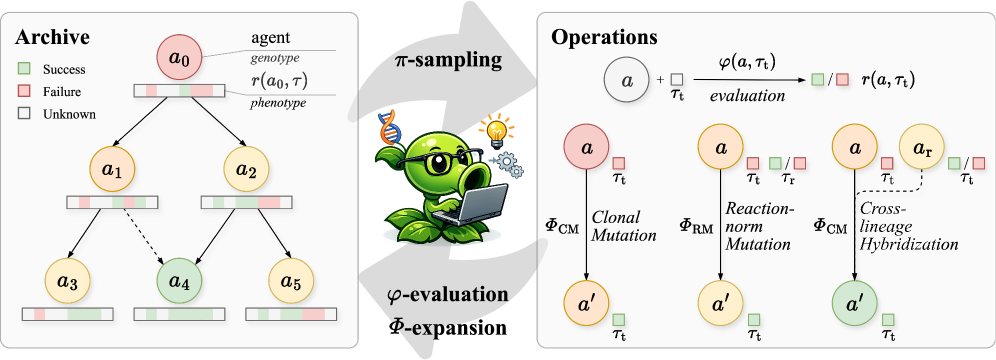
迭代重写自身源代码的自改进编码智能体在编码任务上表现出色。然而,现有方案通常每次仅从单条失败轨迹中推导自我修改,忽视了智能体不断扩展的历史尝试档案中所蕴含的丰富比较信号。 受孟德尔控制遗传原理启发,我们提出 Mendel Gödel Machine (MGM)。除通用的单轨迹克隆变异外,MGM 引入两种更充分利用累积证据的新型自我修改机制:reaction-norm mutation (反应规范突变) 同时基于智能体在多个任务上的轨迹进行编辑;cross-lineage hybridization (跨谱系杂交) 则利用同一任务上另一谱系参考智能体的轨迹进行编辑。 在加性适应度景观模型下,我们从理论上证明并通过受控替代仿真验证,新策略比单轨迹基线收敛更快、更好。在 SWE-bench 和 Polyglot 上的实验确认了 MGM 在性能、效率和泛化性上的一致提升。
论文精读
TL;DR Mendel Gödel Machine 借鉴孟德尔遗传原理,引入跨任务反应规范变异与跨谱系杂交,让编码代理利用多重比较信号自我改进,替代单一失败轨迹模式,在 SWE-bench 等基准上实现更快收敛与更高性能。
问题
问题背景
自改进编码代理(self-improving coding agents)通过迭代重写自身源码来提升编程任务表现,已展现出显著效果。当前领域关注如何让代理从自身历史经验中高效学习,摆脱对静态初始 prompt 或外部工具链的依赖。
现有方法局限
现有自改进方案(如 Gödel Machine 风格的单轨迹克隆突变)通常从单条失败轨迹推导一次自我修改:代理仅根据当前任务的一次执行结果调整代码。这种设计忽视了代理不断扩大的历史尝试档案中蕴含的丰富比较信号。具体来说:
- 单轨迹视角:每次突变仅利用一个任务实例的错误反馈,无法捕捉任务间共有的失败模式或成功模式。
- 无跨任务比较:不同任务上的表现差异、同一任务上不同代理变体的表现对比等有价值信息被丢弃,导致搜索效率低下。
- 谱系单一:缺乏跨谱系的基因重组机制,难以组合不同代理变体的优势片段。
为什么这个问题难/重要
从工程优化角度看,自改进代理本质上是一个昂贵的进化搜索问题:每次执行代理都消耗实际计算资源,因此采样效率和收敛速度直接决定可行性。利用多轨迹比较信号需要设计新的突变算子,并在加性适应度景观等假设下证明其理论优势,技术难度不低。业界对持续学习系统的需求日益增长,如何让代理在部署后仍能自动化地利用累积经验自我升级,是 AI 工程落地的关键挑战之一。
行业类比
类似 AutoML 中从单次超参数调优扩展到多任务元学习:单次实验只能得到局部信息,而汇总多个任务的历史实验结果可以推断出更稳健的搜索方向,从而大幅降低后续实验成本。
核心洞察
- 将孟德尔式比较演化信号引入自改进编码 agent,突破单失败轨迹的自我修改信息瓶颈。现有 self-improving agents 通常从单一失败轨迹推导修改,忽略了 agent 历史尝试 archive 中的跨任务、跨谱系比较证据。MGM 引入 **reaction-norm mutation**,基于多个任务轨迹同时编辑 agent;以及 **cross-lineage hybridization**,利用异谱系 agent 在同一任务上的轨迹,从而把“比较证据”作为诊断压缩,理论上在 additive fitness landscape 下证明更快收敛,并在 SWE-bench 和 Polyglot 上验证。
- 跨谱系杂交实现遗传物质交换,提升探索多样性与泛化能力。**cross-lineage hybridization** 允许一个 agent 从另一谱系的参考 agent 的轨迹中提取修改,类似遗传算法中的 crossover,但应用于 LLM 代码 agent 的源代码级自我修改。这打破了单谱系 **clonal mutation** 的局部搜索限制,引入多样策略探索,避免过早收敛。实验表明 MGM 在性能、效率和跨 benchmark/跨模型泛化上均优于单轨迹 baseline,说明演化得到的技能更具一般性。
方法
输入与迭代框架
MGM 将自改进 agent 视为可修改的源代码,每个迭代周期从任务池采样一个或多个编码任务,运行当前 agent 产生轨迹(成功或失败的代码修改记录)。所有历史轨迹累积进入档案,作为后续变异的证据来源。
关键模块:三种自修改操作符
- Clonal Mutation:沿用 Gödel Machine 的标准单轨迹变异,仅依据当前 agent 在单个失败任务上的轨迹,由 LLM 分析错误并重写源代码,相当于无性克隆。
- Reaction-norm Mutation:借鉴生物学反应规范概念,同时输入当前 agent 在多个任务上的轨迹,让 LLM 观察跨任务表现差异,生成能适应多种环境的源代码修改。
- Cross-lineage Hybridization:从另一个 lineage 中选取一个参考 agent,在同一任务上运行并收集其轨迹;然后将当前 agent 的轨迹与参考 agent 的轨迹合并,通过 LLM 杂交生成新 agent 代码。
输出与选择
每个操作符输出修改后的 agent 源代码。MGM 通过适应度函数(如任务通过率)筛选精英 lineage,并采用概率采样决定每次迭代使用哪种操作符。
差异点
与仅使用单轨迹 clonal mutation 的现有 Gödel Machine 变体不同,MGM 显式利用档案中的跨任务和跨 lineage 比较信号,在可加适应度景观下获得更快的理论收敛速度。
实验
实验设计
MGM 在 SWE-bench 与 Polyglot 两个 coding agent 基准上评估,基线为单轨迹 clonal mutation。除克隆变异外,引入两种新 self-modification 算子:reaction-norm mutation 基于同一 agent 在多个任务上的轨迹同时编辑;cross-lineage hybridization 使用另一 lineage 的参考 agent 在同任务上的轨迹进行编辑。另在 additive fitness landscape 上做 Monte Carlo 模拟验证理论。
关键发现
- 在 additive fitness landscape 模型下,理论证明并模拟显示新策略比单轨迹基线更快且更好地收敛。
- 在 SWE-bench 和 Polyglot 上,MGM 在性能、效率、泛化性上均有一致提升。
- 消融研究(ablation)确认两种新算子的贡献;跨基准与跨模型泛化实验表明进化出的 skills 更具通用性。
对比解读
单轨迹克隆变异仅从一条失败轨迹推导修改,信息利用率低,易受噪声影响。MGM 将 archive 中累积的多任务、多 lineage 轨迹作为比较证据,提供更稳定的优化信号。
实际工程中,维护历史轨迹库并设计多源比较融合机制,可以显著加速 agent 自改进,但需平衡轨迹存储与检索开销。与同类 self-improving agent 工作相比,MGM 首次将 Mendelian 遗传原则中的受控杂交与反应规范引入代码 agent 自我修改,从“单点试错”转向“群体比较进化”。
行业影响
落地场景
MGM 适用于自动化软件工程与持续代码演化场景,例如:
- AI 编程助手:在 Copilot 类产品中让代理根据历史成功/失败轨迹自我改进,减少反复提示成本。
- 自动化缺陷修复:对 CI/CD 流水线中失败用例,用多任务反应规范变异生成更稳健的修复补丁。
- 多语言代码生成平台:利用跨谱系杂交,将擅长不同语言或框架的代理知识融合,产出跨技术栈方案。
商业价值
主要贡献在降本提效:
- 减少人工修复循环:传统代理从单次失败中学习,MGM 利用积累轨迹,收敛更快,减少 LLM 推理次数与 token 消耗。
- 提升生成质量:实验显示在 SWE-bench 与 Polyglot 上性能与泛化性均有提升,降低后续测试与回滚成本。
- 增强跨场景复用:跨谱系杂交使代理能继承其他谱系在同类任务上的有效模式,适用于多租户企业服务中的代码模板沉淀。
与现有产品/工作流的接口
- 作为代理演化层:可集成到 SWE-agent、OpenHands 等 coding agent 框架,在其轨迹存储旁路加入 MGM 的变异与杂交算子。
- 轨迹库复用:利用现有日志系统(如 LangSmith、Weights & Biases)记录的多任务轨迹,触发 reaction-norm mutation。
- 轻量部署:MGM 的演化操作只修改代理源代码或提示,不需要重新训练基础模型,可作为 CI 中的后处理服务。
典型用例:电商平台在大型促销前自动生成并演化下单、库存同步的 API 集成代码,减少人工编写后台微服务的时间;企业 SaaS 厂商用 MGM 持续优化内部代码生成代理,为客户交付定制化集成时快速产出符合规范的代码。
局限
- 论文在理论部分承认 additive fitness landscape 假设与现实任务存在差异,这可能限制结论的普适性。交叉杂交需要选择合适的参考谱系,否则可能引入劣质基因,论文对选择策略的鲁棒性讨论不够充分。同时,维护多谱系和历史档案会带来额外的计算与存储开销,实际部署成本显著高于单轨迹方法。
- 实验仅在 SWE-bench 和 Polyglot 两个编码基准上验证,任务类型偏向软件工程和代码生成,缺乏对更多样化任务(如数学推理、通用 agent 控制)的测试,泛化性证据有限。此外,评估主要关注相对提升,未与更强的基础模型或更新基准充分对比,可能掩盖绝对性能瓶颈。
- 方法引入了多个新超参数(如操作符采样概率、参考谱系数量、杂交系数等),论文未提供系统的超参数敏感性分析,实际使用时调参成本可能较高。与单轨迹自改进相比,流程复杂度上升,若任务轨迹质量不高,比较信号可能误导变异方向,导致性能波动。