合成数据能把 Thai OCR 带到多远?
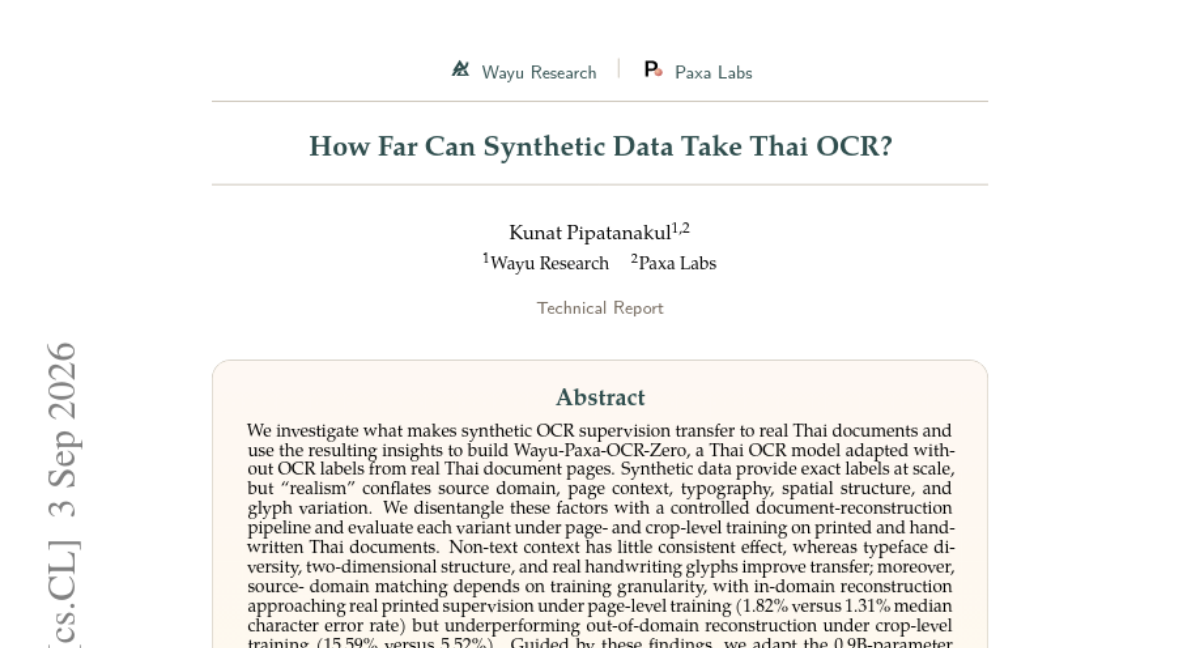
合成数据能提供规模化的精确标注,但「真实性」 混杂了源域、页面上下文、字体排印、空间结构和字形变化等多种因素。我们研究是什么让合成 OCR 监督迁移到真实的 Thai 文档,并据此构建 Wayu-Paxa-OCR-Zero —— 一个无需真实 Thai 文档页面 OCR 标注即可适配的 Thai OCR 模型。 我们通过受控的文档重建流水线解耦上述因素,并在印刷与手写 Thai 文档上,以 page-level 和 crop-level 两种训练粒度评估每种变体。结果显示: - 非文本上下文的影响不稳定且很小; - 字体多样性、二维结构 和 真实手写字形 能改善迁移; - 源域匹配的作用取决于训练粒度:page-level 下域内重建接近真实印刷监督(中位字符错误率 1.82% vs 1.31%),而 crop-level 下却不如跨域重建(15.59% vs 5.52%)。 依据这些发现,我们用 45,723 个合成页面将 0.9B 参数的 PaddleOCR-VL-1.6 适配为 Wayu-Paxa-OCR-Zero。相对于其基座 checkpoint,印刷页面的中位字符错误率从 6.64% 降至 1.24%,手写从 74.87% 降至 20.55%,并在全部五个评测集上超过 Typhoon OCR v1 7B,表明仅用合成数据的训练同样可以具备竞争力。
论文精读
TL;DR 仅用合成文档训练的泰语 OCR 模型 Wayu-Paxa-OCR-Zero,通过解耦字体多样性、页面结构与真实手写字形等关键因素,在无真实 OCR 标签下显著降低字符错误率,逼近真实标注监督效果。
问题
问题背景
低资源语言 OCR 长期受限于真实标注稀缺,合成数据因其可扩展、标签精确而成为替代方案,但合成到真实的迁移效果并不稳定。
现有方法局限
现有合成 OCR 管道通常把“真实感”作为单一目标,混淆了多个独立因素:源文档域、页面上下文、字体多样性、二维空间结构、手写字形变化。这导致三方面问题:
- 合成渲染缺乏可控消融,无法判断哪些因素真正影响迁移;
- 训练粒度(页面级 / 裁剪级)与源域匹配的交互未经验证,同一合成策略在不同粒度下表现相反;
- 手写体合成普遍退化为印刷体或有限字体,难以覆盖真实手写的字形分布。
为什么这个问题难且重要
泰文文字系统复杂:无显式分词、含声调符号与组合字符,合成渲染需同时保证字形正确与排版自然。真实 OCR 标注成本极高,而合成数据虽可无限生成,但域差距会显著放大 字符错误率 (CER)。业界关注如何用最小真实标注成本获得可部署的低资源 OCR 模型,因此分离迁移因子、量化各因素贡献具有直接工程价值。论文中一个关键发现是:源域匹配的效果取决于训练粒度——页面级训练时 in-domain 重建接近真实监督(1.82% vs 1.31% 中位 CER),而裁剪级训练时 out-of-domain 重建反而更优(15.59% vs 5.52%)。
行业类比
类似自动驾驶中的合成街景数据:若不能区分天气、光照、纹理等独立因素,域随机化的增益有限;只有可控消融才能指导数据生成策略,避免无效堆料。
核心洞察
- 合成数据迁移玄机在于将“真实性”解耦为可独立控制的因子,而非追求单一视觉上的“像”。该论文通过受控文档重建管线,分别考察源域、页面上下文、字体多样性、二维空间结构、手写字形等因素。与大多数仅堆叠合成数据或盲目增加数据量的工作不同,它给出各因子的量化影响:非文本上下文作用有限,字体多样性与二维结构、真实手写字形显著提升迁移。这为合成数据生成提供了明确的优先级排序,工程师可以据此设计渲染管线,用有限的算力产生最大的域迁移收益。
- 训练粒度决定合成数据的域匹配最优策略,页面级与 crop 级训练需要不同的数据构造逻辑。实验发现,页面级训练时,域内重建的合成数据接近真实监督(CER 1.82% vs 1.31%);而 crop 级训练时,域外重建反而表现更好(15.59% vs 5.52%)。这种反转表明,OCR 模型在整页序列建模中更依赖版面上下文,而裁剪后的局部识别更依赖字形本身。因此,工程实践中不能将同一套合成数据直接用于不同训练格式,必须针对训练粒度调整合成数据的源域和版面属性。
- 合成数据驱动的参数高效微调能超越更大规模的专用 OCR 模型。论文用 45,723 张合成页面将 0.9B 参数的 PaddleOCR-VL-1.6 适配为 Wayu-Paxa-OCR-Zero,在打印体 CER 从 6.64% 降至 1.24%,手写体从 74.87% 降至 20.55%,并在五个评测集上超过 7B 的 Typhoon OCR v1。这表明在数据受限场景下,精心设计的合成数据管线比单纯扩大模型参数量更具性价比,为资源有限团队提供了可行的技术路径。
方法
输入 → 关键模块 → 输出
该方法以真实打印/手写泰国文档页面为参考,结合大规模无标注文本,构建受控文档重建流水线。输入包括:结构化文本行、字体与字形资源、真实手写字形裁剪样本。
关键模块如下:
- Fit-Constrained Rendering:将文本行约束到页面区域,模拟真实排版中的空间填充与对齐。
- Typeface Rendering:通过多样字体(含粗体、斜体变体)渲染字符,提升模型对打印字体的泛化。
- Handwriting Real-Glyph Rendering:从真实手写样本中提取真实字形,重组为手写风格文本行,避免合成手写风格失真。
- 训练粒度切换:分别采用页面级(整页文档图像)和裁剪级(文本行图像)训练,考察不同粒度下合成数据迁移能力。
输出为带有精确字符级标签的合成文档图像。最终将 PaddleOCR-VL-1.6(0.9B 参数)在 45,723 张合成页面上适配,得到 Wayu-Paxa-OCR-Zero,无需真实 OCR 标注。
与同类合成数据方法不同,本工作不是简单堆叠噪声或字体随机化,而是通过消融实验量化源域、字体、结构、字形等因素对迁移的独立贡献,并据此根据训练粒度调整重建策略。
实验
实验设计
通过受控文档重建管线解耦“真实感”中的源域、页面上下文、字体、空间结构和字形变化。分别在 page-level 与 crop-level 粒度训练,在 printed 和 handwritten 泰语文档上评估。最终用 45,723 张合成页面适配 PaddleOCR-VL-1.6。
关键发现
- 非文本上下文 几乎无一致影响;字体多样性、二维结构、真实手写字形显著提升迁移。
- 训练粒度改变源域匹配效应:page-level 下 in-domain 重建 达到 1.82% median CER,接近真实打印监督的 1.31%;crop-level 下 in-domain 重建(15.59%)反而不如 out-of-domain 重建(5.52%)。
- 最终模型在打印页 median CER 从 6.64% 降至 1.24%,手写从 74.87% 降至 20.55%,且在所有五个评估集上超过 Typhoon OCR v1 7B。
与基线对比解读
合成数据若只覆盖单一域,crop-level 训练易过拟合,多样性不足;page-level 训练迫使模型利用二维布局,in-domain 重建因此能逼近真实监督。但 crop-level 下 out-of-domain 重建 提供更广泛字形与背景变化,更鲁棒。这说明 数据构造策略比模型容量关键:0.9B 模型通过精心设计的合成数据超越 7B 基线。
行业影响
落地场景
该工作展示了纯合成数据在泰语 OCR 上的有效性,适合缺乏标注数据的小语种场景。可直接应用于需要处理泰语文档的产品,例如:
- 电商平台对商品图片、收据、订单截图进行文字提取与结构化;
- 内容平台对泰语 PDF、用户上传图片建立可搜索索引;
- 企业服务中的合同、发票、表格自动录入,以及手写笔记数字化。 模型基于 0.9B 参数的 PaddleOCR-VL-1.6,推理轻量,可部署在云端或移动端。
商业价值
- 降本:合成数据生成替代昂贵人工标注,仅用 45,723 张合成页面将打印 CER 从 6.64% 降至 1.24%,标注成本几乎为零,且训练管线可复制到其他小语种。
- 增收/体验:高准确率减少人工校验,提升自动化流程效率;支持手写体(CER 74.87%→20.55%),扩展至表单、笔记等增量场景。
- 竞争壁垒:小模型(0.9B)性能超越 7B 级 Typhoon OCR v1,降低推理成本,适合大规模商用。
与现有产品/工作流的接口
- 模型基于 PaddleOCR 生态,可无缝替换现有 PaddleOCR 流水线中的文本识别模块,无需改动前后处理。
- 支持页面级与 crop 级推理,可适配不同文档布局分析(DLA)输出,与主流 MLOps 工具链集成。
- 合成数据生成管道(文档重建 + 字体多样性 + 二维结构 + 真实手写字形)可作为数据增强模块,嵌入现有 OCR 训练流程,持续迭代新语种。
局限
- **语言与场景单一性**:本研究只针对泰文 OCR,且主要覆盖打印和手写文档,未涉及复杂版式、多语言混排或低质量扫描图像。合成数据管道依赖泰文字体库和手写字形库的构建,这些资源在其他语言(尤其是低资源语言)中可能难以获取,导致方法泛化性受限。论文对非泰文场景的适用性讨论不足,若需迁移到其他文字系统,需重新设计字体和字形渲染流程,工作量较大。
- **手写性能仍存在显著差距**:尽管手写 CER 从 74.87% 降至 20.55%,但绝对错误率依然偏高,与打印场景的 1.24% 形成鲜明对比。手写字形库的规模和多样性可能不足,无法充分覆盖真实手写中的连笔、倾斜、笔画变形和噪声。此外,模型对手写文本的行分割与字符切分可能仍不鲁棒,导致后续识别错误累积。这一局限表明合成手写数据还有很大改进空间。
- **对比实验与模型选择有限**:论文主要与 Typhoon OCR v1 7B 对比,未纳入更多主流泰文 OCR 系统或使用真实标注数据训练的强基线。基础模型采用 PaddleOCR-VL-1.6,其预训练知识和架构可能对结果有重要影响,而论文未探索其他基础模型或结合少量真实数据的半监督策略,可能限制了性能上限。此外,合成数据仅覆盖有限页面布局和噪声类型,真实文档中的复杂背景、光照变化和扫描伪影未充分模拟,导致模型在实际部署时可能退化。