音频-视频模型中的注意力三角
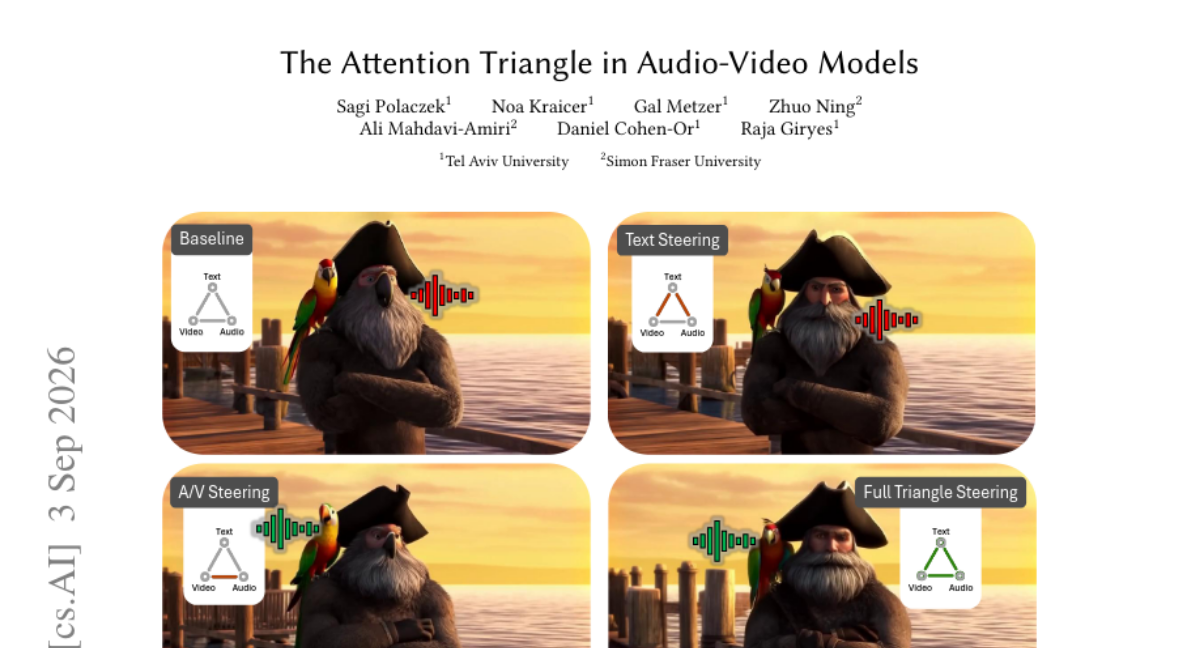
音频-视频扩散模型依赖跨模态注意力来协调文本、声音与视觉内容,但这一机制也可能导致微妙且系统性的语义泄漏。我们通过探测和分析连接文本、音频与视频三个流的跨注意力边构成的“注意力三角”,研究生成过程中语义信息如何跨模态路由。 分析揭示,音频-视频边上的路由是双向的:音频可影响视频生成,视频也可影响音频生成。该边受模型参数中编码的偏差影响,是泄漏的主要来源:当提示与所学先验相冲突时,跨模态交互可能覆盖预期条件,将语义重新路由至视觉上典型但错误的结果。这些效应表明,语义伪影不仅源于注意力扩散至预期目标之外,更源于沿特定路径的结构化、偏差驱动交互。 基于此视角,我们提取注意力信号,揭示语义如何跨模态分布和锚定,并将其用作诊断工具:既分析泄漏,也用于在受控条件下诱发泄漏。这使我们能够探测跨模态路由的内部动态,并分离个别交互的作用。我们进一步利用这些信号指导推理时干预,促进更一致的跨模态对齐。大量实验支持我们的分析,表明该方法在提升语义锚定的同时保持生成质量。
论文精读
TL;DR 揭示音视频扩散模型的“注意力三角”导致双向语义泄漏,并提出基于注意力信号的推理时干预,改善跨模态对齐且不损生成质量。
问题
音频-视频扩散模型 (audio-video diffusion models) 近年成为跨模态生成的核心方向,依赖 cross-modal attention 实现文本、音频与视觉的对齐。
现有方法主要借鉴文本到图像扩散中的 attention 操控(如 Attend-and-Excite 或注意力重加权),重点约束 text→image 的注意力分布。但音频-视频模型中存在 Attention Triangle:text→audio、text→video、audio↔video 三条边。其中 audio↔video 是双向且受参数偏差驱动,仅调整文本边无法阻断音频与视频之间的语义泄漏;之前的诊断工具也缺少对这条边的一阶/二阶注意力信号分析,导致“看起来合理但语义错位”的失败模式难以定位。
难点在于:跨模态路由发生在高维潜在空间中,audio↔video 的相互影响无法通过单一模态的 mask 或手动 prompt 约束直接消除;同时该方向关系到 生成一致性 和 可操控性,对虚拟人、自动配音、多模态内容生成等落地场景影响直接。
行业类比:类似于多模态大模型内部共享语义总线,但不同模态的解码器各自维护路由表,一旦路由表存在偏置,用户指定“鹦鹉说话、海盗出镜”会被重定向为“海盗说话、海盗出镜”这类典型但错误的结果。
核心洞察
- 该论文将音频-视频扩散模型中的跨模态注意力重新建模为文本、音频、视频三者之间的注意力三角形,指出音频-视频边是双向语义泄漏的主要通道。与以往大多只关注文本到图像注意力操控的工作不同,作者发现音频-视频边受模型参数中编码的先验偏置强烈驱动,当提示词与先验冲突时,跨模态交互会覆盖预期条件,将语义重路由到视觉上符合先验但错误的输出。这一结构化通路视角超越了简单的注意力扩散解释,为诊断和干预提供了明确靶点。
- 作者提出用注意力派生信号作为诊断工具,可主动诱发受控泄漏并追踪语义在模态间的分布与接地。这一方法不仅用于分析,还直接指导推理时干预:通过操控音频到视频、文本到音频和视频等边上的注意力权重,无需重新训练即可改善跨模态对齐。与常规的注意力重加权或梯度引导方法相比,该工作强调基于三角形结构的多边协同调节,从而在恢复正确语义接地的同时保持生成质量,扩展了推理时干预在音视频生成中的应用边界。
方法
方法核心
该方法针对文本到音视频(T2AV)扩散模型,将跨模态注意力建模为 注意力三角形,三个顶点分别为文本、音频、视频,三条交叉注意力边连接三者。
输入:文本提示 prompt、噪声潜在表示(视频帧与音频谱图)以及预训练模型的交叉注意力图。
关键模块:
- 注意力三角形剖析:对三条边(
text→video、text→audio、audio↔video)分别提取注意力信号,包括一阶和二阶注意力可视化。重点考察audio↔video边,发现其路由是双向的——音频可影响视频生成,视频也可影响音频生成,且该边受参数中编码的先验偏差影响。 - 泄露诊断:利用注意力导出的信号,在受控条件下故意诱发语义泄漏,暴露语义如何在模态间分布与接地。实验表明,泄漏不是简单的注意力扩散到目标之外,而是沿特定路径的 结构化、偏差驱动交互——当提示与学到的先验冲突时,跨模态交互会覆盖预期条件,将语义重路由到视觉上规范但错误的结果。
- 推理时干预:基于诊断结果,设计可调锚点(anchor)与边权重,分别对
audio↔video边、text→video和text→audio边进行约束,超参数如λ(音频-视频边强度)、β/γ(文本边强度)以及音频掩码阈值θ_A控制干预力度。干预目标是鼓励跨模态对齐,同时不损害生成质量。
输出:修正后的生成结果,例如 Ours-Text 只修复外观泄漏、Ours-AV 只修复声源定位、Ours-Full 联合修复两者。
跟同类方法差异:现有注意力操控多在图像扩散模型中处理单模态泄漏,而本方法首次在音视频联合生成中显式建模三边注意力路由,并将问题定位为偏差驱动的结构化交互,而非简单的注意力溢出。
实验
实验设计与分析
作者在 audio-video diffusion models 上系统分析 注意力三角(attention triangle),涉及三条 cross-attention 边:text→audio、text→video、audio↔video。通过可视化 一阶注意力(first-order attention)和 二阶注意力(second-order attention),追踪语义在模态间的路由。构造 Leakage Challenge Set,使用与模型先验冲突的提示(如“pirate with parrot”场景),诱导泄漏。
关键发现
- 音频-视频边 是双向的,由模型参数中的偏置塑造,是语义泄漏的主要来源。
- 当提示与学习到的先验矛盾时,跨模态交互会覆盖原本条件,将语义重路由到视觉上典型但错误的结果(例如 pirate 获得 parrot 外观并成为声源)。
- 通过提取注意力派生信号,作者设计了 inference-time steering 干预:分别针对外观泄漏(Ours-Text)和语音定位错误(Ours-AV),以及联合干预(Ours-Full)。
与基线对比
对比 baseline T2AV,Ours-Text 恢复 pirate 外观但语音仍误定位;Ours-AV 正确将语音定位到 parrot,但外观泄漏仍在;Ours-Full 同时修复外观和语音定位,且在保持生成质量的前提下提升跨模态对齐。消融实验分析了超参数 λ(audio-video edge)、β/γ(text edges)和阈值 θ_A 的影响,验证各组件必要性。
行业影响
落地场景
- 短视频/广告生成: 多模态扩散模型生成带语音的商品展示、角色动画等,泄漏会导致语音与视觉对象错位(如人物口型与声源不符),修复后可满足商用交付。
- 虚拟主播/数字人: 音频驱动视频生成时,确保语音来自正确角色,避免视觉语义被先验覆盖。
商业价值
- 减少 人工审核成本: 自动修复语义错位,降低返工率。
- 提升 内容信任度与转化率: 电商产品视频中语音属性与画面一致可增强消费者信心。
- 支持 实时生成服务: 推理期干预无需重训,适合低成本上线。
与现有工作流集成
- 在现有 T2AV 扩散模型推理阶段加入
attention steering模块:从交叉注意力图提取信号,对音频-视频、文本-音频、文本-视频边分别施加 mask 或权重约束。 - 可作为 插件 形式接入 ComfyUI / Diffusers 等生成框架,与 LoRA、ControlNet 等并存。
- 诊断工具可集成到 质量评估 pipeline,自动检测泄漏并触发重生成或后处理。
局限
- 该方法高度依赖模型内部 cross-attention map 的可访问性和可解释性,并非所有音频-视频扩散模型都公开或允许抽取注意力权重;推理时干预引入了多个超参数(如 λ, β, γ, θA),需要针对不同模型和提示进行单独调优,实际部署时可能增加标定成本,限制了开箱即用性。
- 论文的评估主要基于特定自动指标(如 Qwen Source-Attribution Score、VA-Judger)和定制的 Leakage Challenge Set,可能无法完全覆盖真实世界场景的多样性;用户研究规模未明确披露,其统计效力有限,且缺乏与训练阶段改进方法的直接对比,无法证明推理时干预是解决参数偏置的最优路径。
- 注意力三角分析框架将跨模态交互简化为三个交叉注意力边,可能忽略了自注意力、MLP 或其他归一化组件在语义路由中的贡献;此外,在推理时修改注意力图可能对生成多样性和创意性造成潜在抑制,尤其在长视频或高度复杂提示下的稳定性和鲁棒性尚需进一步验证。