展开世界:在强化空间推理中分解4D属性
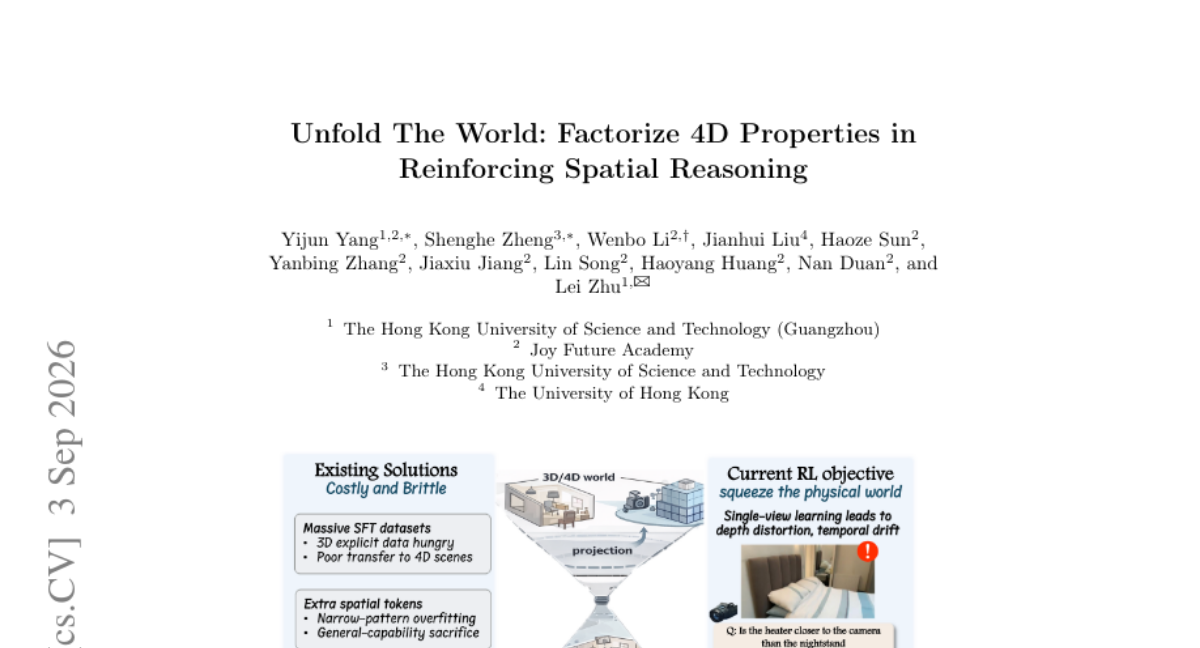
尽管视觉语言模型(VLMs)在多模态任务中表现出色,但它们在物理世界推理中仍是“扁平”的。这种空间瓶颈源于维度不匹配:VLMs 训练于2D投影,而真实空间推理需要恢复潜在的3D几何和时间连续性。 为解决这种高维复杂性,我们提出从整体学习转向“分而治之”范式。我们提出 FactoSR,一种因子化强化学习框架,显式解释视觉投影压缩的维度。核心上,FactoSR 将世界一致推理的整体问题分解为三个正交的几何子目标:平面一致性(XY)、深度一致性(Z) 和 时间可逆性(T)。通过优化这些可验证约束,不适定的投影恢复问题被转化为一系列可解释的推理步骤。 在统一策略学习机制中,我们优化上述约束。在多项多视角和视频基准上的广泛评估表明,这种优雅分解显著提升了3D和4D推理能力,在 VSI-Bench 上提升 5.9%,在 All-Angles-Bench 上提升 4.5%。 我们的发现表明,强化显式、因子化的4D一致性是推动 VLMs 成为稳健的世界感知推理者的关键一步。
论文精读
TL;DR FactoSR 将 4D 空间推理分解为平面、深度、时间一致性三个可验证子目标,用强化学习统一优化,在多视角与视频基准上显著提升 3D/4D 推理。
问题
问题背景
随着 Vision-Language Model (VLM) 在通用多模态任务上逐渐成熟,研究焦点转向其 空间推理 与世界理解能力,尤其是从多视角图像与视频中恢复 3D 几何结构与时间连续性。
现有方法局限
主流 VLM 主要基于 2D 图像-文本对训练,空间判断停留在平面投影层面,未显式建模被投影压扁的深度信息。常见的整体式监督微调或 RL 只优化最终答案正确性,奖励信号对几何误差不敏感,且无法提供分解后的可验证约束。例如,在 VSI-Bench 等基准中,模型能识别物体却常混淆方位或视角关系。与 FactoSR 的因子化设计相比,传统方法把平面关系 XY、深度一致性 Z、时序可逆性 T 耦合在一起,优化困难且泛化性不足。工程启示:空间推理不应作为单一黑箱任务训练,而应拆解为可独立计算的子目标。
为什么这个问题难且重要
从 2D 投影恢复潜在 3D 几何与时间连续性是病态逆问题,单个 2D 视图对应无穷多 3D 场景,缺乏天然监督。大规模 3D/4D 标注成本极高,如何利用可自动生成、可验证的几何约束成为关键。业界对 具身智能、自动驾驶 与视频世界模型的投入持续加大,空间推理是这些应用的基础能力。工程启示:将几何先验转化为可扩展的奖励信号,能显著降低对人工标注的依赖。
行业类比:类似自动驾驶中从单目摄像头构建 BEV 表示,需要把感知任务分解为可验证的几何损失,而非端到端黑箱拟合。
核心洞察
- 分解几何子目标将不可逆的 2D 投影恢复转化为可验证的多维约束优化,使空间推理从端到端黑箱变为可解释、可奖励的策略学习。与依赖大规模 3D 监督或隐式特征对齐的基线不同,FactoSR 显式建模 `XY` 平面、`Z` 深度和 `T` 时间三个正交维度,让模型分别掌握视角对应、深度一致性和运动可逆性。这种“分而治之”避免了单一模型同时学习高维耦合表示的困难,将 ill-posed 问题拆解为一系列可独立验证的步骤,更符合人类认知分解方式,也为后续诊断和改进提供了明确接口。
- 强化学习被重新定位为优化几何一致性奖励而非人类偏好,使得空间推理能力可以从无标注的多视图和视频数据中自举。传统 RLHF 对齐偏好需要昂贵的人类反馈,而 FactoSR 利用几何约束本身作为奖励信号(如循环一致性),对策略进行验证驱动学习。这使得模型在训练中不断被鼓励产生满足物理一致性的输出,从而在 **VSI-Bench** 和 **All-Angles-Bench** 上取得 5.9% 和 4.5% 提升,证明显式可验证奖励是提升 VLM 世界模型能力的有效途径。
方法
核心思想
FactoSR 是一种因子化强化学习框架,用于提升视觉语言模型(VLM)的 3D / 4D 空间推理能力。其核心是将整体式学习(monolithic learning)转换为“分而治之”范式,显式解耦视觉投影中塌缩的维度。
输入与问题定义
VLM 接收 2D 图像或视频帧,但缺乏对潜在 3D 几何和时序连续性的显式建模。空间推理瓶颈源于维度不匹配:模型仅学习 2D 投影对应,却需恢复 3D 结构及时间一致性。
关键模块:因子化空间强化学习
FactoSR 将世界一致性推理分解为三个正交几何子目标:
- 平面对应(XY):约束多视图或序列中物体在图像平面内的位置对应关系,保证 2D 投影一致性。
- 深度一致性(Z):约束深度估计或立体匹配的一致性,促使模型恢复第三维几何。
- 时间可逆性(T):约束视频序列的正向与反向推理结果一致,捕捉时序连续性。
每个子目标均定义了可验证的约束条件(如通过多视图匹配、深度图比较、时间反演一致性检查),作为强化学习中的奖励信号。VLM 作为策略网络,其动作是生成空间推理步骤;奖励通过子目标满足程度计算,训练使用因子化策略梯度分别优化各维度,将不适定的投影恢复问题转化为一系列可逐步优化的推理步骤。
输出与效果
优化后的 VLM 在推理时能融合三维几何与时序信息,在 VSI-Bench 和 All-Angles-Bench 上分别提升 5.9% 和 4.5%。
与同类工作的差异
与现有整体式学习(如直接微调 VLM 预测 3D 属性)不同,FactoSR 通过显式分解维度并提供可验证的几何约束作为监督信号,有效避免了高维空间中的优化困难,提供更可控、更可解释的训练路径。
实验
实验设计
FactoSR 在 multi-view 与 video benchmarks 上进行评估,重点验证因子化强化学习框架对空间推理的提升。实验将 planar correspondence (XY)、depth consistency (Z)、temporal reversibility (T) 作为正交约束,通过统一策略学习分解投影恢复问题。
关键发现
- 在 VSI-Bench 上实现 +5.9% 提升,在 All-Angles-Bench 上实现 +4.5% 提升。
- 结果表明显式分解 4D 一致性有效提升 3D 与 4D 推理能力,缓解 VLM 的 “flat” 空间瓶颈。
基线对比解读
相较于 monolithic 学习范式,FactoSR 的 divide-and-conquer 策略将 ill-posed 投影恢复转化为可验证的步骤,从而获得稳定增益。提升幅度虽非巨大,但验证了几何因子化作为空间推理优化方向的可行性,为后续 VLM 世界建模提供参考。
行业影响
落地场景
FactoSR 将空间推理分解为 XY 平面、Z 深度、T 时间可逆性三组可验证子目标,对需要理解 3D 结构与运动一致性的场景直接适用:
- 电商商品展示:虚拟试穿、家具摆放预览中,模型需判断物体在空间中的相对位置与遮挡关系,减少视觉错位投诉。
- 视频内容平台:自动检测用户上传视频中违反物理常识的片段(如物体突然消失、深度关系错误),辅助审核与推荐排序。
- 自动驾驶仿真与监控:多视角摄像头画面中验证目标在时序上的一致深度与平面位置,提升感知模型在 corner case 下的可靠性。
商业价值
- 降本:用强化学习自动生成空间一致性奖励,替代昂贵的 3D 标注数据,降低训练成本。
- 提效:在 VSI-Bench 和 All-Angles-Bench 上分别提升 5.9% 与 4.5%,意味着现有产品可快速获得空间推理能力,无需重新设计模型架构。
- 体验升级:更准确的空间理解直接改善 AR 试戴、室内设计等交互产品的沉浸感,降低退货率与客服压力。
与现有工作流集成
FactoSR 可作为 VLM 后训练阶段的 RL 微调插件 接入:
- 在已有多模态模型(如 LLaVA、Qwen-VL)的特征提取器后接策略头,分别计算三个几何子目标的奖励。
- 奖励函数均为可验证的几何约束(如重投影误差、时序反向一致性),可与现有 RLHF 基础设施(如 TRL、OpenRLHF)兼容,无需额外环境模拟。
- 对数据要求轻量,仅需多视角或视频片段,方便企业复用现有视觉语料。
作者观点:强化显式因子化的 4D 一致性是让 VLM 成为“世界感知推理器”的关键一步,意味着空间推理可以从单点能力升级为可泛化的基础组件。
局限
- - **基准与场景覆盖局限**:论文主要在 **VSI-Bench** 和 **All-Angles-Bench** 上验证,二者侧重多视角静态图或有限视频,缺乏真实世界动态环境中的遮挡、光照变化、物体交互测试。未报告在 **MMMU**、**Video-MME** 等通用 VLM 基准上的性能,无法判断 factorized RL 训练是否损害通用多模态能力。此外,没有在 embodied AI、机器人操作等下游任务做迁移实验,泛化证据偏弱。
- - **几何分解的完备性不足**:将 4D 一致性硬性分解为 XY / Z / T 三个子目标,可能过度简化空间推理。现实场景还涉及物体恒常性、遮挡补全、相对关系与多物体交互等高阶语义,这些难以被三个几何约束完全覆盖。奖励依赖可验证的几何信号,对自然语言中的模糊空间描述(如“左侧偏后”)可能失效,限制了开放域空间推理的训练信号质量。
- - **训练代价与数据依赖**:同时优化三个子目标增加了 RL 训练复杂度,且需要多视角几何、深度真值或时序对应等高质量标注。论文未明确数据规模与来源,若主要依赖合成数据,存在 **sim-to-real gap**。当前开源代码 star 数较低,社区尚未充分复现,实际工程部署的稳定性与可扩展性仍待验证。