FlashRender:基于相机控制视频 MeanFlow 的少步生成式渲染
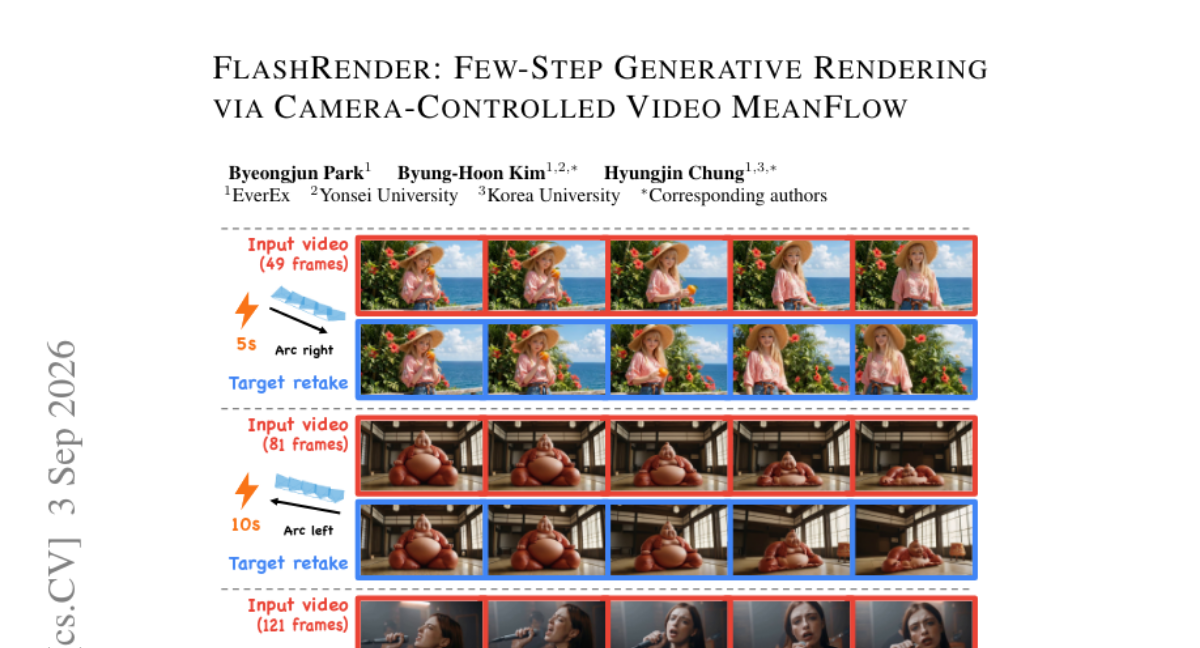
我们提出 FlashRender,一个少步生成式渲染框架,可在数秒内沿着目标相机轨迹重渲染源视频。我们发现采样步数依赖的相机控制是现有多步生成式渲染模型中离散化误差的显著表现,并指出解决这种不一致性可大幅降低去噪轨迹的曲率,从而便于后续的步数蒸馏。为此,我们引入 表示变换与对齐 (RETA),将源视频的隐藏表示与来自冻结视觉几何模型的目标视频特征对齐,从而在源视频流中直接编码几何变换,实现采样步数一致的相机控制。 然后,我们在 RETA 诱导的低曲率去噪轨迹上使用 MeanFlow 目标微调模型,使模型能更有效地处理离散化误差。最后,我们应用在策略流图蒸馏来修正固定少步采样下的自展误差。大量实验表明,RETA、MeanFlow 和在策略流图蒸馏在少步生成式渲染中发挥互补作用。三者结合,使我们的方法在 25 倍更低采样成本下达到与多步基线相当的视频质量和几何一致性,同时即使在分布外的目标相机轨迹下也能实现更优的相机可控性。
论文精读
TL;DR FlashRender 通过 RETA 对齐源视频表示与目标相机特征,消除采样步相关的相机控制误差,再结合 MeanFlow 与 on-policy 蒸馏,以 25 倍更低采样成本实现多步基线相当的生成渲染质量与更强相机可控性。
问题
相机控制视频生成领域近年聚焦生成式渲染(generative rendering),即对一段已有源视频按用户指定相机轨迹重新渲染,应用于电影制作、虚拟制作等场景。
现有方法多为多步扩散模型,存在两点局限:
- 采样步依赖的相机控制:同一目标轨迹在不同去噪步下注入的相机条件不一致,这是离散化误差的显著表现,导致去噪轨迹曲率偏高,难以进行后续步蒸馏。
- 高采样成本:达到可接受的视频质量与几何一致性通常需要大量采样步(如 25 倍以上计算开销),限制实时或交互式应用。
这一问题的难点在于:生成式渲染必须同时处理动态场景、遮挡和未知区域的新视图合成,对几何一致性要求严格;而少步采样下,离散化误差会被放大,若相机控制信号在不同步间不对齐,模型无法学到低曲率去噪路径,误差在自回归 rollout 中持续累积。因此,在保持视频质量与相机可控性的同时大幅降低采样步数,是当前生成式渲染走向实用的关键挑战。
行业类比:类似文本到图像扩散模型加速(如 LCM / Turbo)中降低轨迹曲率以支持少步采样,FlashRender 在视频渲染域将这一思想与显式相机几何对齐结合,为实时相机路径重渲染提供可能。
核心洞察
- 采样步依赖的相机控制不一致是少步生成渲染中离散化误差的关键来源。现有方法多关注于少步蒸馏或相机注入方式,却未显式对齐不同去噪步间的相机条件,导致去噪轨迹曲率较高,难以进一步压缩步数。FlashRender 提出 **RETA**,将源视频隐表示对齐到冻结视觉几何模型的目标特征,在特征流中直接编码几何变换,使每个采样步的相机控制保持一致,从而大幅降低轨迹曲率。
- **MeanFlow** 目标与 **on-policy flow map distillation** 形成互补,针对低曲率轨迹进一步减少离散化误差和 rollout 偏差。MeanFlow 在 RETA 诱导的低曲率轨迹上微调,让模型预测视频帧间平均光流,注入显式几何先验;随后 on-policy flow map distillation 利用少步采样下的自身 rollout 进行蒸馏,修正训练与推理分布不一致问题。这与常见的直接步蒸馏或 off-policy 蒸馏有本质区别,提高了少步生成下的几何一致性。
方法
方法流程
输入:源视频(多帧,含动态场景)与用户指定的目标相机轨迹(可包含离群视角)。
关键模块分为三个阶段:
RETA(Representation Transformation and Alignment)
将源视频的隐藏表示与来自冻结视觉几何模型的目标视频特征对齐,直接在源视频流中编码几何变换。该对齐使相机控制不再依赖去噪采样步数,消除了现有模型中的离散化误差表现,显著降低去噪轨迹曲率,为后续蒸馏创造条件。MeanFlow 微调
在 RETA 诱导的低曲率去噪轨迹上,用 MeanFlow 目标微调模型。MeanFlow 通过平均流约束让模型更有效地处理离散化误差,提升少步采样下的去噪质量。On-policy flow map 蒸馏
固定少步采样配置,用模型自身 rollout 生成的样本计算流图损失,纠正自回归误差,进一步稳定输出几何结构。
输出:沿目标相机轨迹重新渲染的视频,仅需极少采样步数(摘要提到约 25 倍成本降低)。
与直接对多步模型做步长蒸馏的同类方法不同,FlashRender 先通过 RETA 消除采样步长依赖的相机控制不一致,再用 MeanFlow 和 on-policy 蒸馏联合优化,实现低采样成本下的高保真重渲染。
实验
实验设计
论文评估 FlashRender 在少步生成渲染任务上的表现,重点验证 RETA、MeanFlow objective 与 on-policy flow map distillation 三个组件的互补性。实验对比多步生成渲染基线,在视频质量、几何一致性及相机可控性上衡量性能,并额外测试了分布外目标相机轨迹下的泛化能力。
关键发现
- 采样步数大幅降低:FlashRender 以 25× 更低的采样成本达到与多步基线相当的视频质量和几何一致性。
- 相机控制更优:即使在 out-of-distribution 目标轨迹下,相机可控性仍优于基线。
- 组件协同:RETA 通过表示变换与对齐降低去噪轨迹曲率;MeanFlow 在低曲率轨迹上微调以更好地处理离散化误差;on-policy 蒸馏修正固定少步采样下的自回滚误差,三者缺一不可。
与基线对比
现有生成渲染方法多为多步采样,离散化误差导致采样步数依赖的相机控制不一致,进而造成高曲率去噪轨迹,不利于步数蒸馏。FlashRender 通过 RETA 直接从源视频流编码几何变换,实现采样步数一致的相机控制,从根本上降低曲率,使后续 MeanFlow 与蒸馏更有效。与直接蒸馏多步模型的方法相比,该框架避免了先验高曲率轨迹带来的误差累积,在少步设置下展现出更强的质量保持与泛化能力。
行业影响
落地场景
FlashRender 将多步生成式渲染压缩至少数步(采样成本降低 25×),可直接用于 视频重渲染 场景:电商商品视频生成、影视预演、虚拟制作、短视频平台运镜重制。例如,电商商家上传一段商品展示视频,用户可交互式选择任意相机轨迹,实时生成新视角视频,实现“先拍后导”体验。
商业价值
主要价值在降本与体验提升:推理成本降至 1/25,使实时或准实时的视频视角合成成为可能,支撑云端 API 服务;用户无需重新拍摄即可获得目标运镜效果,提升内容生产效率与互动体验。相比多步 baseline 质量不降,且相机可控性更强,可转化为付费功能或差异化竞争力。
与现有产品/工作流的接口
FlashRender 可作为独立模块嵌入现有视频生成/编辑堆栈:输入源视频 + 相机轨迹,输出重渲染视频。可通过 REST API 或插件形式集成至视频编辑软件(如 DaVinci Resolve、Premiere)或云端 MLOps 平台。其少步推理特性适合边缘设备或低延迟服务,也可与现有扩散模型蒸馏管线结合,作为后续任务的前置模块。
局限
- 方法依赖冻结的视觉几何模型提供目标视频特征,当该模型在源视频内容上失效(如无纹理区域、强遮挡、动态模糊)时,**RETA** 的对齐可能引入错误几何先验,导致生成结果出现伪影或相机轨迹偏差。论文未对几何模型质量的敏感性进行定量消融,难以评估其鲁棒性边界。
- 训练流程为三阶段(多步渲染、**MeanFlow** 微调、on-policy 流图蒸馏),整体训练成本较高,且需要额外的教师模型或多步基线,实际部署门槛较高。此外,few-step 采样虽加速推理,但生成质量可能仍受限于教师模型的上限,在极端 **OOD** 轨迹或长序列上可能出现累积误差。
- 实验主要关注视频质量和几何一致性指标,未深入评估实时性、内存占用或与现有视频生成框架的集成便利性。对于电影制作等实际应用,对相机控制的精确度和可微调性有更高要求,**FlashRender** 可能还需要进一步验证,尤其是在用户自定义复杂轨迹下与专业级工具的差距。