PILOT in the Loop: 面向长视界智能体的实时自我改进
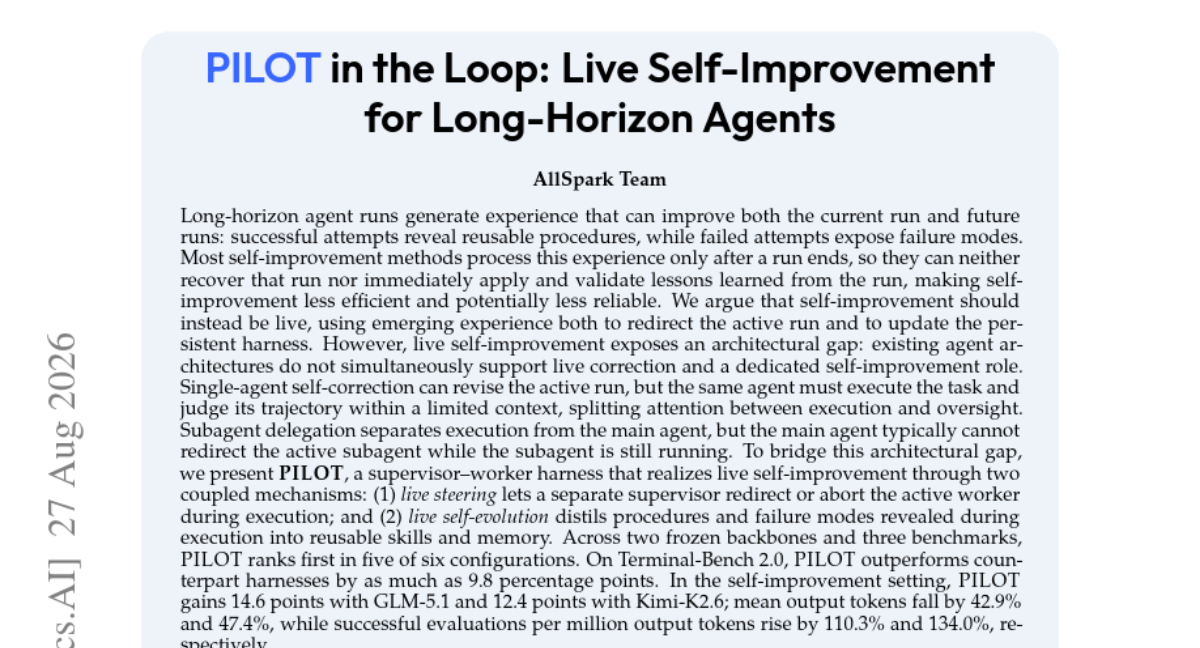
长视界智能体运行会积累经验,可用于改进当前与未来任务。然而,多数自我改进方法仅在执行结束后处理这些经验,因此无法重定向当前运行,也无法即时应用与验证从中获得的教训。我们主张将自我改进改为实时进行,利用运行中涌现的经验同时调整当前行动与持久化设施。 现有架构难以支持这一目标:单智能体自纠错将任务执行与轨迹评估合并在同一上下文,而子智能体委派虽分离执行,却通常无法重定向活动子代理。 为此提出 PILOT,一种 supervisor-worker 架构,通过两个耦合机制实现实时自我改进: 1. 实时操控(live steering):让独立 supervisor 在执行期间重定向或中止活动 worker; 2. 实时自演化(live self-evolution):将执行中暴露的流程与失败模式蒸馏为可复用技能与记忆。 在两种冻结骨干与三个基准上,PILOT 在六种配置中取得五次第一。在 Terminal-Bench 2.0 上比对照 harness 高最多 9.8 个百分点;自我改进设置中,GLM-5.1 提升 14.6 分、Kimi-K2.6 提升 12.4 分,平均输出 token 下降 42.9% 与 47.4%,而每百万输出 token 的成功评估次数分别提升 110.3% 与 134.0%。
论文精读
TL;DR PILOT 引入 supervisor-worker 架构,通过 live steering 实时纠正活跃 worker 并将执行经验蒸馏为可复用技能,在长程任务中显著提升准确率与 token 效率。
问题
问题背景
长时程智能体(long-horizon agent)在执行复杂任务时会产生大量轨迹经验,这些经验既能纠正当前运行,也能沉淀为后续可复用的知识。当前研究关注如何让智能体从自身运行中持续提升,同时保持运行过程的实时可控。
现有方法局限
大多数自改进方法仅在运行结束后才处理经验,存在两个明显缺陷:
- 无法重定向当前运行:运行时出现的偏离无法被及时纠正,只能等待失败后重新开始,浪费大量时间和 token。
- 经验应用滞后:从失败中提炼的教训无法立即验证,改进闭环被拉长,可靠性降低。
现有架构也无法同时支持实时纠正和专职自改进角色:
- 单智能体自纠正(single-agent self-correction)将任务执行与轨迹评估放在同一个上下文中,导致注意力分散,且上下文长度有限,难以兼顾执行与监督。
- 子智能体委派(subagent delegation)虽然将执行分离,但主智能体通常无法在子智能体运行过程中重定向或中止它,实时干预能力缺失。
为什么这个问题难/重要
技术挑战在于架构层面:需要一个独立的监督者角色,既要与执行者保持双向通信以实时干预,又要能将运行中暴露的流程和失败模式即时蒸馏为可复用技能与记忆。这要求设计全新的监督者-工作者协作机制,同时保持骨干模型冻结以降低推理成本。
业界对长时程任务的可靠性与效率关注度持续上升:在 Terminal-Bench 2.0 等基准上,PILOT 相比对照架构最高提升 9.8 个百分点,并在自改进设置下将成功评估密度提升超过 110%,说明实时自改进能显著减少 token 浪费、提高任务成功率。
行业类比
类似自动驾驶中的实时监控与策略更新:车辆运行中需要即时纠正偏离路线,同时将本次驾驶经验沉淀到全局策略,避免下次重蹈覆辙。
核心洞察
- 核心洞察:PILOT 将 self-improvement 从离线事后处理升级为在线实时干预,填补了单 agent 与 subagent 架构之间的空白。 与现有 baseline 相比,单 agent self-correction 受限于上下文长度和注意力竞争,subagent delegation 无法在 worker 运行时进行 redirect;PILOT 通过 supervisor-worker 分离和双向通道实现 live steering,允许 supervisor 实时调整或终止 worker,同时将执行中的经验即时蒸馏为可复用 skills 和 failure-mode memory。这种架构创新使当前 run 和未来 runs 同时受益,实验在 Terminal-Bench 2.0 上最高提升 9.8 个百分点。
- 关键洞察:live self-evolution 将单次 run 的经验转化为跨任务可复用的组织级资产,显著提升样本效率和 token 效率。 与仅关注本 run 修正的 self-correction 不同,PILOT 的持久化技能库和记忆库允许后续任务直接调用已验证的 procedures 和已知 failure modes,避免重复试错。在 self-improvement 设置下,PILOT 使用 GLM-5.1 和 Kimi-K2.6 分别提升 14.6 和 12.4 个百分点,同时平均输出 token 下降 42.9% 和 47.4%,成功评估每百万输出 token 提升 110.3% 和 134.0%,验证了经验积累的复用价值。
方法
输入与角色划分
PILOT 接收长程 agent 运行产生的经验流,包括成功程序与失败模式。系统划分两个独立角色:supervisor 负责监督与自我进化,worker 负责实际执行任务。两者通过持久状态(skills 与 memory)关联。
关键模块
- Live steering:通过双向通信通道,supervisor 在 worker 执行过程中实时观察轨迹,可发送指令重定向或中止当前 worker。监督与执行上下文分离,避免单 agent 自校正中的注意力竞争;相比 subagent delegation,可干预活跃子代理。
- Live self-evolution:从执行中持续蒸馏 reusable skills 和 memory。skills 捕获成功程序,memory 记录失败模式。蒸馏在运行期间进行,而非仅在结束后批量处理。
输出与闭环
输出包括两部分:当前运行的成功重定向结果,以及更新后的持久 harness(skills + memory)。更新可立即用于后续任务,形成 live self-improvement loop。实现上采用异步消息通道支持中断与重定向,使用 frozen backbone(如 GLM-5.1、Kimi-K2.6),无需微调。
与同类方法的差异:PILOT 首次同时支持对活跃运行的实时纠正和独立的自改进角色,克服了单 agent self-correction 上下文竞争和 subagent delegation 无法干预活跃子代理的限制。
实验
实验设计
在两个冻结 backbone(GLM-5.1 与 Kimi-K2.6)上评估 PILOT 与对照 harnesses 在三个长程 agent 基准上的表现,覆盖六种 backbone × benchmark 组合。基准包括 Terminal-Bench 2.0、SWE-bench 等。自改进实验进一步考察多轮迭代后的性能与 token 效率。
关键发现
- PILOT 在六个配置中五个排名第一。
- 在 Terminal-Bench 2.0 上,PILOT 最高超出对照 harness 达 9.8 个百分点。
- 自改进设置下,GLM-5.1 增益 +14.6 点,Kimi-K2.6 增益 +12.4 点。
- 输出 token 减少 42.9%(GLM-5.1)和 47.4%(Kimi-K2.6);成功评估/百万 token 提升 110.3% 与 134.0%。
与基线对比
PILOT 的优势源于 live steering 与 live self-evolution 的协同:
- 对照 harness 要么单 agent 同时执行与评估导致注意力分散,要么子 agent 委派无法实时重定向。
- PILOT 通过独立 supervisor 实时纠偏或中止 active worker,避免错误路径上的无效计算。
- 实时的经验提炼为可复用技能与记忆,降低后续任务重复推理成本,直接体现为 token 效率与成功率的同步提升。
行业影响
落地场景
PILOT 适合长程智能体任务,典型场景:
- 软件工程智能体:跨仓库 bug 修复、大型重构,supervisor 实时纠正错误路径,减少无效探索。
- 金融尽调 / 电商竞品分析:多步骤信息搜集与报告生成,监督者中途可重定向,保证交付质量。
- 企业级 RPA / 数据管道维护:长流程自动化中实时拦截失败,并将成功流程沉淀为可复用技能。
商业价值
核心收益来自 token 成本下降与成功率提升:
- 论文显示,PILOT 在 Terminal-Bench 2.0 上较同类 harness 最高提升 9.8 个百分点;self-improvement 场景 GLM-5.1 提升 14.6 分,Kimi-K2.6 提升 12.4 分。
- 平均输出 token 下降 42.9% / 47.4%,成功评估次数 / 百万输出 token 提升 110.3% / 134.0%,直接降低推理成本并提高吞吐。
- 减少人工干预,支撑更多自动化服务上线。
与现有产品/工作流的接口
无需重新训练模型,PILOT 基于冻结 backbone 以 harness 层实现:
- 可在 LangGraph / AutoGen 等框架上扩展 supervisor-worker 双向通信通道。
- 需持久化
skills和failure_memory,可对接向量数据库或键值存储。 - 与 CI / evaluation pipeline 结合,每次 run 的经验立即回写记忆库,形成持续自我进化 loop。
局限
- **架构依赖与计算开销**:PILOT 需要独立的 supervisor 持续监控并可能实时干预 worker,这引入了额外的 LLM 调用和上下文管理负担。在长 horizon 任务中,supervisor 的决策会消耗大量 token,且其判断质量受限于自身能力;如果 supervisor 频繁误判或干扰,反而可能降低 worker 效率。论文未报告 supervisor 额外调用的成本占比,也未讨论如何在低延迟场景下部署该架构。
- **实验范围与泛化性**:所有实验均基于两个 frozen backbone(GLM-5.1、Kimi-K2.6)和三个 benchmark(Terminal-Bench 2.0 等),未验证在其他模型规模、领域或真实企业级长流程任务上的表现。此外,live self-evolution 中的技能提取和记忆更新依赖特定 prompt 设计,对不同任务范式的迁移能力存疑;实验也未与更复杂的 multi-agent 记忆或反思框架做全面对比。
- **实时干预的副作用**:live steering 允许 supervisor 在 worker 执行中强制重定向或终止,但论文未讨论这种干预可能带来的负面效应,例如打断 worker 已接近成功的探索路径、破坏上下文连贯性,或导致 worker 对 supervisor 产生过度依赖。与事后修正相比,实时干预的可控性和安全性(如避免有害操作)需要更严格的保障机制,论文未提供相关分析。