Thinking on Shots:基于 Agentic Reasoning 的一致多镜头视频编辑
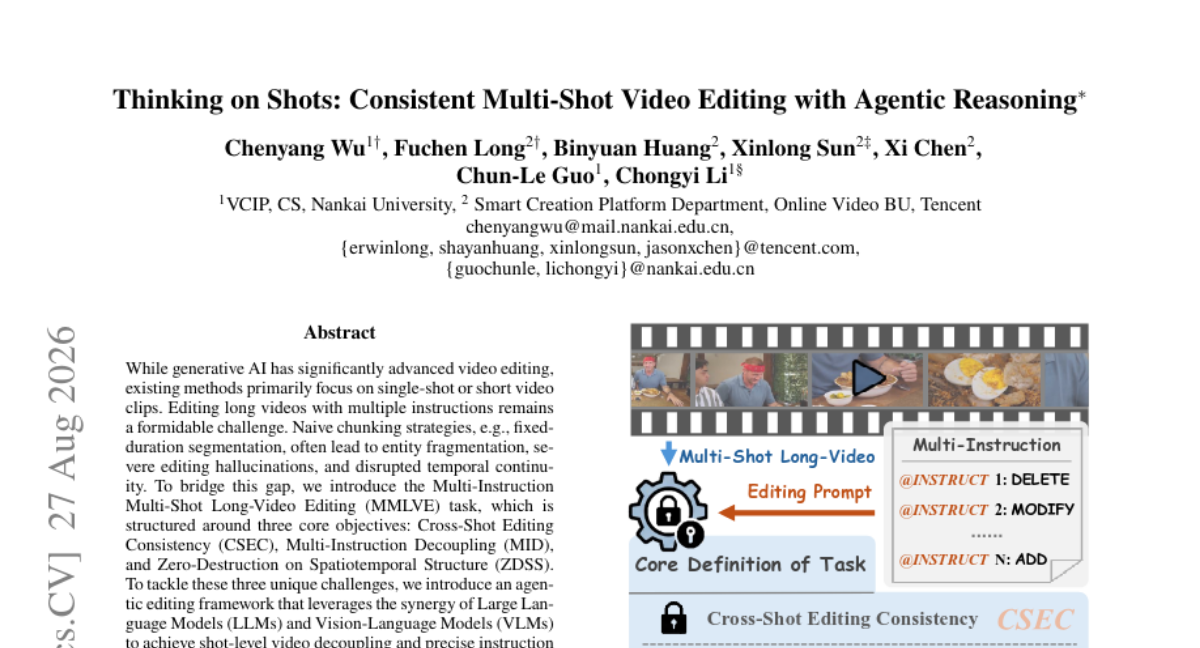
虽然生成式 AI 已显著推进视频编辑,但现有方法主要聚焦单镜头或短视频片段。使用多条指令编辑长视频仍是一项艰巨挑战。朴素的分块策略(如固定时长切分)常导致实体碎片化、严重编辑幻觉和时序连续性中断。 为弥合这一差距,我们提出了多指令多镜头长视频编辑(MMLVE) 任务,其围绕三个核心目标构建:跨镜头编辑一致性(CSEC)、多指令解耦(MID) 和时空结构零破坏(ZDSS)。针对这三项独特挑战,我们引入了一个代理式编辑框架,利用大语言模型(LLM) 和视觉语言模型(VLM) 的协同,实现镜头级视频解耦和精确指令解析。 为全面评估该任务,我们构建了 MMLVE-Bench 数据集,其特点是复杂的真实世界时空动态、高密度异构指令以及稀疏随机实体分布。进一步利用三个 MMLVE 评估指标 来评估编辑结果质量。大量实验表明,我们的 MMLVE-Agent 优于现有闭源 SOTA 方法(如 Seedance 2.0),成功消除了编辑幻觉,保持了跨镜头编辑一致性,并实现了无缝时空过渡。
论文精读
TL;DR 论文提出 MMLVE-Agent,用 LLM + VLM 的 agentic reasoning 对长视频做镜头级解耦与指令解析,解决跨镜头一致性、多指令串扰和时空结构破坏,指标超过 Seedance 2.0。
问题
问题背景
生成式 AI 推动视频编辑从单镜头短视频向多镜头长视频演进,用户希望通过自然语言在长视频中执行多条编辑指令。
现有方法局限
当前主流方案依赖固定时长分段(naive chunking),然后对每个片段独立编辑。这种做法暴露出三个核心技术缺陷:
- 实体碎片化:同一人物/物体出现在多个镜头时,分段边界会切割其视觉身份,导致跨镜头外观不一致。
- 编辑幻觉:模型可能把某条指令错误应用到不相关镜头,或凭空生成与源视频冲突的内容。
- 时空结构破坏:分段独立编辑破坏了镜头间的运动连续性、光影一致性和场景过渡,出现跳变或撕裂。
此外,多条指令之间缺乏解耦机制,容易在同一个镜头内叠加多个编辑意图,互相干扰。
为什么这个问题难且重要
技术上,长视频编辑需要同时完成镜头级解耦和指令级解析:先识别语义完整的镜头边界,再把每条指令准确绑定到目标镜头,同时保持未编辑区域的时空结构不变。这比单镜头编辑多了跨镜头一致性和全局结构保持的约束,对模型的长上下文理解和推理能力要求极高。
业界关注度集中在长视频生成与编辑的下游应用(如影视预演、广告素材生成、UGC 内容精修)。现有闭源 SOTA(如 Seedance 2.0)在长视频多指令编辑上仍会出现明显幻觉和一致性断裂,说明该问题尚未解决。
行业类比
类似自动驾驶中的长距离行为规划:需要把复杂任务分解到连续时空片段,并维持全局一致性,不能只对单帧或单段做独立推理。
核心洞察
- - 将长视频编辑任务重构为“镜头级语义解耦 + 指令映射”,通过 LLM/VLM 的代理推理在生成前完成高层规划。与朴素固定时长分块相比,该方法利用 VLM 识别镜头边界和实体分布,LLM 解析多指令并分配到对应镜头,从而避免实体碎片化和跨镜头实体不一致;这种推理先行、生成后置的设计,比直接扩展现有单镜头编辑模型(如 Seedance 2.0)更有效抑制编辑幻觉。
- - 提出 MMLVE-Bench 及三个专用评估指标(CSEC / MID / ZDSS),将长视频编辑质量分解为可量化的跨镜头一致性、指令解耦能力和时空结构保持度。以往评测依赖视觉质量或主观评分,难以反映多指令长视频编辑的真实失败模式;该基准构建了高密度异质指令、复杂时空动态和稀疏随机实体分布,使幻觉、实体错位和连续性破坏暴露为可度量信号,为后续研究提供了针对性优化目标。
方法
输入与任务建模
输入为长视频(多个 shot)与多条异构编辑指令。任务目标同时满足三个约束:Cross-Shot Editing Consistency(跨 shot 编辑一致性)、Multi-Instruction Decoupling(多指令解耦)、Zero-Destruction on Spatiotemporal Structure(时空结构零破坏)。
核心模块:Agentic Reasoning
MMLVE-Agent 通过 LLM 与 VLM 协同实现 shot 级解耦与精确指令解析:
- 视频 shot 解耦:VLM 检测镜头边界并理解各 shot 内容,将长视频分割为语义完整的 shot,避免固定时长切分导致的实体碎片化。
- 指令解析与分配:LLM 将多条用户指令解析为结构化编辑意图(目标实体、动作、作用 shot 范围),并与对应 shot 对齐,防止指令间相互干扰。
- 一致性维护:引入 Global Memory Card(全局记忆卡)记录跨 shot 的实体外观、身份和语义信息;在逐 shot 编辑时查询并更新该记忆,确保同一实体在不同 shot 中保持一致。
- 编辑执行:底层扩散视频编辑模型接收 shot 级结构化指令与记忆条件,生成编辑结果,同时保留原始时空结构。
输出
输出满足多指令、多 shot 要求的编辑后长视频,编辑幻觉被消除,跨 shot 过渡自然。
与同类方法差异
与固定分块或单 shot 独立编辑相比,MMLVE-Agent 将 LLM/VLM 推理显式引入编辑流程,以 agentic 方式完成 shot 解耦与指令对齐,而非简单分段后独立处理,从而在跨 shot 一致性和结构保持上显著提升。
实验
实验设计
论文构建了 MMLVE-Bench 数据集,覆盖复杂真实时空动态、高密度异构指令与稀疏随机实体分布。评测包含三种 MMLVE 专属指标,并结合用户研究与 VLM 判别器评估。基线包括闭源 SOTA 方法(如 Seedance 2.0),同时开展针对 P-NEF 模块的消融实验。
关键发现
实验表明 MMLVE-Agent 在长视频多指令编辑任务上优于现有闭源 SOTA,主要体现为:
- 消除编辑幻觉,实体跨镜头一致性得到保持
- 多指令解耦能力提升,不同指令间干扰显著降低
- 时空结构零破坏,镜头转场自然连贯
与基线对比
相比 Seedance 2.0 等采用固定切分策略的方法,MMLVE-Agent 利用 LLM 与 VLM 协同的 agentic reasoning 实现 shot 级视频解耦与精确指令解析,避免了 naive chunking 导致的实体碎片化和编辑幻觉。该方法在不牺牲时空结构的前提下,在多镜头一致性与无损性上形成明显优势。
行业影响
落地场景
长视频多指令编辑 适用于影视后期、广告素材迭代、电商产品展示、在线课程等内容生产。典型场景:影视公司对整集剧集进行角色服装替换、品牌植入或色调统一;电商平台对商品演示视频批量更换包装、Logo 或促销标语,无需逐镜头手动修改。
商业价值
将原来需要剪辑师逐镜头处理的多指令编辑任务自动化,显著降低人力成本与交付周期。跨镜头一致性和时空结构零破坏直接减少返工,提高内容审核通过率。对于规模化内容运营,例如流媒体平台批量替换广告位或季节性视觉元素,可支持每周数千条视频的快速迭代,扩大内容供给。
与现有工作流的接口
MMLVE-Agent 可作为智能调度层嵌入现有视频编辑管线:通过 API 接收自然语言指令与原始视频,内部使用 LLM/VLM 解析指令、划分镜头并调度下游生成模型(如 Seedance)执行编辑,最后输出编辑视频及编辑轨迹。适合与云端视频处理平台、MLOps 流水线或专业剪辑软件插件集成。需要标准化指令格式(如 JSON)以及提供镜头元数据回传功能,便于后续人工质检与二次编辑。
具体用例
- 电商场景:商家上传长版产品演示视频,要求“将所有镜头中的产品包装从蓝色改为绿色,并在前 3 个镜头添加限时折扣贴纸”。MMLVE-Agent 能自动识别产品实体、保持跨镜头颜色一致,同时不破坏人物动作。
- 流媒体内容运营:平台对已上传的 vlog 或短剧批量执行“替换背景中的季节元素、统一角色配饰颜色”等指令,保持叙事连贯性,用于广告定制或区域化版本生成。
局限
- - **依赖 LLM/VLM 推理上限**:方法中的 agentic reasoning 依赖 LLM 与 VLM 的协同推理,当视频包含高密度、语义冲突或隐含关联的编辑指令时,模型可能无法准确解耦或规划,导致编辑错误累积或遗漏。对于超出训练分布的复杂场景(如极端光照、遮挡、高速运动),VLM 的视觉理解能力可能不足,进而影响 shot 分割与指令绑定。
- - **数据集与评测维度有限**:MMLVE-Bench 虽然强调真实世界动态和高密度指令,但其规模与多样性尚未完全覆盖所有长视频编辑场景,例如不同领域(医疗、体育、监控)的特殊编辑需求。三个评估指标(CSEC、MID、ZDSS)主要关注一致性与结构保持,但未涉及语义保真度、用户主观满意度或细粒度时空对齐,可能高估实际编辑质量。
- - **计算开销与对比公平性**:agentic 框架需要多次调用 LLM/VLM 及视频编辑模型,推理延迟和计算成本较高,难以用于实时交互或资源受限环境。与闭源 SOTA(如 Seedance 2.0)对比时,闭源模型的内部机制和超参数不可控,无法保证其针对 MMLVE 任务进行充分优化,因此对比结果的绝对优势可能被高估。