VBVR-Pro:可扩展且可验证的原生视觉推理套件
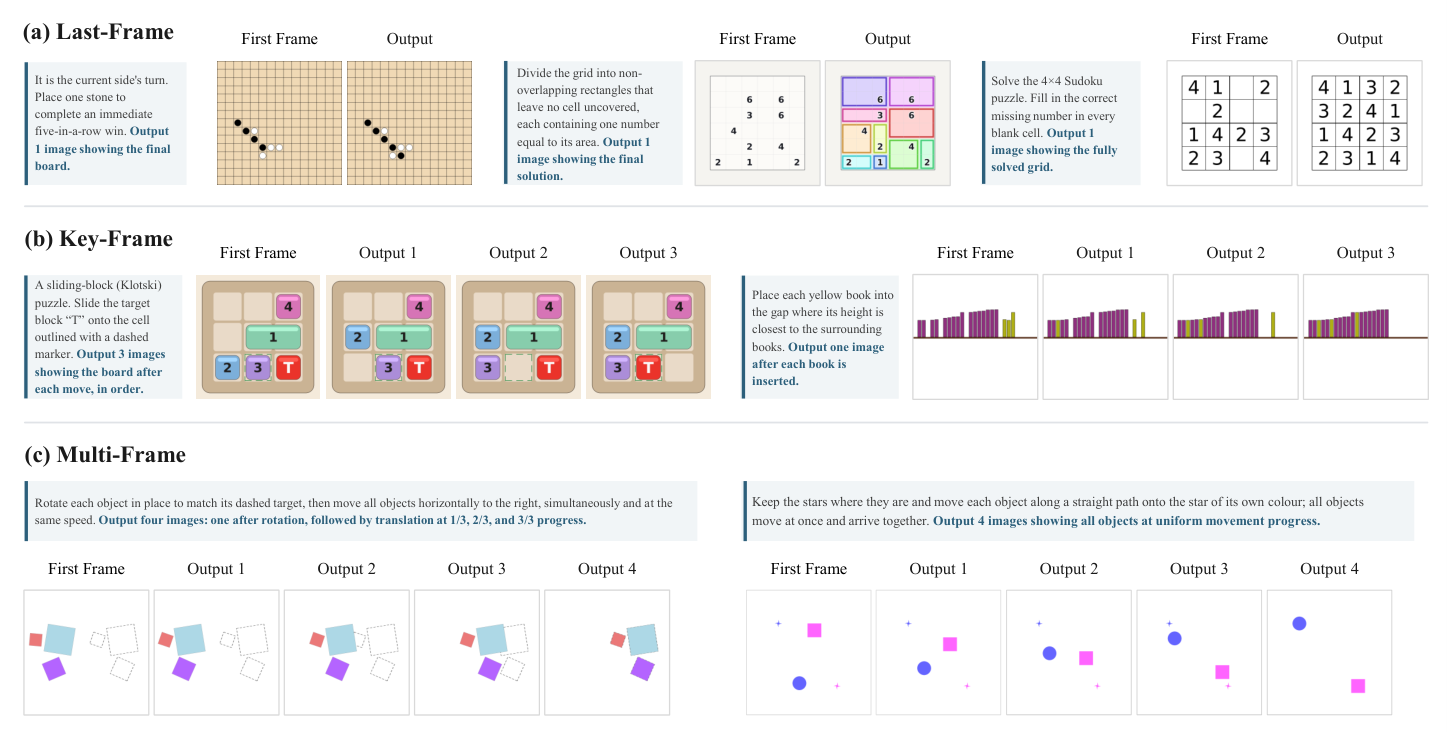
原生视觉推理将视觉生成本身作为推理的中介:视觉状态(即图像和视频)不仅是需要理解的输入或需要渲染的输出,而且是超越语言的、用于问题求解的一等基础。然而,该领域的进展仍受限于缺乏可扩展的训练任务、可靠的反馈以及跨生成媒介的受控比较。为此,我们提出 VBVR-Pro,一个闭环测试平台,使得通过生成进行原生视觉推理变得可训练、可验证、可优化且实验可控。 1. 任务扩展:VBVR-Pro 将视觉推理转化为包含 300 个程序化生成任务的受控任务空间。在 VBVR-Pro 上训练的模型展现出强大的迁移能力,在 RISE-Video、MME-CoF-Pro、BabyVision 等七个外部视觉推理基准上表现优异。 2. 可验证奖励:VBVR-Pro 提供可验证的奖励评分器,用于基于任务的评估。通过对主流 MLLM 作为评判者的系统研究,我们识别出当前“VLM-as-a-judge”范式的常见失败模式。相比之下,所提出的评分器基于确定性、任务特定的规则,能够与人类判断实现细粒度对齐,并且可作为大规模多任务强化学习的可靠奖励信号,在视觉推理任务上展现出更强的强化学习后性能。 3. 机制研究:VBVR-Pro 支持超过 30 种图像、视频和交错生成器的受控模态研究。我们的分析表明,视频生成在需要持续时空状态跟踪的任务中仍然最强,而交错生成提供了一种计算高效的替代方案。重要的是,消融和探测实验表明,存在对视觉推理至关重要的“视觉原生轨迹”。我们已发布所有数据、模型、评分器和代码。
论文精读
TL;DR VBVR-Pro 用 300 个程序化任务和确定性可验证奖励,让原生视觉生成推理可大规模训练与 RL 优化,发现视频生成擅长时空跟踪、交错生成更省算力,训练模型在七个外部基准均有提升。
问题
问题背景
当前多模态推理的主流范式仍以语言为中枢:视觉输入被编码为文本 token,推理在文本空间完成,输出也以文本为主。但在空间布局、持续状态跟踪等任务中,语言描述会丢失关键视觉细节,因此原生视觉推理开始把图像/视频生成本身作为推理介质。
现有方法局限
- 训练任务不可扩展:现有视觉推理基准多为静态、小规模,难以提供大规模 RL 所需的多样任务分布。
- 反馈不可靠:广泛使用的 VLM-as-a-judge 存在评分不稳定、对细微视觉差异不敏感等失败模式,难以作为可验证奖励信号。
- 基底比较失控:图像、视频、交错文本-图像生成器缺少统一任务空间,无法控制变量地判断哪种视觉基底更适合某类推理。
这些缺口导致原生视觉推理长期停留在 case demo 层面,难以进入可训练、可优化的工程闭环。
为什么难/重要
视觉状态空间高维且连续,生成正确的中间视觉状态远比选择文本 token 困难;同时,只有任务规则确定且可自动校验时,才能形成可靠奖励。业界对可验证奖励和多模态 RL 的关注度持续上升,因为它们是视觉推理 scaling 的关键前提,但视觉域的规则编写成本远高于代码或数学。
行业类比
类似代码生成中用单元测试作为可验证奖励,VBVR-Pro 为视觉生成任务提供确定性规则评分器,使原生视觉推理可以像代码 RL 一样闭环训练与优化。
核心洞察
- VBVR-Pro 用任务特定确定性规则评分器取代 VLM-as-a-judge,提供可验证奖励信号,消除评判噪声,驱动 RL 训练稳定收敛。与依赖语言模型评判的合成数据 RL 基线相比,该评分器与人类判断高度对齐,并显著提升后 RL 性能,解决了 VLM-as-a-judge 不稳定、失败模式频发的痛点。
- VBVR-Pro 将视觉推理任务参数化,通过程序化生成构建可扩展训练集,使模型在外部视觉推理基准上表现出强迁移。与现有静态基准不同,该套件将任务空间显式控制,训练出的模型在 RISE-Video、MME-CoF-Pro 等七个外部基准上表现优异,表明生成式视觉推理能力可以通过受控任务设计习得,而非仅拟合训练分布,为构建通用视觉推理模型提供了数据引擎思路。
- VBVR-Pro 的受控模态研究表明,不同生成模态在视觉推理中存在显著分工,且存在视觉原生轨迹。实验跨 30+ 图像、视频和交错生成器,发现 video generation 在持久时空状态跟踪上占优,interleaved generation 计算效率更高;此外,视觉轨迹监督比文本语义贡献更大,说明模型习得的推理路径内嵌于视觉状态,而非仅依赖语言描述。这为工程选型和模型监督信号设计提供了实证依据。
方法
输入与任务生成
VBVR-Pro 将视觉推理形式化为程序化生成的 300 个可控任务,覆盖物体操控、时空状态跟踪等推理原语。每个任务由生成器定义输入(如初始图像、指令文本)和输出规范(目标图像 / 视频序列)。
关键模块
- 程序化任务生成器:按任务设计分类法(taxonomy)合成训练样本与评测集,保证任务空间可扩展、可干预。
- 可验证奖励评分器:替代常见的 VLM-as-a-judge 范式,基于任务特定确定性规则(如像素级目标定位、轨迹匹配)计算奖励,与人类偏好高度对齐。
- 多模态生成基底:集成超过 30 种图像、视频、交错文本 - 图像生成器,用于研究不同视觉基底上的推理能力。
输出与训练闭环
生成器输出大规模多任务训练数据;评分器提供可靠奖励信号,用于 多任务强化学习(RL)优化生成模型。训练后的模型在外部基准(如 RISE-Video、MME-CoF-Pro)上表现迁移,且视觉轨迹监督比文本语义贡献更大。
差异点
与依赖语言模型评判或静态基准不同,VBVR-Pro 提供确定性、可验证的奖励与可控任务空间,使原生视觉推理可训练、可优化、可诊断。
实验
实验设计
VBVR-Pro 构建包含 300 个程序生成任务 的闭环 testbed,将视觉生成作为推理介质本身,覆盖图像、视频与交错文本-图像输出。训练与评测涉及 7 个外部视觉推理基准(如 RISE-Video、MME-CoF-Pro、BabyVision),并系统比较 30+ 图像/视频/交错生成器。奖励层采用可验证 scorer,基于任务特定确定性规则;强化学习阶段使用多任务 RL 以 scorer 为奖励信号。
关键发现
- 在 VBVR-Pro 上训练的模型在外部基准上表现强迁移,说明任务空间具有可转移性。
- 系统研究主流 MLLM 作为 judge 时发现重复性失败模式,VLM-as-a-judge 范式存在不稳定;而 verifiable reward scorers 与人类判断更一致,并在 RL 后带来更强任务性能。
- 模态消融显示,视频生成在需要持续时空状态跟踪的任务上仍最强,交错生成提供计算效率更高的替代。
- 探针与消融表明存在 视觉原生轨迹(vision-native trajectories),对视觉推理至关重要,且视觉轨迹监督比文本语义贡献更大。
与基线对比解读
相较于以语言为中心的视觉问答或图像生成评估,VBVR-Pro 将 视觉生成本身作为推理介质,填补了可训练、可验证、可调控的空白。传统 VLM-as-a-judge 依赖语言模型裁判,存在系统偏差;VBVR-Pro 的确定性 scorer 提供更可靠的 reward,使得大规模 RL 训练成为可能。从计算角度看,交错生成在精度与效率之间提供折中,为实际部署提供选项。整体上,该工作推动原生视觉推理从“评估”走向“可优化”,但需注意目前未披露具体算力开销与量化提升幅度。
行业影响
落地场景
VBVR-Pro 的可验证视觉推理能力可赋能多种产品:交互式内容生成平台(游戏/广告动态素材)、多模态 AI 助手(需要视觉推理的任务规划)、教育与培训模拟(物理过程可视化)、电商虚拟试穿/场景生成 等。其任务空间覆盖图像、视频、交错生成,适合短视频平台、设计工具、自动驾驶仿真等业务。
商业价值
该套件通过规则化奖励评分器 替代 VLM-as-a-judge,降低人工标注与模型评判成本,同时提升训练信号可靠性。在强化学习流程中,可减少对昂贵人类反馈的依赖,加速模型迭代。应用后能提升生成内容的物理一致性和逻辑正确性,改善用户体验,降低售后/纠错成本。对于内容平台,更精准的视觉推理能力可提升推荐物料质量和广告转化率。
与现有工作流的接口
可集成到现有 多模态训练栈:数据侧作为合成数据生成器,扩充推理监督样本;奖励侧作为自定义 reward function 接入 RLHF 框架(如 TRL、OpenRLHF);评估侧作为回归测试集,监控生成模型质量。支持图像、视频、交错模态,适配主流生成模型架构(DiT、自回归等)。代码与数据开放,便于定制化扩展。
具体落地 use case
- 电商虚拟场景生成:商家上传商品图片,模型生成商品在不同环境(如厨房、户外)中的视频或交错图文推理,展示物理交互(如液体倒入杯中)。VBVR-Pro 的可验证奖励确保生成内容符合物理规则,减少人工审核。
- 在线教育互动教学:针对科学课程,系统生成可交互的视觉推理题(如小球碰撞轨迹预测),学生作答后模型生成视觉解释。训练时使用 VBVR-Pro 的 300 个任务及奖励评分器,提升模型对学生答案判定的准确性,并生成个性化视觉反馈。
局限
- **任务空间与真实场景的 gap**:VBVR-Pro 包含 300 个程序生成任务,虽然提供了可控性和可验证性,但其任务多为规则定义的合成场景,与开放域视觉推理存在差距。这种合成性可能导致模型在 VBVR-Pro 上训练后,迁移到真实世界任务时性能下降,尽管在选定的外部基准上表现提升,但这些基准同样偏向结构化任务,未覆盖更广泛的自然图像和视频推理。
- **可验证奖励的泛化局限**:论文提出确定性规则 scorer 替代 VLM-as-a-judge,但这类 scorer 需要为每个任务单独定义规则,扩展新任务时人工成本较高,且规则可能无法捕捉开放式或主观推理的正确性。对于无法用简单规则判定的任务(如创意生成、开放式问答),这套框架难以适用,限制了向更广泛 native visual reasoning 任务的推广。
- **实验设置与模型规模限制**:机制的受控研究使用了 30+ 生成器,但 RL 训练和迁移实验可能受限于模型规模(未在超大模型上验证)和计算资源。此外,论文主要与开源模型对比,未系统比较闭源顶级模型;视觉原生轨迹的探测是间接的,尚缺乏直接证据表明这些轨迹是必要且充分的。