Lost in Compression: 提取式提示压缩器的受控跨语言审计
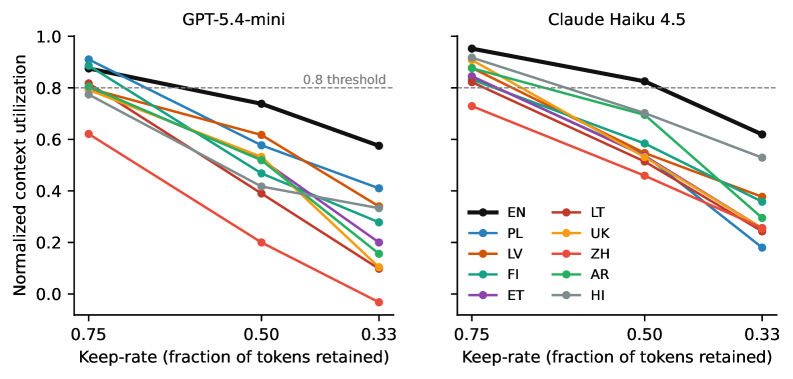
提取式提示压缩旨在通过移除低信息 token 来降低 LLM 推理成本,学习型压缩器(如 LLMLingua-2)在英文基准上表现强劲。然而,多数语言本就面临 token 溢价:相同内容所需 token 是英文的 1.3–1.8 倍。我们探究压缩是缩小还是拉大这一差距。 基于十种语言、五种文字的完全平行数据,并以目标模型 tokenizer 进行预算匹配控制,我们审计了四种学习型压缩器与四种确定性基线,覆盖十一家目标模型(来自十家厂商,超 250,000 次评估调用)。其中三个压缩器受英文监督训练(LLMLingua-2 XLM-R/mBERT、生产级 Kompress-v2),第四个 XProvence 为多语种训练。 实验发现: 1. 迁移差距真实存在,且强烈依赖保留率——在 0.33 保留率下,英文保留 57–62% 的归一化上下文利用率,立陶宛语仅 10–24%,中文几乎为零(尽管中文 token 溢价最小)。 2. 差距源于压缩监督数据而非架构:三个英文训练压缩器均表现出该问题,确定性方法无此差距,多语种训练的 XProvence v1 亦无;但其 v2 版本用翻译数据重训后,在激进阈值下清空了 92% 的中文上下文,且无任何警示。 3. 在更难的长上下文场景中,激进学习型压缩使三种非英语语言的压缩上下文效用降至无上下文基线或更低。先翻译后压缩流程在五种测试语言中的三种里,以约一半 token 成本达到或超越原生压缩效果。 我们公开全部代码、压缩结果与模型输出。非英语环境的安全压缩预算远小于英语。
论文精读
TL;DR 受控跨语言审计发现,英语训练的抽取式提示压缩器在非英语语境下性能大幅下降,扩大 token 成本差距;多语言训练和确定性方法可消除该差距,提示压缩预算须按语言调整。
问题
问题背景
提取式提示压缩通过移除低信息量 token 来降低 LLM 推理成本,在英语基准上表现良好。然而多数语言已有 token 成本溢价(1.3–1.8 倍),压缩是否缩小还是拉大这一差距成为关键问题。
现有方法局限
现有学习型压缩器(如 LLMLingua-2、Kompress-v2)主要基于英语监督训练,在多语言场景下出现明显的迁移差距:在 0.33 保留率下,英语上下文利用率保持 57–62%,立陶宛语仅 10–24%,中文几乎为零。该差距与架构无关,而与训练数据语言强相关。确定性基线(如基于词频/位置)虽无类似差距,但压缩质量上限较低,难以满足生产环境需求。
为什么这个问题难/重要
跨语言压缩的难点在于 tokenizer 本身的不平等:同内容非英语 token 更多,且压缩器需要在不同语言的分词粒度下保持语义完整性。同时,压缩率与性能退化呈强依赖,激进压缩可能导致非英语上下文被清空(如 XProvence v2 清空 92% 中文上下文),甚至引发模型拒答。业界普遍采用多语言 LLM 服务,压缩器的跨语言公平性直接影响成本和用户体验。论文在 11 个目标模型、10 种语言上超过 25 万次评估,揭示该问题在生产级系统中不容忽视。
一句行业类比
类似于多语言语音识别中,英语训练模型对非英语口音的识别率显著下降——压缩器若不考虑语言公平性,会在成本优化中系统性牺牲非英语用户体验。
核心洞察
- 跨语言压缩性能差距的根本决定因素是压缩器的训练监督语言,而非压缩模型架构或目标模型。论文对比三种英语监督压缩器(LLMLingua-2 XLM-R/mBERT、Kompress-v2)和一种多语言监督压缩器(XProvence v1),英语训练的压缩器在非英语语言上一致表现出显著差距,而多语言训练的没有;更换为 mBERT 骨干也无法消除差距。这说明问题不在表示能力,而在监督信号的语言覆盖。与以往仅关注英语 benchmark 的工作不同,本研究在受控平行语料和多种目标模型上首次隔离了监督语言变量。
- 压缩预算的安全阈值并非由 token 溢价大小决定,低保持率下非英语语言可能完全丧失上下文效用。中文的 token 溢价最小(1.3x),但在 keep-rate 0.33 时几乎无法保留上下文效用,而英语保留 57-62%,立陶宛语仅 10-24%。这意味着从业者不能根据 tokenizer 效率来推断压缩安全性;压缩率越高,跨语言差距越致命,非英语场景需要更保守的压缩预算或放弃压缩。该发现强调了逐语言校准压缩阈值的必要性,而非使用统一设置。
- 多语言训练可以消除差距,但使用翻译数据进行重训练可能引入新的脆弱性,导致部分语言上下文被异常清空。XProvence v1 多语言训练无差距,但其 v2 使用翻译数据重训后,在激进的阈值下清空了 92% 的中文上下文且无警告。这表明语言覆盖和多语言数据质量同样关键,翻译数据可能引入分布偏移。对工程实践而言,需要在部署前进行语言级别的监控和回归测试,不能仅依赖单一平均指标。
方法
输入与实验设计
- 构建十种语言、五种文字 的完全平行语料,覆盖不同 token 溢价;在目标模型分词器下进行预算匹配,确保压缩率可比。
- 被审计对象包括四类学习压缩器:LLMLingua-2(XLM-R 与 mBERT 骨干)、Kompress-v2(生产栈 Headroom)、XProvence v1/v2(多语言训练查询感知剪枝器),并搭配四种 确定性基线 作为对照。
- 目标模型共 11 个,来源十个厂商,评估调用超过 250,000 次。
关键模块与过程
输入提示经压缩器以多个 keep-rate(如 0.75、0.5、0.33)裁剪 token,保留高信息量 token;随后送入目标模型生成输出。
核心度量 normalized context utilization:将压缩后上下文保持的效用归一化,以消除不同语言 token 长度差异。
审计分三层:
- 主实验:在中等长度上下文上比较各语言在不同 keep-rate 下的效用保持率。
- 长上下文压力测试:使用 MultiEURLEX 等任务,观察激进压缩是否退化至无上下文水平。
- 翻译仲裁:对比原生压缩与 translate-then-compress 管道的 token 成本与效用。
输出与发现
输出各语言在各压缩条件下的效用分数与失败模式(如压缩诱导拒答)。结果显示差距源于监督数据语言 而非骨干架构:英文监督压缩器产生跨语言迁移差距,而多语言训练的 XProvence v1 无差距,v2 因翻译重训后在中文上下文清空 92% token。
与同类方法差异:不同于单一语言基准评估或单模型比较,本方法以并行语料 + 分词器预算控制 + 多压缩器多模型审计,分离并量化压缩的跨语言迁移差距。
实验
实验设计
使用十个语言(五种文字)的完全平行数据,对比四种学习型压缩器(LLMLingua-2 XLM-R/mBERT、Kompress-v2、XProvence v1/v2)与四种确定性基线(如随机保留、固定位置保留等),在 11 个目标模型上审计,累计 250,000+ 次评估调用。预算控制在目标模型分词器内匹配,主要指标为标准化上下文利用率。另设长上下文压力测试与翻译-压缩管道对比。
关键发现
- 迁移差距真实且与压缩率强相关:0.75 keep-rate 时各语言接近,但 0.33 keep-rate 下英语保留 57-62% 利用率,立陶宛语仅 10-24%,中文几乎为零,尽管中文 token 溢价最小。
- 差距源于监督数据而非架构:所有英语训练的压缩器均显示差距(0.5 keep-rate 平均差距 +0.23 至 +0.31),确定性方法无差距,多语言训练的 XProvence v1 无差距;但其 v2 用翻译数据重训后,在中文上清空 92% 上下文且无警告。
- 长上下文下更糟:激进压缩使五个非英语语言中的三个压缩上下文效用降至无上下文水平或更低。
- 翻译-压缩管道在五分之三语言中以约一半 token 成本达到或超过原生压缩。
基线对比解读
确定性方法不依赖语言监督,因此不产生跨语言差距,反证学习型压缩器的偏差来自训练数据语言分布。XProvence v1 的多语言监督有效,但 v2 的翻译数据监督退化严重,暗示真实多语言平行数据不可替代。工程实践上,非英语语言的安全压缩预算应显著调低;翻译-压缩可作为备选,但需评估翻译延迟与语义保真。
行业影响
落地场景
提取式提示压缩可直接应用于多语言 LLM 推理降本,典型场景包括:
- 全球化电商平台:对非英语商品评论、用户咨询进行压缩后再送入 LLM 做情感分析或自动回复,减少 token 消耗。
- 多语言内容平台:对 UGC 短视频标题、字幕、社区帖子进行压缩摘要,用于推荐系统特征生成。
- 企业级多语言知识库:对多语种工单、文档进行压缩后输入 RAG 流程,降低检索与生成成本。
商业价值
核心降本路径明确:同一内容在非英语语言上的 token 溢价为 1.3–1.8×,压缩能直接削减推理开支。但本论文揭示的跨语言转移差距意味着:若直接部署英语训练的压缩器(如 LLMLingua-2、Kompress-v2),在立陶宛语等语言上会损失大部分上下文利用率,中文几乎归零,导致下游任务质量骤降。
在 keep-rate 0.33 下,英语保留 57–62% 上下文利用率,立陶宛语仅 10–24%,中文基本为 0。
因此,商业价值必须绑定多语言质量保障:使用多语言监督的压缩器(如 XProvence v1)或确定性基线,才能在降低 token 成本的同时不伤害非英语用户体验,避免因隐性质量下降导致客户流失。
跟现有产品/工作流的接口
集成到现有 LLM 推理栈时,建议:
- 评估阶段:在目标语言的平行语料上测量压缩器的
normalized context utilization,而非仅依赖英文基准。 - 选型策略:优先选择多语言训练的压缩器,或使用
selective context、random等确定性方法做对照。 - 压缩率设置:对非英语语言采用更保守的 keep-rate(如 ≥0.5),避免激进压缩。
- 备选方案:对低资源语言可采用 translate-then-compress 管道,用英语压缩器处理翻译后文本,成本约为原生压缩的一半且效果更好。
该论文已开源 代码、压缩结果和模型输出,可作为集成前的审计基准。
局限
- 评测对象与语言/任务覆盖仍有限:仅审计四种学习压缩器(LLMLingua-2 的 XLM-R/mBERT 版本、Kompress-v2、XProvence v1/v2),未纳入抽象式压缩或更多新方法;十种语言虽覆盖五种文字,但多为欧洲与高资源语言,缺乏真正的低资源语言;任务场景主要基于平行语料与 MultiEURLEX 等受限任务,对开放域、多轮对话或代码上下文未见验证。相比已有跨语言评估基准,语言与任务多样性仍有提升空间。
- 评估指标的生态效度与协议偏差未充分处理:核心指标 `normalized context utilization` 反映压缩后上下文保留信息的相对比例,但未直接对应终端任务收益或用户满意度;预算匹配在目标模型分词器上控制,然而压缩器自身编码器(如 XLM-R/mBERT)与目标模型 tokenizer 可能不一致,该不一致未做消融;翻译再压缩管道仅对部分语言有效,且翻译引入的语义偏移尚未量化,威胁结论外推性。
- 研究定位为审计诊断,未提供修复方案或生产级安全阈值:文章主要揭示问题,但未提出改进压缩器训练或部署的具体方法;发布代码仓库 stars 极少,社区验证与采用有限;对生产系统的建议停留在“安全压缩预算更小”的定性层面,缺少按语言、任务与阈值细分的自动化安全检测机制,也未讨论如何在服务端检测并回退到不压缩路径以规避风险。