通过数据扩展推动高分辨率天气预报的极限
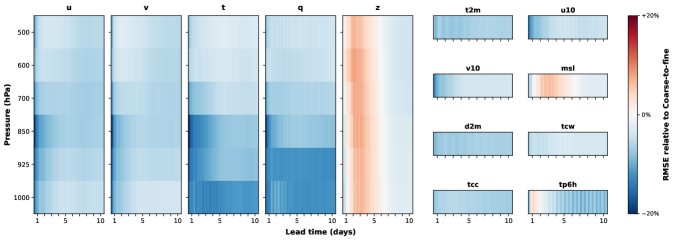
基于机器学习(ML)的 0.1° 全球天气预报模型的开发,受限于高分辨率数据的稀缺性:数十年的再分析数据仅以 0.25° 分辨率提供。现有方法在有限的 0.1° 样本上微调 0.25° 预报模型,但我们表明,这种迁移受到粗分辨率预报中固有的不可逆信息丢失的阻碍。 为此,我们提出 BaguanHR 框架,将关注点从迁移模型转向迁移数据。我们首先证明,超分辨率(SR) 比预报具有更低的条件熵和输入放大效应,因此是分辨率迁移的更稳健载体。通过利用这一优势进行变量级超分辨率,我们从 ERA5 合成了大量 0.1° 数据。 BaguanHR 在合成与真实数据集上的表现超越了基于 ML 的方法和 IFS-HRES,在 72 小时内超过 85% 的预报时效上取得了更优性能。此外,我们发现幂律扩展效应:数据量翻倍可使 72 小时预报的 RMSE 降低 4.6%,120 小时预报降低 4.9%。 我们的结果证明,扩展高分辨率 ML 预报的主要瓶颈在于数据,而变量级超分辨率提供了一种简单且通用的解决方案,可释放长期粗分辨率再分析数据用于高分辨率训练的潜力。
论文精读
TL;DR BaguanHR 利用变量级超分辨率从 0.25° ERA5 合成 0.1° 训练数据,破解高分辨率气象预报的数据瓶颈,实现数据翻倍 RMSE 再降 4.6–4.9%,性能超越 IFS-HRES。
问题
高分辨率全球天气预报是气象 AI 的核心方向,数据驱动模型如 FourCastNet、GraphCast 已在 0.25° 分辨率取得显著进展,但 0.1° 高分辨率模型训练受限于数据匮乏。
现有方法局限
现有方案通常先在大量 0.25° 再分析数据(如 ERA5)上预训练模型,再在有限的 0.1° 样本上微调。然而,粗分辨率预报模型在前向计算中会不可逆地丢失小尺度信息,该信息损失无法通过微调恢复。微调仅能调整参数适应新分辨率,但无法补充已丢失的物理细节,导致高分辨率预报增益有限。此外,0.1° 样本数量极少,模型容易过拟合,难以泛化到全局尺度。
为什么这个问题难且重要
获取 0.1° 全球高分辨率训练数据成本极高:卫星观测存在时空覆盖缺口,同化系统输出产品也多为 0.25°。而高分辨率预报对强对流、局地极端降水等小尺度天气现象至关重要,直接影响灾害预警。若无法解决数据瓶颈,ML 模型很难在精细网格上超越传统数值模式 IFS-HRES。业界高度关注能否利用海量低分辨率数据“放大”出高分辨率训练样本,这本质是一个数据工程与信息论交叉的难题。
行业类比
类似计算机视觉中利用超分辨率网络从低分辨率图像生成高分辨率训练数据,以增强目标检测或分割模型在小目标上的性能,但气象领域要求物理一致性更强。
核心洞察
- 高分辨率预报的核心瓶颈是数据尺度而非模型架构;用**变量级超分合成** 代替模型微调,可绕开粗分辨率预报的不可逆信息损失。现有 fine-tune 0.25° 模型受限于高频细节丢失,而 **BaguanHR** 证明 SR 的条件熵与输入放大系数低于预报,迁移更稳定;合成+真实数据训练后 85% lead time 超越 **IFS-HRES**,数据翻倍让 72h/120h RMSE 降 4.6%/4.9%。工程启示:构建 SR 数据管线解锁长期再分析资料,比反复调模型更有效。
- 变量级超分辨率(variable-wise SR)而非整体场 SR 或模型迁移,是更通用的高分辨率数据生成策略,并可支撑数据规模幂律扩展。气象变量间物理耦合复杂,整体场 SR 易产生伪影;逐变量建模可降低交叉干扰并保留关键动力结构。**BaguanHR** 用此方法从 **ERA5** 合成 0.1° 样本,与真实样本混合训练后取得最优效果,证明合成数据可规模化替代稀缺观测。该思路将 SR 训练与预报解耦,只需训练一次即可持续产出样本,适合工程化构建大规模训练集。
方法
输入
从 ERA5 0.25° 再分析数据出发,利用变量级超分辨率(variable-wise SR)模型 Swin2SR 将每个气象变量独立提升至 0.1° 分辨率,合成大规模高分辨率训练样本;再与有限的真实 0.1° 分析数据混合,构成训练集。
关键模块
超分辨率数据生成器(Swin2SR)
对每个变量单独训练 SR 模型。选择 SR 而非预报进行分辨率迁移的原因在于:SR 的条件熵更低、输入扰动敏感性更小,信息损失不可逆性弱于粗分辨率预报,从而更稳健地保留细粒度特征。BaguanHR 预报模型
- 编码器:变量特定 tokenization + 层次化嵌入;
- 主干网络:Swin Transformer 块堆叠,捕获多尺度空间依赖;
- 解码器:带全局残差连接,输出目标变量场。
训练策略
- 采用自适应 rollout 机制,逐步增加多步预报长度,缓解误差累积;
- lead-time-aware 损失加权:对不同预报时效的损失赋予差异化权重;
- 随机缓冲区替换与混合采样,平衡合成数据与真实数据的分布。
输出
生成 0.1° 全球天气预报,覆盖 72 小时及 120 小时时效,在 RMSE、ACC 及极端事件检测上全面优于 IFS-HRES 和现有 ML 方法(如微调 0.25° 模型的方案)。
与同类方法的差异点:BaguanHR 将分辨率迁移的重心从模型微调转移到数据合成,通过变量级 SR 解锁长期粗分辨率再分析资料,验证了高分辨率 ML 预报的核心瓶颈在于数据规模而非模型结构。
实验
实验设计
BaguanHR 首先使用 变量级超分辨率 (variable-wise SR) 从 ERA5 0.25° 生成大量 0.1° 合成数据,并与有限的真实 0.1° 再分析数据混合,训练高分辨率预测模型。对比基线包括现有 ML 方法 和 IFS-HRES。评估指标涵盖 RMSE、ACC 及极端事件检测。数据缩放实验通过控制合成数据量观察性能变化。
关键发现
- 在合成+真实数据集上训练,BaguanHR 在 72 小时内超过 85% 的 lead time 上优于 IFS-HRES 和 ML 基线。
- 数据量翻倍使 72 小时预测 RMSE 降低 4.6%,120 小时降低 4.9%,呈现 幂律缩放 效应。
- 结果表明高分辨率 ML 预测的主要瓶颈是数据规模而非模型容量,验证了 超分比预测更适合分辨率转移 的论点。
基线对比解读
相比直接从 0.25° 模型微调,BaguanHR 通过数据转移避免了粗分辨率预测中的 不可逆信息损失,从根源上解决了分辨率迁移问题。与 IFS-HRES 的对比显示,该方法在多数时段达到甚至超越数值预报精度,但少数 lead time 仍存在差距,提示未来可进一步优化物理一致性或引入更多真实高分辨率观测。
行业影响
落地场景
高分辨率全球天气预报(0.1°)可直接嵌入多个行业产品:
- 可再生能源发电预测:风电场与光伏电站需要精细风速、辐照度预报优化电力交易与调度,0.1° 分辨率能更准确捕捉局地风场和云层变化。
- 全球物流与供应链:跨国航运、航空、铁路依赖精细气象数据规划路线、规避风暴,降低延误与货损。
- 巨灾保险与再保险:精细化极端事件概率评估需要高分辨率历史与实时预报,用于定价和风险累积管理。
商业价值
- 降本:BaguanHR 通过变量级超分辨率(SR)从粗分辨率 ERA5 合成大量 0.1° 训练数据,绕开高分辨率数据稀缺瓶颈,大幅降低数据采集与标注成本。
- 增收/提效:预报准确率超过 IFS-HRES 和现有 ML 方法,直接减少天气相关运营损失,例如风电场可更准确报量避免偏差考核罚款,物流公司可优化路线节省燃油。
- 体验提升:更精细、更长时效的预报增强用户信任,尤其在极端天气预警场景。
与现有产品/工作流集成
- 数据合成模块:作为独立组件接入现有数据管道,将低分辨率再分析/预报数据升级为高分辨率,为下游预报或分析模型提供增强训练集。
- 预报模型替换或增强:BaguanHR 本身可作为预报微服务(GPU 推理 API)替换或与传统数值预报(如 IFS)融合,提供混合预报产品。
- MLOps 兼容:模型基于 Swin Transformer,可部署在标准深度学习栈(PyTorch/TensorRT),支持实时推理和批量后处理。
具体 Use Case
- 全球风电功率预测服务:跨国能源管理平台集成 BaguanHR 预报,为分布在不同气候带的风电场提供 72 小时逐小时风速预报,结合功率曲线模型,提升短期电力交易收益,减少备用容量成本。
- 跨国电商物流极端天气预警:大型电商平台的全球仓储与配送系统接入高分辨率降水/大风预报,动态调整配送路线和仓储防护,避免包裹延误与货损,提升客户满意度。
局限
- **可变独立超分** 生成各变量时忽视大气物理场的耦合约束(如风场与气压场之间的地转平衡),合成数据的变量间一致性缺少严格验证。虽然论文在附录中讨论了物理一致性,但未通过物理诊断量(如散度、涡度平流)系统评估,可能使训练出的预报模型在极端天气场景下产生非物理的小尺度结构。此外,SR 模型的误差会向下游传播,即使 SR 本身条件熵更低,但误差累积仍可能引入系统性偏差。
- 实验数据中合成样本比例极高,模型可能过拟合 **超分生成数据的统计特征**,导致在真实高分辨率场景下的泛化风险。性能对比主要集中在 72 小时内,更长时效(120 小时)虽展示 scaling 效应,但绝对精度优势未被充分报告;且与主流 **0.25° 基线模型**(如 GraphCast / Pangu-Weather)的对比未覆盖所有关键变量和区域,难以完全剥离架构改进与数据分辨率的贡献。
- 端到端流程引入 **超分模型** 作为前置步骤,推理时需先对输入低分辨率数据进行超分再输入预报模型,增加计算开销和延迟。尽管论文优化了训练 I/O,但对于实时业务部署,多一步推理可能成为瓶颈。此外,超分模型本身需要大量计算资源训练,且随着预报时效增长,来自初始场的超分误差可能被动力过程放大,限制其在极端事件预测中的可靠性。