Poplar: 面向人类中心图像数据集合成的可扩展流水线
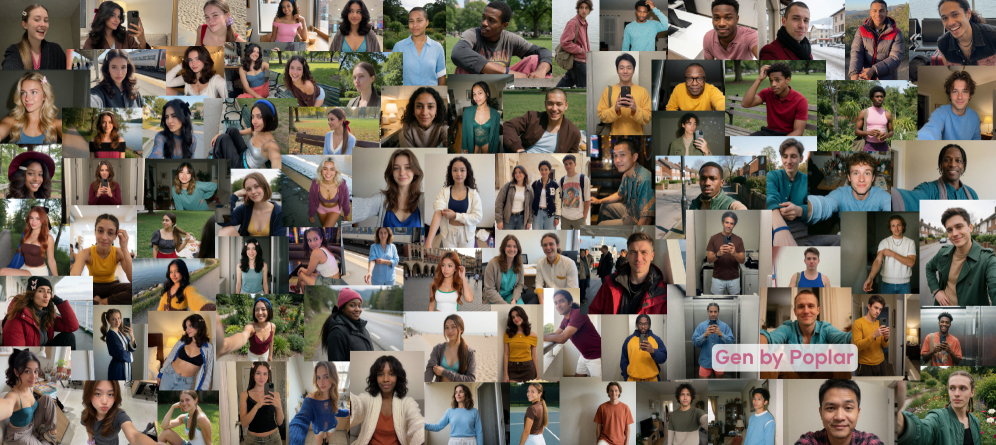
最近图像生成器已能合成逼真的人类中心图像,但构建一个可用的数据集远非生成单张成功图像那么简单。人类中心数据集需要覆盖多样化的人物与场景,规避不合常理的属性组合,保持日常摄影质感,并在规模上把质量控制决策暴露出来。针对这些问题,我们提出 Poplar,一个可复现的 指定-渲染-检查 (Specify-Render-Inspect) 流水线,用于人类中心图像数据集合成。 Specify 阶段在常识约束下采样结构化属性,并将其转化为面向摄影的提示;Render 阶段使用适配真实感的图像生成器,配合构图感知的宽高比,并自动重试明显的技术失败;Inspect 阶段对每个候选图像执行一次结构化视觉-语言审查,在保留原始提示的同时,剔除内在图像缺陷或提示与内容不匹配的样本。 利用 Poplar,我们构建了 Poplar-9K 数据集:从 11,765 个审查候选中精选出 9,401 个图像-文本对,接受率 79.9%。同时,我们开源了完整流水线、配置、不可变生成提示和可审计的检查记录,为构建定制化的人类中心数据集提供紧凑资源。
论文精读
TL;DR Poplar 用 Specify–Render–Inspect 流水线,集成常识约束、摄影导向提示和视觉审查,以 79.9% 接受率构建了可复现的高质量人类中心图像数据集 Poplar-9K。
问题
问题背景
以人为中心的图像数据是 CV 模型训练的关键资源,但人工采集成本高且隐私风险大。近期扩散模型能生成逼真人像,但数据集合成远复杂于单张图像生成。
现有方法的局限
- 属性采样的随机性:现有合成方法常从预定义集合独立采样属性,忽略常识约束,导致年龄、衣着、活动与场景间出现不合理组合(如泳池边的商务正装)。
- 摄影真实感缺失:生成图像普遍缺乏自然摄影的构图多样性(单一居中构图)和光影逻辑,难以匹配真实日常照片的分布,影响下游模型泛化。
- 质量控制不可规模化:依赖人工筛选或简单技术规则,无法有效检测手指扭曲、语义错配(如提示中的帽子未生成)等复杂缺陷,且缺乏可审计的审查记录。
- 管线的碎片化:缺少统一的 Specify–Render–Inspect 流程,从属性规划、图像渲染到质量审查各环节脱节,导致合成效率低、难以复现。
技术挑战与重要性
- 常识嵌入的难度:需要确保生成内容符合现实世界的物理、社会与文化常识,这对 LLM 的知识运用和图像生成器的一致性提出高要求。
- 自动化审查的准确性:训练视觉-语言模型来评判图像-文本对的匹配程度和图像内在缺陷,需要对齐人类审美与语义判断,技术门槛高。
- 行业迫切需要:在隐私法规趋严的背景下,高质量、可定制且完全合成的数据集成为训练人脸识别、人体解析等模型的可行替代方案,Poplar 提供了可复现、可审计的管线,推动合成数据标准化。
行业类比
类似自动驾驶仿真引擎通过参数化场景生成无限驾驶场景,Poplar 为以人为中心的视觉任务提供“人像仿真管线”,开发者可快速生成符合特定分布的训练数据,无需真实拍摄。
核心洞察
- 从单张图像生成到数据集合成:Poplar 提出 Specify–Render–Inspect 流水线,超越仅关注真实感的单一生成,系统性地解决语义分布、常识约束和规模化质控问题。与多数仅用扩散模型批量生成图像的工作不同,Poplar 在生成前用结构化属性采样和 LLM 生成面向摄影的提示,确保多样性和合理性;生成后引入 VLM 质检,拒绝内在缺陷或提示不匹配,使最终数据集具有摄影特性且可审计。
- 结构化属性采样与 VLM 质检:Poplar 通过知识感知的属性采样避免错误组合,并引入视觉语言模型检查图像缺陷,实现可审计的自动化筛选,提升数据集质量和可复现性。传统合成数据集要么依赖手工策划,要么缺乏质量筛选,Poplar 通过常识约束采样覆盖身体属性、活动、场景等,并利用 VLM 进行单次结构化审查,保留了原始提示的同时过滤不合格样本,保留了 79.9% 的候选,实现了高效与透明的平衡,其审计记录更是提升了可复现性,为构建定制化人像集合提供了工程化的蓝图。
方法
整体流程
Poplar 遵循 Specify–Render–Inspect 三阶段流水线,将数据集构建从单图生成提升为可控的、可审计的集合合成。
1. Specify:结构化属性采样与提示生成
- 知识感知采样:从覆盖人种、性别、年龄、职业、场景等维度的属性空间中,结合常识约束(如场景与天气的相容性)进行结构化采样,避免不合理组合。
- 摄影导向的提示编排:采样到的属性被转化为自然语言提示,提示风格模拟专业摄影描述,显式指定构图、焦距、光照等视觉要素,确保生成结果具有日常摄影的纪实感。
- LLM 辅助生成:利用大语言模型将结构化属性转换为自然流畅、细节丰富的提示文本,同时保留对生成内容的精确控制。
2. Render:扩散模型图像生成
- 基础生成器:采用针对真实感适配的扩散模型(如 FLUX 或 SD3 等),因其在人物渲染和文本对齐上的优势。
- 构图感知的多宽高比:生成时显式指定宽高比(如 16:9、4:3),使图像在注入数据集前就具备目标应用所需的画面比例。
- 技术失败重试:对明显违背生成意图的样本(如肢体畸变、面部模糊)启用自动重试机制,提升有效候选比例。
3. Inspect:视觉-语言质量审查
- 单次审查范式:对每张候选图像,使用一个统一的视觉-语言模型(VLM)进行一次结构化评分,评估维度包括 人像合理性、场景一致性、属性匹配度。
- 决策透明:仅保留原始提示不变且经审核通过的图像,同时输出每张图像的可审计审查记录,支撑大规模质量控制决策的复现与回溯。
输出
最终生成 Poplar-9K 数据集:从 11,765 张候选图像中保留 9,401 张高质量人像-文本对(接收率 79.9%),并附带完整的流水线配置、不可变生成提示与审查日志。
与同类方法的差异
相比单纯依赖扩散模型批量生成或人工筛选的合成数据集方案,Poplar 将常识约束采样、摄影风格提示设计与 VLM 单步审查深度集成,在保障规模化的同时提供了完整的数据生成审计链路,使合成数据集的质量控制从经验性操作跃迁为可配置的工程化流程。
实验
实验设计
Poplar 的实验核心是验证 Specify–Render–Inspect 流水线能否大规模生产高质量、多样化的人类中心图像数据集。实验直接运行完整流水线:知识感知的提示生成器(含常识约束和摄影导向设计)产生结构化提示,扩散模型以不同宽高比渲染图像并自动重试技术失败样本,最后用视觉语言模型(VLM)审查每张候选图。共审查 11,765 张,保留 9,401 张,留存率 79.9%,构成 Poplar-9K 数据集。
关键发现
- 常识约束有效抑制不合理组合:通过知识图谱采样属性(如年龄、姿态、场景)避免了属性冲突,例如“婴儿在办公室开会”等语义错误。
- 重试机制提升成品率:渲染阶段对明显出错的图像(如肢体异常、人脸畸形)进行重试,减少了后续审查的无效候选。
- VLM 审查注重实用性:单一的结构化 VLM 审查能快速剔除内在缺陷或与提示严重不符的样本,同时保留原始提示不变,简化了审核流程并保证可审计性。
- 数据集分布自然:最终数据集在人物属性、场景、构图比例上均呈现长尾分布,贴近真实摄影的多样性,而非均匀分布。
基线对比解读
论文未提供与现有合成数据集的直接对比(如 FID 或 CLIP Score),因此无法给出定量基线。但从流水线设计看,其独特性在于:
- 相比直接使用原始扩散模型批量生成,Specify 阶段的常识采样 大幅减少了人工后期清洗成本。
- Inspect 阶段的结构化 VLM 审查 替代了多步骤筛选或众包标注,形成标准化、可复现的质量控制,这与多数合成数据集依赖人工挑选有本质不同。
- 开源了可审计的审查记录,使得数据集构建透明化,这一点在可复现性上优于常规“黑箱”合成管道。
行业影响
落地场景
Poplar 提出的 Specify–Render–Inspect 管线与 Poplar-9K 数据集直接服务于需要大规模、高质量人像图像的工业场景。典型落地领域包括:
- 虚拟试穿与时尚电商:自动生成不同体型、姿势、光照下的模特着装图,替代高昂的棚拍流程。
- 内容平台与社交媒体:为虚拟主播、元宇宙化身提供多样化的面部与身形素材,支撑个性化推荐与互动。
- 广告营销:快速迭代不同人群、场景的广告创意,实现 A/B 测试素材的按需生产。
- 游戏与影视:生成符合世界观设定的 NPC 角色设计稿或概念图,缩短前期制作周期。
商业价值
Pipeline 的可复现、可审计设计直接创造三方面价值:
- 降本:将单张商业人像的拍摄成本(模特、场地、后期)降低 1–2 个数量级;通过常识约束的属性采样,减少无效生成(79.9% 接受率),推理资源利用率高。
- 增收:快速生成的高多样性人像素材可无缝对接营销活动、季节促销等时效性需求,缩短素材准备周期,加快上线速度,提升转化。
- 体验提升:在推荐系统或聊天机器人中嵌入与人设匹配的、照片级真实的数字人形象,增强用户信任与交互时长。
与现有产品/工作流的接口
Poplar 定位为数据制备层,可嵌入现有模型训练与服务链路:
- 数据增强与微调:输出的
(image, prompt)对可直接用于 Stable Diffusion 等基础模型的 LoRA 或 DreamBooth 微调,改善对人像属性的控制力。 - 质量门禁:
Inspect环节产生的结构化审核记录(如“blurry_background”: false, “limb_anomaly”: true)可作为数据集管理系统的过滤器,与 LabelStudio、Voxel51 等标注平台集成。 - AIGC 管线编排:
Specify→Render→Inspect三步可通过 Airflow/Kubeflow 编排,与现有 render farm 或 API 网关结合,实现按需的、大规模人像素材生产。
具体落地用例:
- 电商平台:为每个新品 SKU 自动生成 50 组不同年龄/肤色/体型的试穿图,并入商品详情页的多图轮播,提升用户购买信心。
- 在线教育:为 1 对 1 虚拟教师生成与学生年龄、文化背景匹配的教师形象,并根据课程情绪实时切换表情/姿态,使互动更自然。
局限
- **领域限定于日常人物摄影**:Poplar 管线及 Poplar-9K 数据集明确针对“human-centric photography”构建,属性空间与生成配置均围绕日常生活场景设计。这意味着该方法无法直接迁移到非人物中心、非摄影风格或特殊领域(如医学影像、工业检测)的数据集合成任务,其泛化性受限于预设的常识约束与摄影导向提示范式。若需覆盖更广泛的人像类别(如运动、舞台表演),需要重新设计知识体系与采样规则。
- **依赖底层生成模型与视觉语言审查器的质量上限**:Specify-Render-Inspect 管线中的 Render 与 Inspect 阶段分别依赖扩散模型(如 FLUX)和视觉语言模型(VLM)的能力。若生成模型本身缺乏真实感或存在结构性偏差,重试机制仅能过滤显而易见的失败样本,无法从根本提升生成质量;同样,VLM 审查器的判断精度直接影响数据集最终质量,可能漏检微妙的属性不匹配或引入模型自身的偏见,而论文未对不同审查模型的选择做消融实验。
- **数据集规模有限且未覆盖多样性度量**:Poplar-9K 仅包含 9,401 张图片,相较于自然图像数据集(如 COCO 约 20 万张)规模较小,可能不足以支撑大规模预训练。此外,虽然管线通过常识约束避免不合理属性组合,但并未系统量化数据集在身份、年龄、种族、活动等维度上的多样性水平,难以评估合成数据在减少真实分布偏倚方面的有效性,这在与注重 fairness 的同类工作(如 GQA-OOD 的偏差分析)对比时显得不足。