Verifier-Induced Support Reshaping in On-Policy Optimization
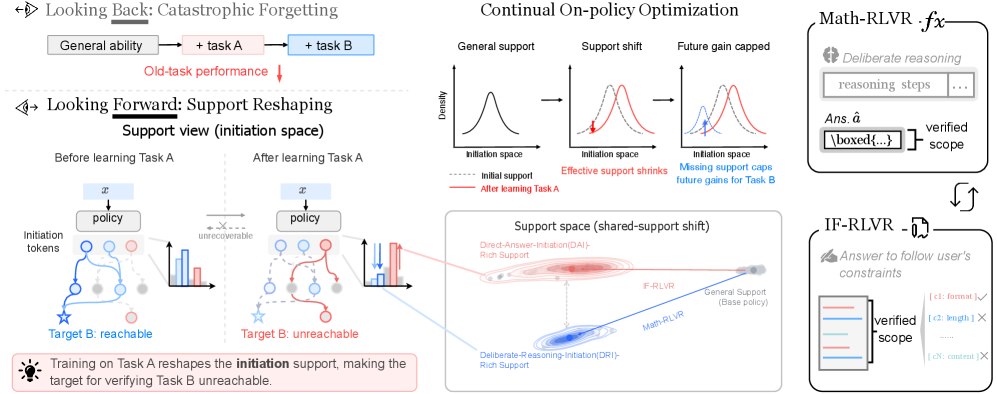
本文研究可验证奖励的在线策略强化学习(RLVR)中的一种反直觉现象:模型在优化当前目标时,可能使未来目标所需的成功行为变得过于稀有而无法被采样和强化。作者将其命名为验证器诱导的支持重塑(verifier-induced support reshaping),并定义了有效可奖励支持——即在固定 rollout 预算内可达到的成功轨迹集合。 跨两个模型家族、两类任务(数学推理和约束指令跟随)的重复验证器采样与双向训练实验表明:Math-RLVR 虽提高了平均指令跟随成功率,却降低了重复采样下存在至少一条成功响应的 prompt 数量;在 IFEval 上使用 Qwen3-8B-Base 时,pass@1 提升 6.5 个百分点,而 best@32 下降 9.8 个百分点。相反,IF-RLVR 将数学回答从逐步推导转向直接答案,降低了各采样预算下的 best@k。 词元分布分析与受控开头干预显示,这些变化集中在响应的前几个 token;RLVR 主要重排基座策略中已有的开头模式,而选定的开头会因果性地影响数学可搜索性。测试的参考策略约束、路由先验和在线策略蒸馏只能部分保留跨任务支持;MathIF 与 ReasonIF 表明边际增益仅部分转化为既正确又满足约束的响应。 因此,端点指标的改善并不能保证在线策略优化下未来的可训练性或联合能力。代码已开源。
论文精读
TL;DR 揭示并定义 RLVR 中的 verifier-induced support reshaping:当前任务奖励提升时,后续任务可采样的成功行为急剧减少,且主要源于开篇 token 分布偏移,威胁多目标持续训练。
问题
问题背景
在 on-policy RLVR(verifiable rewards 的强化学习)中,研究者通常直接优化单一 verifier 给出的平均奖励或 pass@1,以此提升模型在数学推理、指令遵循等任务上的即时表现。这类方法因其简洁有效而成为当前对齐与推理能力训练的主流范式。
现有方法局限
现有 RLVR 训练目标只关注当前任务的平均成功率,忽略了策略更新对 支持集(support)的隐性重塑。具体地,优化一个 verifier 会使得原本可被采样并得到奖励的成功轨迹在后续采样中变得稀有,甚至消失,导致 best@k 或跨任务成功率大幅下降。论文指出,在 IFEval 上,Math-RLVR 使 pass@1 提升 6.5 个百分点,却使 best@32 下降 9.8 个百分点。这种 verifier-induced support reshaping 无法通过现有 reference-policy constraints、routing priors 或 on-policy distillation 完全缓解,因为这些方法只能在局部维持旧策略的采样概率,难以对抗 on-policy 更新累积产生的分布漂移。
为什么这个问题难且重要
该问题的难点在于支持集重塑是 隐式且累积的:单步策略更新看似无害,但多轮 on-policy 迭代后,早期 token 分布变化会级联影响整条轨迹的可达性。论文通过 token 级分析发现,分布偏移集中在响应前几个 token,而这些 opening 直接决定后续推理路径的可搜索性。同时,当前业界追求多任务通用 AI agent,单一任务的 RLVR 可能破坏其他能力的训练基础,导致模型无法持续学习新技能。因此,如何在不牺牲当前任务性能的前提下保留对后续任务有效的 effective rewardable support,成为 on-policy 优化中的一个核心工程挑战。
行业类比
这一现象类似于对 LLM 进行安全对齐时,过度优化 helpfulness 单一指标可能导致模型创意生成多样性下降。
核心洞察
- Verifier-induced support reshaping 揭示了 RLVR 中 pass@1 与 best@k 的系统性背离:当前目标的平均收益会压缩后续采样中成功轨迹的覆盖范围。传统 RLVR 评估主要观察 pass@1 或平均 reward,忽略了 rollout 预算内有效可奖励支持的宽度;本文用 best@32 下降 9.8pp 等证据量化了这一隐形成本,说明终点指标提升不能保证下一轮 on-policy 训练有足够正样本可采。
- 支持重塑机制不在整个策略分布均匀坍缩,而是高度集中在响应开头的前几个 token:RLVR 主要是对 base policy 已有的候选开头做重排序,而非创造新能力,但开头路径的改变会因果地影响后续推理搜索性。这与将 RL 微调视为全局分布收缩或扩展的常见叙事形成对比,也解释了为何针对开头的干预能改变数学搜索性,为工程上以较小代价监控或缓解支持侵蚀提供了明确抓手。
方法
输入为 on-policy RLVR 下按任务分别采样的轨迹:数学推理(Math)与约束指令遵循(IF)各自使用可验证奖励训练策略。核心定义 有效可奖励支持(effective rewardable support)为在固定 rollout 预算内可采样到的成功轨迹集合。
关键模块如下:
- 双向顺序训练:先 Math-RLVR 后 IF-RLVR,或先 IF-RLVR 后 Math-RLVR,分别观测跨任务支持变化。
- 重复 verifier-scored sampling:通过 pass@1 与 best@k(如 best@32)等采样预算指标度量支持宽度,发现 Math-RLVR 提升平均 IF 成功率但降低有成功响应的 prompt 覆盖数;IF-RLVR 则降低 Math 的搜索性和奖励变化。
- Token 分布与开头干预:计算位置-wise JS 散度,显示分布偏移集中在响应前几个 token。受控修改 response opening 的因果干预表明,RLVR 主要重排名已存在于 base policy 中的开头候选,且所选开头路线直接影响 math searchability。
- 缓解策略测试:参考策略约束、路由先验、on-policy distillation 等方案,仅能部分保留跨任务支持。
输出为对 verifier-induced support reshaping 的定量表征:单任务 RLVR 优化会收窄后续目标的可采样成功轨迹,且边际收益难以转化为联合正确与约束遵循。
与同类方法的差异:本研究不局限于单任务 RLVR 性能提升,而是系统建模并实验跨任务连续训练下的支持动态,揭示 on-policy 优化中的隐性陷阱。
实验
实验设计
- 训练路径:在 Qwen3-8B-Base 与 Qwen2.5-Math-7B 上分别执行 Math-RLVR(数学验证器)与 IF-RLVR(指令遵循验证器),并加入反向顺序与联合训练。
- 评估方案:采用重复采样指标
pass@1、best@k,以及联合基准 MathIF / ReasonIF;同时进行 token 分布分析和开口干预实验。 - 缓解测试:考察参考策略约束、路由先验、on-policy 蒸馏等对支持保留的效果。
关键发现
- Math-RLVR 在 IFEval 上
pass@1提升 6.5 pp,但best@32下降 9.8 pp,表明平均成功率上升而响应多样性显著收窄,大量 prompt 在多次采样下不再出现成功响应。 - IF-RLVR 使数学回答从步骤式开口转向直接答案,降低数学搜索性;作用集中在前几个 token,RLVR 主要重排基座策略已有开口,且所选开口因果影响后续搜索。
- 缓解措施仅部分保留跨任务支持,边际收益只部分转化为联合能力。
对比解读
- 与传统 RLVR 仅关注单任务指标不同,本文提出 验证器诱导支持重塑,揭示端点性能与未来可训练性之间的张力。
- 工程启示:RLVR 流程需监控响应分布覆盖率(如
best@k或熵),而非仅看pass@1;应引入保留多样性的正则化或混合训练,避免过度优化导致后续多任务训练失败。
行业影响
多任务 RLVR 训练场景
论文揭示 verifier-induced support reshaping 在顺序 RLVR 中导致 best@k 下降与跨任务 support 坍缩。对工业界的核心启示:
- 落地场景:需要持续多能力对齐的 LLM 产品,如 电商智能客服、内容平台审核/解释生成、企业级 AI 助手。这些系统常先优化数学/推理,再优化指令遵循或安全,容易触发 support 坍缩。
- 商业价值:避免模型在后续 fine-tuning 阶段能力突变或多样性丧失,降低重训与数据采集成本;监控 prompt coverage 等指标可提前预警,减少线上事故;保留联合能力可提升用户满意度和信任。
- 接口:在现有 RLHF 框架(如 TRL、OpenRLHF)中添加
pass@k、best@k、prompt coverage监控;在训练 pipeline 中插入 opening-route 诊断;使用 checkpoint 早停 或 多验证器路由 缓解支撑坍缩。
具体 use case
- 电商智能客服:需同时回答数学优惠计算(需 step-by-step 推理)并严格遵循输出格式(如 JSON 字段)。若先 Math-RLVR 再 IF-RLVR,可能导致模型直接输出答案而略过推理,降低复杂计算准确率。通过监控
best@32和 opening 分布,可调整训练顺序或引入参考策略约束。 - 内容平台推荐解释:需同时保证事实准确和风格模板遵循。顺序 RLVR 可能使模型偏向直接回答,失去多解释候选。在服务端集成 support 指标,可触发回退到基础模型或路由到不同 head。
局限
- 实验覆盖范围有限:仅在 Qwen3-8B-Base 和 Qwen2.5-Math-7B 两个模型家族上验证,模型规模偏小,未扩展到更大参数模型或更多样化的 RLVR 算法变体(如不同 KL 惩罚强度、PPO 变体),因此 support reshaping 现象在更大规模模型和不同训练配置下的普遍性及强度尚不明确。此外,基准任务集中于数学推理和受限指令遵循,缺乏对更开放生成任务或模糊奖励场景的考察。
- 缓解措施不彻底:论文提出的 reference-policy constraints、routing priors 和 on-policy distillation 仅能部分保留 cross-task support,无法阻止后期训练中 opening 分布的单极化趋势,且未探索这些策略的组合或动态调整训练目标的方法。因此目前尚无可工程落地的完整方案来同时维持多任务可奖励支持,限制了该发现向实际生产环境的直接转化。
- 评估偏重行为层面:主要依赖 pass@1、best@32 等采样指标衡量 support,缺乏对潜在策略分布熵、reward landscape 或 token 级别多样性的直接刻画;joint-capability 的衡量也受限于特定 verifier 设计,难以推广到不可验证奖励或缺失明确 verifier 的场景。这导致对 support reshaping 的内在机制理解仍停留在现象关联,而非严格因果推断。