DarwinX: 通过自然选择进化智能体管线
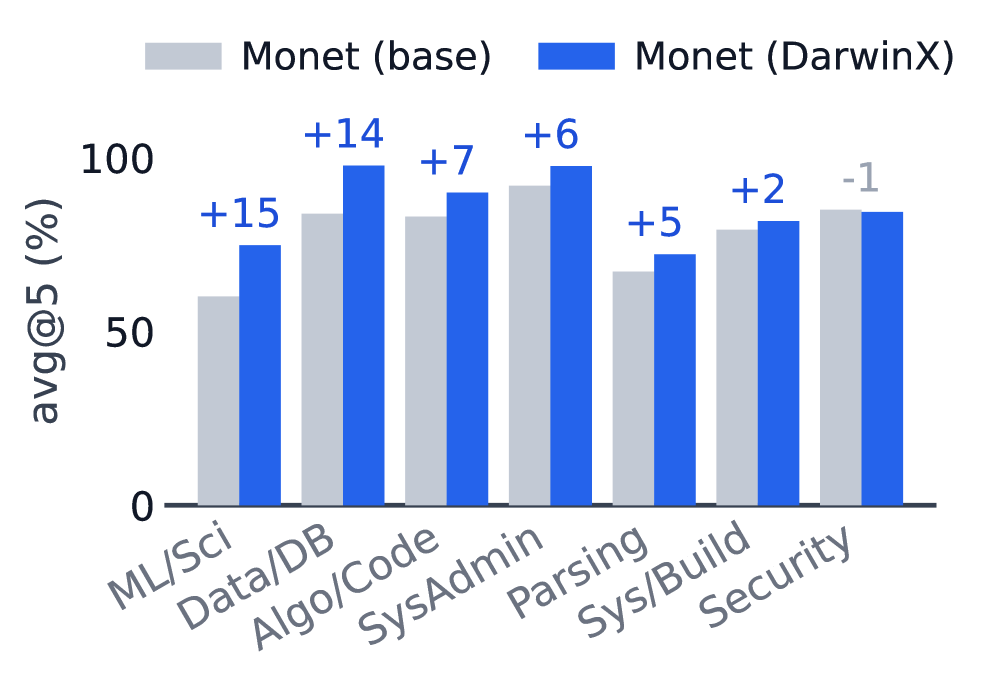
LLM 智能体的能力不仅取决于模型权重,还取决于其管线(harness):提示、工具、技能和控制流。自我改进循环已经编辑管线,但单线搜索具有路径依赖性,局部胜利往往使其他任务退化。 我们提出 DarwinX,将自我进化视为对冻结模型下管线种群的选择:保留与扩展契约 只允许扩展覆盖而不退化的变体;档案库 保留其他血统用于重组;失败、教师和自证的证据共享一个编辑接口。适应性来自每个基准自己的验证器:没有黄金解答,没有手工挑选的赢家。 在四个逐渐将进化信号与测试分离的基准上,一个循环平均增加约 17 分:Terminal-Bench 2.1 在匹配基线上上升 +7.7 至 83.2%,在更强基线上达到验证前沿 84.7%;TerminalWorld 的保留分割达到 68.3%,领先于所有现成智能体;WebArena-Infinity 真实任务 pass@1 从 43.5% 上升到 93.0%(审计清洁);一个 Terminal-Bench 2.1 管线不变地迁移到 SWE-bench Verified。 进化的是通用智能体能力,而非基准特有补丁,因此能经受任务、验证器和基础模型的变化。冻结模型不一定是固定的智能体:管线选择将评估计算转化为持久能力。
论文精读
TL;DR DarwinX 将智能体 harness(提示词/工具/技能/控制流)的自我进化视为种群选择:冻结模型,仅允许不回归的变异保留并与存档重组,平均在四个基准提升约17点且跨任务迁移,证明冻结模型不是固定智能体。
问题
问题背景
当前 AI agent 的能力不仅取决于模型权重,还取决于 harness(提示、工具、技能、控制流)。在模型冻结的前提下,通过改进 harness 实现自改进,已成为提升 agent 通用性能的关键方向。
现有方法局限
主流 self-improvement loop 沿单系谱迭代,存在两个结构性缺陷:
- 路径依赖:局部任务的成功变异被固定后,即使损害其他任务,也缺乏机制阻止回归;一个局部最优很容易变成全局次优。
- 无保留扩展:没有存档备选 lineage,无法组合不同变异的优势;同时缺少统一编辑接口,难以同时利用 failure、teacher、self 等多样化信号。
为什么这个问题难/重要
多任务环境下,验证器噪声大、任务异质性强,如何在“不退化”前提下扩展覆盖率,是根本性技术挑战。若进化结果只是基准特定补丁,就无法迁移到新任务、新验证器或新基础模型。因此需要种群选择、存档重组、preserve-and-extend contract 等机制,让选择压力导向通用 agent 能力,而非过拟合单一指标。
行业类比:类似自动驾驶策略迭代中引入回归测试与版本存档,确保新策略在提升特定场景通过率时,不降低整体安全指标。
核心洞察
- 群体选择替代单谱系搜索是 DarwinX 的核心突破。传统 self-improvement 常局限于单一 lineage 的串行编辑,导致路径依赖和局部提升以损害其他任务为代价;DarwinX 将进化建模为在 **harness** 群体上的自然选择,通过 **preserve-and-extend 合约** 只接纳不引入回退的变体,并维护 **archive** 保留备选谱系供重组。与依赖单一 lineage 的 prompt/agent 优化方法相比,该机制从算法上降低局部最优风险,提升了多任务间的平衡。
- 冻结模型不等于固定 agent:评估计算可转化为持久能力。DarwinX 证明不需要更新模型权重,仅通过对 harness 的选择、变异和重组,即可将 benchmark 自身的验证器信号沉淀为可跨任务、跨 verifier、甚至跨 base model 迁移的一般性 agent 能力。例如 **Terminal-Bench 2.1** 上进化得到的 **harness** 未经修改即可应用于 **SWE-bench Verified**。这表明在冻结模型下,进化过程中的评估开销可以转化为可复用的工程资产,而非单纯消耗计算资源。
方法
DarwinX 将 LLM 智能体的自进化建模为 harness 种群 的自然选择,模型权重保持冻结。其输入包括:基准任务集、每个任务自带的 verifier、以及初始 harness 种群(由 prompts、tools、skills、control flow 构成)。
关键模块
- Preserve-and-extend contract:任何新变异必须通过 verifier 证明在已有任务上不退化,同时扩展新的任务覆盖。这避免局部优化对全局能力的破坏。
- Archive 与 Recombination:保留多条替代谱系,允许跨谱系重组,突破单一路径的局部最优。
- 统一证据接口:失败样本、教师信号、自派生证据被转换成同一种编辑操作,驱动 harness 变异。
- Fitness 来源:不依赖人工标注或 gold solutions,直接用各基准自带的 verifier 评估适应度。
输出与差异
进化结束后得到一组高适应度的 harness,它们可泛化到未见任务、不同 verifier 甚至更强基座模型。与单谱系自改进(如逐条编辑 harness)相比,DarwinX 通过 种群选择 + 重组 吸收过拟合的变异,输出通用智能体能力而非基准特定补丁。
实验
实验设计
DarwinX 在四个 benchmark 上验证:Terminal-Bench 2.1、TerminalWorld、WebArena-Infinity、SWE-bench Verified。采用冻结模型,只进化 agent harness(prompts、tools、skills、控制流)。通过种群选择 + preserve-and-extend contract 保证不回归;archive 保留替代 lineage 用于重组;fitness 来自各 benchmark 自带 verifier,不使用 gold solution 或人工挑选。
关键发现
- Terminal-Bench 2.1 从 75.5% 提升至 83.2%(+7.7),更强基座上达到 84.7% 的 verified frontier。
- TerminalWorld held-out split 达到 68.3%,超过所有 off-the-shelf agent。
- WebArena-Infinity 真实任务 pass@1 从 43.5% 提升至 93.0%,并通过 audit-clean 校验。
- Terminal-Bench 2.1 进化出的 harness 无需修改迁移至 SWE-bench Verified。
与基线对比解读
DarwinX 的增益来自 harness 而非额外推理算力。与单 lineage 搜索相比,种群选择避免了局部胜出导致的全局回归:in-loop proxy 会过拟合,但种群吸收多样性后 held-out 泛化提升。合成到真实泛化中,动作有效性审计和跨域证据表明进化改变的是通用 agent 能力,而非 benchmark 特定补丁,因此可跨任务、跨 verifier、跨基座模型迁移。
行业影响
落地场景
- 产品形态:DarwinX 适合作为 LLM agent 的持续优化层,嵌入任何依赖复杂工具调用与多步推理的业务,如 电商客服自动化、代码助手、数据分析 agent、内容审核工作流。
- 具体 use case:在电商售后场景,用历史工单构建 verifier,演化客服 agent 的 harness(工具选择、回复模板、控制流),使退款/换货解决率提升,无需重训模型;在编程助手产品中,对 SWE-bench 类内部评测集演化,将改进后的 harness 直接部署到 IDE 插件,实现 issue 修复成功率提升。
商业价值
- 降本:减少对人工 prompt 工程和模型微调的依赖,评估算力转化为持久能力,一次演化多环境复用。
- 增收/体验:更高任务成功率直接提升客户满意度与转化率;preserve-and-extend 契约 避免回归,保障线上稳定性。
- 差异化:相比单次 prompt 优化或模型重训,种群选择+档案重组能持续积累跨任务通用能力,形成竞争壁垒。
与现有产品/工作流接口
- 可作为 离线演化服务 接入现有 agent 框架(LangChain、AutoGen 等),输入为 agent 定义+评测 verifier,输出为更新后 harness 配置(YAML/JSON)。
- 通过 feature flag 灰度发布新 harness,用线上指标做最终确认。
- 与 CI/CD 集成:每次代码或工具变更触发演化,自动生成候选 harness 并跑回归测试。
局限
- **变异多样性受限**:演化质量高度依赖提议的 harness 变体多样性。论文承认“选择只与提议的多样性一样好”,但未系统分析变异算子对搜索空间的覆盖程度。若变异仅做局部 prompt 重写或技能添加,难以探索控制流等结构性改动。与基于梯度的 prompt 优化或神经架构搜索相比,缺乏明确的搜索方向,可能导致评估预算浪费在低质量变体上,尤其当 verifier 噪声较大时。
- **归因与测量盲区**:harness 包含 prompts、tools、skills、control flow 多个组件,演化中同时变化,难以准确归因性能提升到具体组件。虽然论文做了 ablations,但混杂因素仍可能存在。适应度依赖各 benchmark 自带的 verifier,虽避免了手工标记,但 verifier 本身可能有偏差或可被 reward hacking;WebArena-Infinity 有 anti-cheating 审计,其他 benchmark 的稳健性尚待验证。
- **冻结模型与计算成本**:该方法假设模型权重完全冻结,只在 harness 层演化,能力上限受限于基座模型既有知识,无法解决需要模型内部表征更新的任务。讨论中提及 “Beyond the frozen-model setting” 表明未来需协同演化模型与 harness。此外,群体选择需要多轮生成、评估和归档,计算开销显著;虽然论文将评估计算转化为持久能力,但实际部署中需权衡资源与收益,且依赖任务有可用的 verifier 接口。