CW-BASS v2:基础模型教师下用于半监督分割的饱和度感知伪标签选择
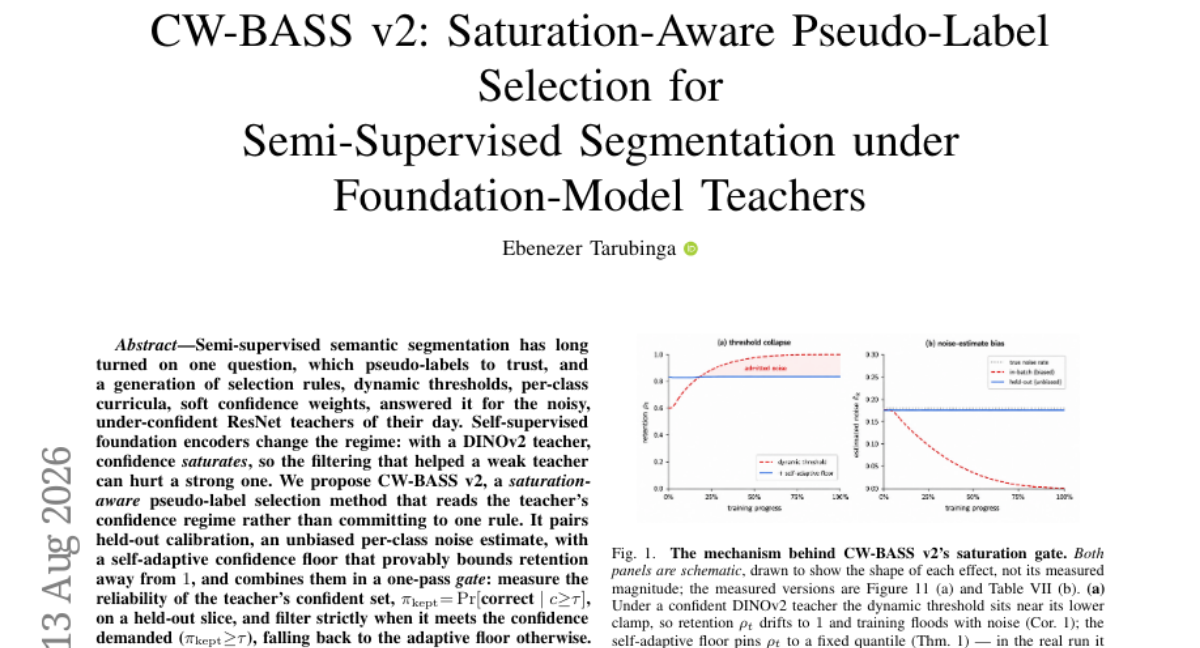
半监督语义分割长期以来围绕一个核心问题展开:哪些伪标签值得信任?为此,一系列选择规则、动态阈值、逐类课程和软置信度权重应运而生,它们针对的是当时噪声大、置信度不足的 ResNet 教师。自监督基础编码器改变了这一格局:以 DINOv2 为教师时,置信度趋于饱和,因此过去用于辅助弱教师的过滤机制反而可能损害强教师的表现。 我们提出 CW-BASS v2,一种饱和度感知的伪标签选择方法,它不固守单一规则,而是读取教师的置信度状态。具体来说,它利用留出校准集,获得无偏的逐类噪声估计,并与一个自适应置信度下限相结合,该下限被证明能将保留比率严格限制在 1 以下。两者通过一个单次门控机制协同工作:在留出数据上估计教师置信集合的可靠性 pikept = Pr[correct | c = tau],当 pikept 达到要求的置信度 pikept = tau 时采用严格过滤;否则回退到自适应下限。这里的边界是预先存在的操作阈值,而非针对 mIoU 调优的值。 在六个 DINOv2 教师上,该方法能够盲选正确的策略(严格或下限)。它通过选择严格模式,在饱和基准上恢复了 UniMatch V2 的操作点(Pascal VOC 1/8 达到 87.4,对比其报告的 87.9;Cityscapes 差距在 0.5 以内);而在置信集合不可靠的场景(ADE20K 上 pikept 约为 89%),下限模式表现更好(+1.5 mIoU,单种子)。 该门控机制之所以合理,是因为它避免了可测量的而非假设的失败:在可靠且饱和的教师下,置信度分布的动态范围会塌缩(例如 Pascal 中 98% 像素的置信度 = 0.95),此时自适应阈值会淹没保留掩码,使自训练退化为确认偏差。
论文精读
TL;DR CW-BASS v2 针对 DINOv2 等 foundation model 教师的置信度饱和问题,用 held-out 校准和自适应置信度下限选择伪标签,避免确认偏置,在半监督分割中恢复或超越 UniMatch V2。
问题
问题背景
半监督语义分割的核心挑战是伪标签筛选:在少量标注数据下,如何从无标注数据中挑选可靠伪标签进行自训练,以提升分割精度。
现有方法的局限
传统方法(动态阈值、per-class 课程、软置信度加权等)主要针对 ResNet 教师 的低置信、高噪声特性设计。当教师模型切换为 DINOv2 等自监督基础编码器时,置信度分布严重饱和:例如在 Pascal VOC 上 98% 像素置信度 ≥0.95,动态阈值失去区分正确与错误伪标签的能力,导致掩码泛滥,自训练退化为确认偏差。旧过滤规则在弱教师下有效,在强教师下反而有害——原本用于去噪的严格过滤会把高置信但错误的伪标签保留下来,加剧错误累积。
为什么这个问题难且重要
难点在于需要读取教师的置信度状态而非预设规则:基础模型教师的置信度可靠性因数据集和类别而异,需在严格过滤与自适应下限之间动态切换。若继续沿用自适应阈值直觉,会在饱和分布下失效。业界广泛将基础模型作为教师进行蒸馏与半监督学习,该问题直接影响标签效率与训练稳定性。论文提出的 held-out calibration 和 saturation gate 正是在测量而非假设教师可靠性,避免确认偏差。
行业类比
类似大模型知识蒸馏中的数据筛选:当教师模型过强、输出过于自信时,传统置信度校准失效,需要重新设计门控机制来避免确认偏差。
核心洞察
- 识别“置信度动态范围塌缩”是强教师下的关键现象:DINOv2 教师使 98% 的像素置信度 ≥0.95,传统自适应阈值因此失去区分力,反而灌入大量错误伪标签并引发确认偏误。本文通过 held-out 校准测量教师置信集合的真实可靠性(pi_kept = Pr[correct | c >= tau]),当可靠性满足置信要求时严格过滤,否则回退到自适应下限,从而让选择策略从“预设规则”切换为“读取教师实际置信度机制”。
- 用 held-out 校准估计每类噪声和 pi_kept,使伪标签选择不再依赖对教师行为的假设,而是实证测量。与 UniMatch V2 等基线相比,该方法在饱和且可靠的基准上严格过滤恢复其操作点(Pascal VOC 1/8 87.4 vs 87.9),而在置信集合不可靠的 ADE20K 上自适应下限带来 +1.5 mIoU 提升。这种基于测量而非调参的 gate,在六个 DINOv2 教师上盲测均能正确选择严格或下限策略,展示了对不同基础模型教师的泛化能力。
方法
输入:半监督语义分割的有标注与无标注图像,教师模型为 DINOv2 等自监督基础编码器,输出高置信度但可能饱和的逐像素预测。
关键模块
Held-Out Calibration:在保留的校准集上估计教师置信度阈值的可靠性,计算
pi_kept = Pr[correct | c >= tau],即置信度不低于tau时预测正确的概率,同时提供逐类无偏噪声估计。Self-Adaptive Confidence Floor:当饱和教师置信度动态范围崩溃(如 98% 像素置信度 >=0.95)时,固定阈值会导致保留掩码泛滥,引入确认偏误。自适应置信度下限可证明将保留比例限制在远离 1 的水平,防止过度保留。
Saturation Gate:单遍门控从校准集读取
pi_kept,若pi_kept >= tau,则采用严格过滤(原始阈值);否则回退到自适应置信度下限。阈值tau是预先设定的操作阈值,不依赖 mIoU 调参。
输出:筛选后的伪标签用于学生模型的弱到强一致性训练。在可靠饱和教师上选严格过滤(Pascal VOC 87.4 mIoU),在不可靠教师上选下限(ADE20K +1.5 mIoU)。
差异点:不同于传统方法固定或动态调节阈值,CW-BASS v2 通过测量教师可靠性,在严格过滤与自适应下限之间做出饱和感知的切换,避免了饱和场景下自适应阈值失效的问题。
实验
实验设计
- 在三个标准基准上验证:Pascal VOC 1/8、Cityscapes、ADE20K,采用半监督分割协议,使用六个 DINOv2 教师模型(不同规模/预训练)。
- 方法核心机制:留出校准估计每类噪声,结合自适应置信度下限,形成 saturation gate;gate 依据保留集上
pi_kept = Pr[correct | c >= tau]决定严格过滤或回退到 floor。 - 对比基线主要是 UniMatch V2,并同步复现其报告结果。
关键发现
- 在饱和基准上,CW-BASS v2 选择 strict 策略,恢复 UniMatch V2 操作点:Pascal VOC 1/8 mIoU 87.4(对比 87.9),Cityscapes 差异在 0.5 内。
- 当保留集可靠度不足(
pi_kept ~ 89%)时,例如 ADE20K,自适应下限策略领先 +1.5 mIoU(单 seed)。 - 分析显示置信度饱和导致动态范围崩溃:98% 的 Pascal 像素置信度 >= 0.95,传统自适应阈值无法区分,引发伪标签洪水与确认偏误。
基线对比解读
- UniMatch V2 的动态阈值在弱教师时代有效,但在 DINOv2 强教师下,高置信度标签普遍,过滤失去选择性,导致性能退化。
- CW-BASS v2 通过 held-out calibration 测量教师置信集的真实可靠度,而非假设饱和,从而在 strict 与 floor 间做出无偏选择;gate 的边界是既有的操作阈值而非为 mIoU 调优,具备原则性。
- 该方法在饱和可靠场景不损失性能,在不可靠场景获得增益,展示了从“规则驱动”到“测量驱动”的伪标签选择范式转变。
行业影响
落地场景
该方法适用于标注成本高且数据量大的语义分割任务。在自动驾驶中,可对道路、车辆、行人等类别进行半监督分割,仅需少量像素级标注即可利用大量未标注帧提升模型;在医学影像中,可用于器官或病灶分割,减少专家标注负担;电商平台的商品图像分割、遥感地物分类也可受益。核心场景是使用 DINOv2 等自监督基础模型作为教师,其高置信度饱和会破坏传统阈值过滤,CW-BASS v2 通过饱和感知门控保持伪标签质量。
商业价值
主要价值在降本:将人工标注需求降低一个数量级,同时保持接近全监督的 mIoU(Pascal VOC 1/8 达 87.4,Cityscapes 与 UniMatch V2 差距在 0.5 以内)。其次降低调参成本:方法无需针对每个数据集搜索阈值,在六个 DINOv2 教师上能自动判断严格过滤或自适应下限,减少专家介入。对于需快速迭代的产品线,例如自动驾驶感知模块或医学影像分析工具,能显著缩短开发周期。
与现有产品/工作流的接口
可集成进弱到强一致性训练框架(如 UniMatch 系列):保留学生模型、EMA 教师和一致性损失,仅替换伪标签选择模块为 held-out 校准 + 自适应置信度下限 + 单遍门控。实现上需额外划分一个 held-out 校准集(例如训练集的 5%),并在每次迭代时计算 pi_kept = Pr[correct | c >= tau]。代码已开源(CW-BASS-v2),可直接替换现有半监督分割 pipeline 中的 filtering 组件,几乎不增加计算开销。
局限
- - **校准依赖 held-out 标注**:方法需要在训练集以外保留高质量标注子集来估计 `pi_kept`,这在实际半监督场景中可能并不总是可得,尤其当标注预算极低时,额外划分会进一步减少可用标注。若 held-out 子集与目标分布存在偏移,校准结果会偏差,导致 gate 决策错误。论文未讨论如何选择 held-out 规模或其在标注稀缺下的可扩展性。
- - **泛化性验证有限**:实验仅基于 DINOv2 作为教师,且主要围绕 UniMatch V2 框架,未测试其他 foundation-model 教师(如 CLIP、SAM、EVA)或不同半监督分割架构。在非饱和教师或不同一致性正则化策略下,饱和 gate 是否仍能正确切换严格过滤与自适应 floor 尚未可知。交叉架构验证的缺失削弱了结论的普遍性。
- - **性能提升幅度不显著**:在可靠饱和教师上(Pascal VOC、Cityscapes),方法仅追平 UniMatch V2 的基线,而非带来明显增益;仅在 confident set 不可靠的 ADE20K 上取得 +1.5 mIoU(单 seed)。这说明方法的核心价值是避免退化而非大幅超越 SOTA。同时,held-out 校准与 gate 计算引入额外前向开销,可能抵消部分效率收益。