LiveAnimate: 实时稳定长时流式人体动画
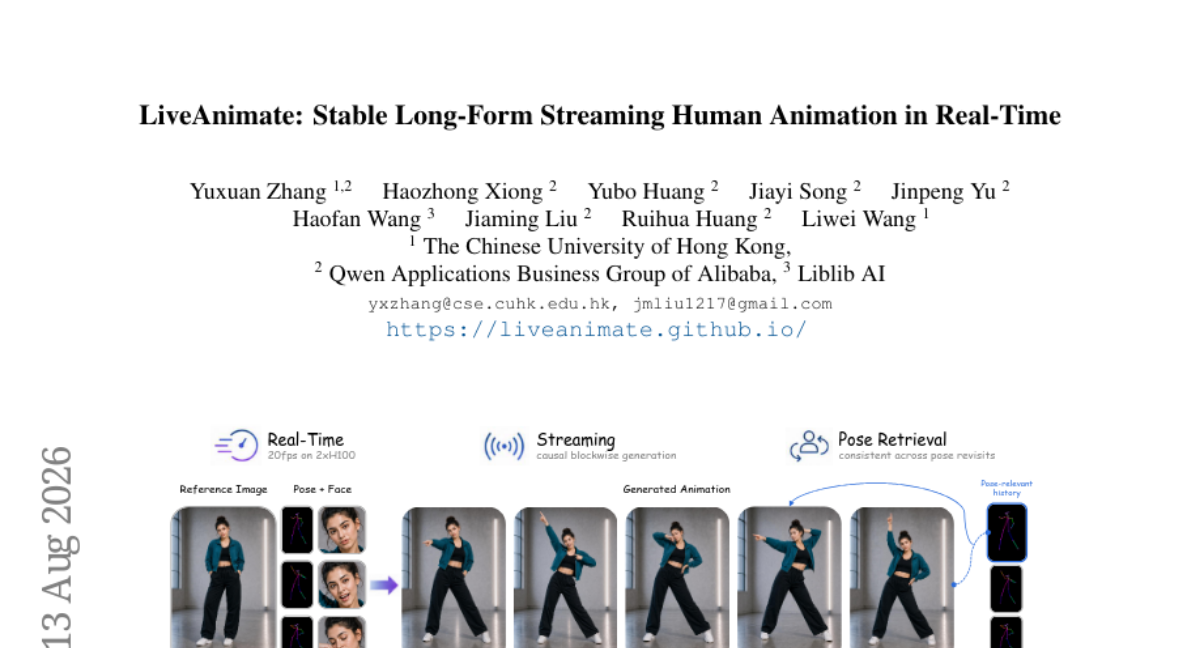
姿态驱动的人体动画旨在从单张参考图像和驱动姿态流合成目标人物的视频。实时生成对于直播、远程临场和虚拟化身等交互应用至关重要,然而现有的扩散模型系统生成每个片段需要数分钟到数小时,无法实现响应式交互。 我们提出 LiveAnimate,据我们所知,这是首个将实时流式生成与十亿参数规模下稳定长时生成相结合的动画系统,其核心是一个 14B 参数的视频扩散 Transformer (DiT)。两阶段训练流程首先通过 Reference-Anchored Teacher-Forcing Adaptation 将预训练的双向 DiT 适配为块级因果自回归生成器,随后通过 Block-wise Self-Forcing Distillation 将采样预算降至三步。 为在长序列中保持外观一致性,我们引入了 Pose-Retrieval Sink Attention (PR-Sink),一种有界 KV 缓存机制,结合了永久锚定首个生成块的 Static Sink、保存姿态检索历史块的 Dynamic Sink 以及三槽 Rolling Window。当姿态重复出现时,PR-Sink 无需保留完整序列即可恢复相关外观上下文,从而使得内存和每块延迟不随视频时长增长。配合 Ulysses 序列并行 和算子融合,这些设计在两张 NVIDIA H100 GPU 上实现了 19.63 FPS 的流式推理。 在基准测试中,LiveAnimate 从最初 30 秒到最后一分钟均能保持近乎恒定的感知质量和身份一致性,而现有系统在同一场景下要么显著退化,要么需要数小时的离线计算。这些结果在质量、延迟和时长维度为交互式全身动画确立了新的性能点。
论文精读
TL;DR LiveAnimate 基于 14B 视频 DiT,通过两阶段训练与 PR-Sink 有界 KV 缓存,在 2 块 H100 上实现 19.63 FPS 的实时长时人体动画,三分钟质量几乎不衰减。
问题
问题背景
姿态驱动人类动画(pose-driven human animation)从单张参考图像与驱动姿态流合成目标人物视频,是实时交互场景(直播、远程呈现、虚拟化身)的核心技术,近期业界对低延迟长时生成的需求快速上升。
现有方法局限
- 扩散模型 生成质量高,但推理需多步去噪(数十到上百步),单段视频生成耗时分钟级,无法支撑实时交互。
- 双向 DiT 依赖完整序列才能推理,不能直接用于流式自回归生成。
- 自回归方法 随序列增长,KV cache 内存与每块延迟线性上升;采用滑动窗口或截断则会丢失早期外观信息,导致长期生成中出现身份漂移或外观不一致。
- 当前实时系统通常降低分辨率、缩短生成时长或牺牲外观保真度,尚不能同时满足稳定长时、低延迟和高质量。
为什么难/重要
实时长时生成要求在固定每块延迟与显存预算内,保持跨分钟的外观一致性。核心挑战在于:既要保留关键历史上下文(尤其重复姿态对应的外观),又不能无限扩大缓存;同时 14B 参数 DiT 的注意力计算与多步采样本身开销巨大。业界对实时视频生成、低延迟大模型推理高度关注,这直接决定虚拟人、直播互动等应用能否规模化落地。
行业类比
类似实时音视频通话中的低延迟视频编解码:单帧编码必须快且状态受限,但长会话不能出现丢帧或质量恶化。
核心洞察
- 有界上下文缓存机制 PR-Sink 通过静态锚点、动态姿态检索槽和滚动窗口的组合,在恒定内存下维持长期外观一致性。这不同于传统方法:要么保留完整序列导致内存和延迟随流长线性增长,要么仅依赖滚动窗口丢弃历史导致外观漂移。PR-Sink 的关键在于利用姿态重复性,按需检索相关历史块,既避免全量缓存,又能在姿态重现时恢复外观上下文,从而在任意时长流中保持质量稳定,突破了长时生成中内存与一致性的根本矛盾。
- 两阶段训练策略将预训练双向 DiT 适配为块因果自回归生成器,并通过块级自强制蒸馏将采样步数压缩至三步,实现实时推理。该设计利用预训练视频扩散模型的先验,避免了从零训练自回归模型的高成本,同时通过蒸馏大幅降低扩散采样延迟,在保持生成质量的前提下达到 19.63 FPS。相比此前扩散模型动辄分钟级或小时级的离线生成,这一训练范式为十亿参数级视频扩散模型的实时交互部署提供了可行路径,凸显了“预训练+因果化+蒸馏”的工程价值。
方法
输入为单张参考图像与实时驱动姿态流。首先将姿态编码后与参考图像隐空间特征拼接,送入 14B 参数 video Diffusion Transformer (DiT)。
核心改造分两阶段训练:
- Reference-Anchored Teacher-Forcing Adaptation:将预训练双向 DiT 适配为 block-causal 自回归生成器,使每个时间块只依赖参考图像和已生成块,从而支持流式生成。
- Block-wise Self-Forcing Distillation:通过自蒸馏将采样预算压缩至 3 步,大幅降低每块去噪延迟。
推理时采用 Pose-Retrieval Sink Attention (PR-Sink) 作为有界 KV 缓存:
- Static Sink 永久缓存第一个生成块,提供身份与外观锚点。
- Dynamic Sink 保存姿态检索到的历史块,当相似姿态重现时恢复相关外观上下文。
- Rolling Window 保留最近三个块,捕捉短期运动连续性。
这一设计使缓存大小和单块延迟不随流时长增长。配合 Ulysses 序列并行 与算子融合,双卡 H100 达到 19.63 FPS。
输出为与参考身份一致、姿态严格对齐的实时视频流;三分钟长时评测中 IQA 从 4.047 到 4.026,几乎无退化。与需要全序列缓存或分钟级推理的先前扩散动画方法相比,LiveAnimate 首次以恒定内存与实时速率实现长时稳定生成。
实验
实验设计
LiveAnimate 在 三分钟长视频基准 上评估流式人体动画质量与稳定性,输入为 单张参考图像 + 驱动姿态流。模型基于 14B 参数视频 DiT,经过两阶段训练:Reference-Anchored Teacher-Forcing Adaptation 将预训练双向 DiT 转为 block-causal 自回归生成器;Block-wise Self-Forcing Distillation 将采样步数压缩至 3 步。推理时采用 PR-Sink 有界 KV 缓存(Static Sink 永久锚定首生成块、Dynamic Sink 存放姿态检索历史块、Rolling Window 三槽滚动窗口),配合 Ulysses 序列并行 与算子融合,在 双 NVIDIA H100 上实现流式生成。
关键发现
- 推理速度:19.63 FPS,满足实时交互需求。
- 长程稳定性:三分钟基准上,首 30 秒 IQA 为 4.047,末 1 分钟为 4.026,几乎无退化。
- 内存与延迟:PR-Sink 只保留固定数量块,每块延迟与显存不随流时长增长,保持常数。
- 采样效率:三步推理显著降低计算开销,模型参数达 14B。
与基线对比
先前扩散式姿态动画系统每段需 分钟到小时级 离线计算,无法实时流式生成;且长序列下外观与身份漂移明显。LiveAnimate 首次在十亿参数规模实现实时 + 长时稳定,同时避免整段 KV 缓存。其有界缓存 + 自回归蒸馏方案证明了在有限显存下维持恒定延迟的工程可行性,为互动数字人、远程呈现等场景提供了新操作点。
行业影响
落地场景
- 实时虚拟主播与数字人直播:游戏直播、电商带货、虚拟偶像。
- 远程呈现与在线协作:低延迟驱动化身,提升沉浸感。
- 教育内容生成:教师动作实时映射到虚拟讲师,批量生成课程视频。
商业价值
- 延迟降低:从分钟级到 19.63 FPS,使交互式应用可行,开辟实时动画市场。
- 长时一致性:PR-Sink 保持身份稳定,减少后期修复成本,提升观众留存。
- 成本优化:恒定 KV-cache 内存与每块延迟,长时流式服务无需线性资源增长,可部署在双 H100 上。
与现有工作流集成
- 作为推理服务接入:接收参考图像 + 姿势流(如 OpenPose / MediaPipe 输出),返回视频帧流。
- 支持标准视频管线:可通过 gRPC / WebSocket 输出帧,对接 OBS、FFmpeg、实时渲染引擎。
- 利用 Ulysses 序列并行与算子融合,可部署在现有多卡 GPU 集群,与 vLLM / TensorRT 等推理框架结合。
- 模型权重与推理代码已在 GitHub 提供。
具体用例
- 电商直播虚拟主播:商家上传商品图和参考人物,主播动作实时驱动虚拟形象介绍商品,7x24 小时直播。
- 在线教育虚拟教师:讲师手势、点头实时映射到卡通教师,生成互动式课程,降低视频制作成本。
局限
- **硬件门槛高**:模型规模达 14B 参数,推理需两块 NVIDIA H100 GPU 配合 Ulysses 序列并行和算子融合才能达到 19.63 FPS 实时速率。这显著限制了在消费级硬件或边缘设备上的部署,对于资源受限的实时交互场景(如移动端虚拟化身或普通工作站)并不友好。论文未讨论模型量化、剪枝或低精度推理等优化可能性,也未给出在更常见 GPU(如 A100 或 RTX 4090)上的性能表现,工程落地成本较高。
- **训练流程复杂且蒸馏代价大**:两阶段训练(Reference-Anchored Teacher-Forcing Adaptation 与 Block-wise Self-Forcing Distillation)需要先有预训练双向 DiT,再进行块因果适配和三步蒸馏。蒸馏过程依赖大量计算资源和精心设计的损失函数,且三步采样虽然加速,但可能牺牲生成多样性或细节保真度(如手部、衣物纹理)。论文仅报告 IQA 等自动指标,缺少用户研究或细粒度主观评价,难以全面评估生成质量。
- **PR-Sink 检索机制对姿态变化敏感**:Pose-Retrieval Sink Attention 依赖姿态相似度检索历史块,若长时间流中出现姿态分布漂移或未见过的极端姿态,Dynamic Sink 检索到的历史块可能无法提供准确外观上下文,导致身份漂移或伪影。虽然三分钟基准测试表现稳定,但更长时间(如小时级)或动作剧烈变化时的鲁棒性未验证。此外,姿态驱动范式本身难以处理复杂遮挡、多人交互或非刚性形变(如宽松衣物),与基于 3D 模型或显式外观编码的方法相比存在局限。