UniSwap: 流式音视频身份交换用于说话视频
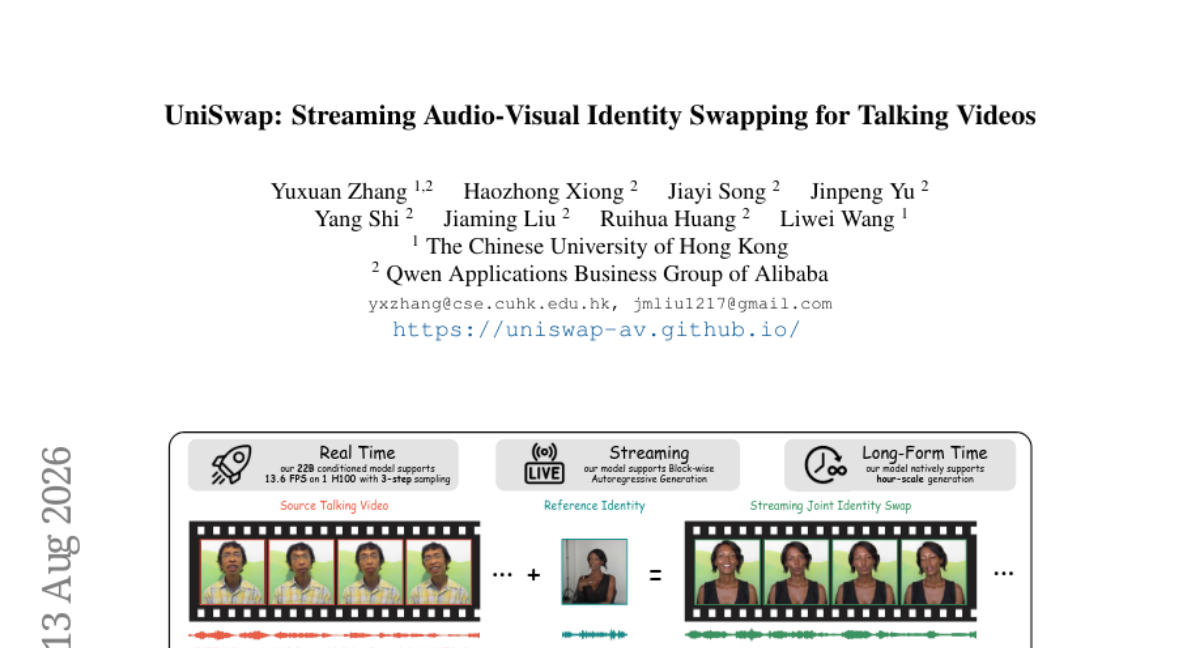
说话视频角色替换需要协调地迁移外观和声音,同时保留源动作、场景、语言内容及音视频时序。现有方法对两种模态分别优化模型,难以保证音视频一致性。 为此,本文提出 UniSwap,首个面向说话视频的流式联合音视频身份替换框架。给定源视频、参考图像和参考语音片段,UniSwap 在统一的音视频扩散 Transformer 中迁移参考外观与音色,同时保持源内容与动态。为解决跨身份对齐训练数据稀缺问题,引入 交换-重建流水线,从真实片段中移除视觉和语音身份,并以原片段作为重建目标。模型从双向骨干出发,逐步适配:上下文预训练 用于联合替换,条件流式适配 用于 block-causal KV 缓存生成,高效自强制 DMD 缓解暴露偏差并将每块去噪步数从 30 降至 3。高效 Multi-LoRA 切换 使三种 DMD 角色共享同一冻结骨干,Feature-RoPE 分解 将缓存位置保持在训练范围内,支持稳定的长时推理。 实验表明,UniSwap 具有强音视频同步、有竞争力的身份保持、高效流式生成和稳定的长时生成能力。
论文精读
TL;DR UniSwap 是首个流式联合音视频身份替换框架,在单个扩散 transformer 中同时迁移参考外观与声纹,并通过 swap-and-reconstruct 与 DMD 蒸馏实现 3 步采样、长视频稳定生成。
问题
问题背景
人物说话视频的身份替换 是 AIGC 的热门方向,要求同时替换外观与音色,并保持源视频的动作、场景、语义和音画时序不变。
现有方法局限
主流方案将视觉换脸与语音转换拆成两个独立模型,分别用 GAN / diffusion / VC 架构优化。这带来两个核心问题:
- 音画一致性 难以约束:两个模型对嘴型同步、韵律耦合、跨模态时序对齐缺少联合惩罚,只能在后期拼接时做启发式修正;
- 流式推理 难以实现:两阶段管道需要等音频或视频片段完整生成后再合成,无法稳定支持低延迟逐块输出,长视频还会累积跨模态漂移。
为什么难/重要
难点在于音频与视频在时间轴上的采样率和语义粒度不同,单一扩散 Transformer 必须同时建模图像 token 和音频 token 的联合分布,并保证长序列 KV-cache 在训练分布内。此外,缺乏跨身份对齐的训练数据,直接用不同身份配对训练容易导致身份泄漏或内容失真。业界对实时数字人 / 实时翻译口型 等应用的关注度持续上升,端到端联合生成与流式推理成为刚需。
行业类比
类似同声传译中的实时音画重演:如果翻译后的声音与发言人嘴型不同步,用户的认知负担会显著增加,生成内容失去可用性。
核心洞察
- 用单个音频-视频扩散 Transformer 同时完成外观和音色替换,从架构层面强制音画同步,而非事后对齐。现有方案分别优化视觉和音频模型,生成的嘴型、表情与语音节奏常出现错位,且无法在推理时实时协调。UniSwap 将两种模态的生成过程耦合在一个 latent 空间内,共享时间步和条件注意力,使音色转换与唇形、面部动态天然一致。这种统一建模不仅减少参数和工程链路,更重要的是让身份替换成为一个跨模态联合优化问题,为后续音视频生成任务提供了新的基线范式。
- 通过“交换-重建”自监督管线合成跨身份配对数据,解决了真实世界缺少对齐的音视频身份样本这一核心瓶颈。传统方法依赖人工标注或弱对齐,数据规模受限且噪声大。UniSwap 先将真实视频中的视觉和声纹身份剥离,再用原视频作为重建目标训练,使模型学会在无条件身份信息的情况下恢复完整内容。配合三阶段训练(上下文预训练、条件流式适应、高效自强制 DMD 蒸馏)和 Feature-RoPE 分解,模型能在块因果 KV 缓存下稳定生成长视频,且采样步数从 30 步降至 3 步,显著降低推理延迟和曝光偏差。
方法
输入与整体框架
UniSwap 接收 source video(源视频)、reference image(参考图像)和 reference voice clip(参考语音片段),通过单个 audio-visual diffusion transformer 完成外观与音色的联合替换。源视频提供运动、场景、语言内容及音画时序,参考输入提供目标身份特征。
关键训练模块
- Swap-and-Reconstruct 数据合成:从真实视频中剥离视觉与声音身份,将原始片段作为重建目标,构造对齐的跨身份训练对,解决成对数据稀缺问题。
- In-context Pretraining:以双向主干为起点,在上下文学习范式下预训练,让模型学会联合替换视觉和声音身份。
- Conditional Streaming Adaptation:引入解耦的流式条件掩码,将模型调整为 block-causal KV-cached 生成模式,支持逐块流式推理,避免未来信息泄露。
- Efficient Self-forcing DMD:采用自强迫式分布匹配蒸馏,缓解曝光偏差,将每个块的去噪步数从 30 步降至 3 步,大幅提升推理速度。
- 推理优化组件:Efficient Multi-LoRA Switching 让 DMD 的三个角色共享同一个冻结主干,通过 LoRA 切换降低显存;Feature-RoPE Decomposition 将缓存位置保持在训练范围内,支持稳定长视频生成。
输出与特性
模型输出一段同步替换身份后的 talking video,保持源视频的运动、场景、口型与音画对齐。与现有分离优化视觉和声音模型的方法不同,UniSwap 在单一音频-视觉扩散 Transformer 内完成联合替换,从而更易保证音画一致性。
实验
实验设计
UniSwap 采用 swap-and-reconstruct 流程生成配对训练数据,通过从真实视频中剥离视觉与声音身份,再用原始片段作为重建目标。实验重点评估 流式音视频身份替换 的质量,主要维度包括:
- 音视频同步性:生成结果中唇动与语音的时间对齐程度
- 身份保持:参考外观与音色的相似度
- 流式效率:块级因果生成与 KV 缓存下的推理延迟
- 长视频稳定性:长序列生成下的一致性
对比基线为分离式方法,即视频角色替换与语音转换各自独立优化的模型组合。
关键发现
- 音视频同步性强:单个扩散 Transformer 同时处理音频和视频模态,避免了跨模型对齐误差。
- 身份保持具有竞争力:虽然未达到 SOTA 级视觉或语音单独转换的精度,但在联合替换场景下表现均衡。
- 推理效率显著提升:通过 Efficient Self-forcing DMD 将每块去噪步数从 30 步降至 3 步,配合 Multi-LoRA 共享骨干,实现实时或近实时流式生成。
- 长视频生成稳定:Feature-RoPE Decomposition 保证缓存位置在训练范围内,避免长序列推理时位置编码越界。
与基线的深度对比
分离式方法通常在两个独立模型之间传递中间表示,容易出现音频和视觉在时间上的细微偏差,尤其在长视频中误差累积。UniSwap 通过 单一网络联合优化,从根本上缓解了这一问题。但联合训练也带来身份特征之间的相互干扰,因此其身份保持目前是“有竞争力”而非“最优”,未来可能需要在解耦表征上进一步改进。此外,流式设计的 block-causal 机制使得模型可以逐块生成,无需一次性处理整个视频,这在工程上对内存和延迟友好。
行业影响
落地场景
UniSwap 支持在单一音频-视觉扩散 Transformer 中完成流式身份替换,适合需要同步换脸换声的实时或准实时应用。典型 use case:
- 电商直播:品牌方可用一张产品代言人图像和一段参考语音,将主播视频中的形象与音色替换为目标角色,无需真人重复拍摄,支持 7x24 小时直播素材生产。
- 在线教育:教育机构可让同一教师视频内容适配不同虚拟形象或语音,保留原始教学动作、板书与节奏,同时降低多语言/多角色内容重制成本。
- 虚拟主播 / 社交媒体:内容创作者可基于自身视频快速生成不同角色的身份外观和语音,用于互动式短剧、游戏角色口播等。
商业价值
核心降本线在于避免多模态分别训练和后期对齐。传统做法需分别运行视频换脸和语音转换模型,再手动同步嘴型与音频,UniSwap 的联合训练与生成可减少后期校正人力。流式推理(从 30 步降至 3 步)降低 GPU 成本与延迟,适合规模化部署。体验提升体现在音视频高度同步的身份保持,可支撑付费个性化内容或品牌联名。
与现有产品 / 工作流集成
UniSwap 可作为实时处理模块嵌入视频编辑、直播推流或云端媒体处理流水线。其 block-causal KV-cached 生成方式支持边解码边输出,适合与 FFmpeg、WebRTC 等流媒体框架结合。Multi-LoRA Switching 允许在同一冻结骨干上快速切换参考身份,便于构建多租户 SaaS 服务。此外,预训练 + 流式适应 + DMD 蒸馏的三阶段训练流程清晰,可为下游微调提供明确切入点。
局限
- - **训练数据依赖合成配对**:UniSwap 通过 swap-and-reconstruct 流水线生成跨身份对齐训练对,但该过程依赖预训练的去身份模块,可能残留身份信息或引入偏差,导致模型对真实复杂场景的泛化能力有限。合成数据难以覆盖所有表情、姿态与光照组合,与真实配对数据存在分布差异,可能影响在极端条件下的身份保持与内容保真度。
- - **模型复杂度与部署成本**:虽然 Efficient Self-forcing DMD 将去噪步骤从 30 步降至 3 步,并利用 Multi-LoRA Switching 共享冻结主干网络,但推理仍需加载完整的音频视觉扩散 Transformer,对硬件资源要求较高。在边缘设备或低延迟场景下,流式生成速率可能受限;LoRA 切换的额外运行时开销在超长视频推理中可能累积,与轻量级单模态方案相比部署压力更大。
- - **长视频稳定性与身份漂移**:论文声称支持稳定长视频生成,但实验可能主要验证了有限时长的序列,更长时间跨场景或大幅运动下可能产生错误累积,导致视觉身份漂移或音视频同步偏差。参考语音 clip 的长度与多样性也会影响声纹转换鲁棒性,若参考语音过短或质量较低,生成的语音身份可能不稳定,与专门 voice conversion 或 talking head 方法相比在极端条件下可能牺牲单模态性能。