从原子证据到逻辑组合:面向复合答案选项的结构化组合推理
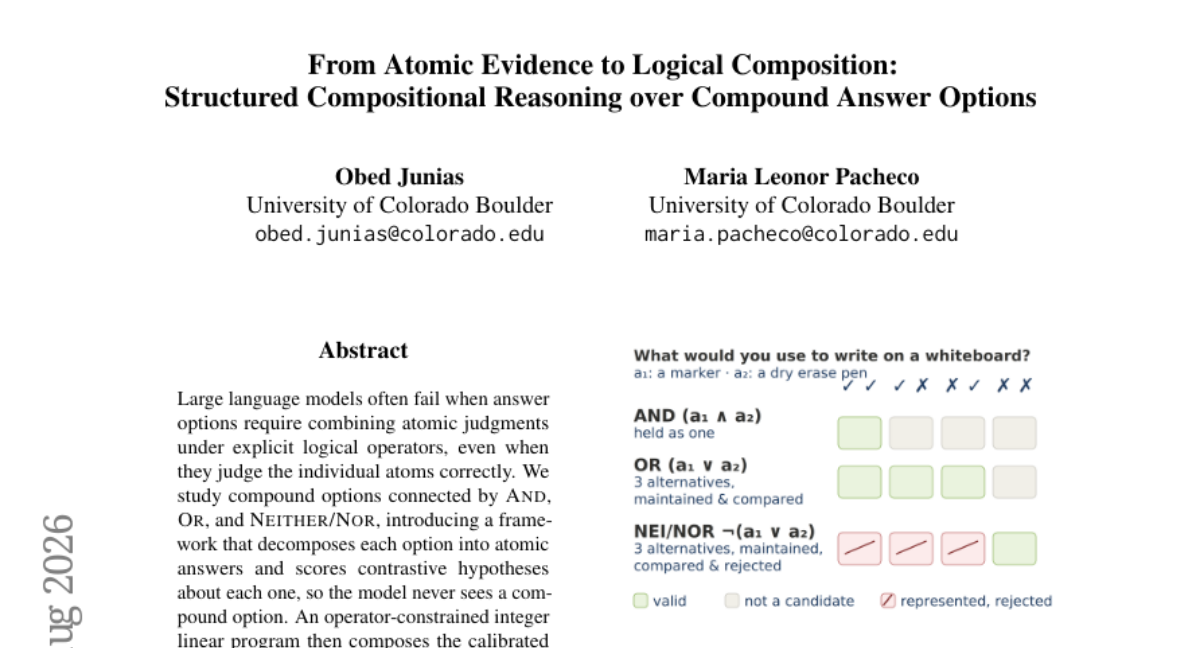
大型语言模型(LLM)在答案选项要求结合原子判断与显式逻辑运算符时常常失败,即使它们能正确判断单个原子。 我们针对由 AND、OR 和 NEITHER/NOR 连接的复合选项展开研究,提出一种框架:将每个选项分解为原子答案,并对每个原子进行对比假设评分,使模型不再直接面对复合选项。随后,算子约束整数线性规划 将校准后的分数组合为单一预测。 我们在 LOGICAL-COMMONSENSEQA 上评估,并引入源自 SATA-Bench 的阅读理解基准 LOGICAL-SATA。该框架在人工验证的 LOGICAL-COMMONSENSEQA 分割上将 Macro-F1 从 48.3 提升至 77.0,在 LOGICAL-SATA 上从 47.0 提升至 75.6,其中 NEITHER/NOR 的增益最大。
论文精读
TL;DR 论文将 AND、OR、NEITHER/NOR 复合选项分解为原子判断,对比假设评分后由算子约束整数线性规划组合,使 LLM 在逻辑推理基准 Macro-F1 提升约 30 个百分点。
问题
问题背景
当前 LLM 推理研究正从单步判断转向多步、复合逻辑推理,但显式逻辑运算符(AND、OR、NEITHER/NOR)下的复合答案选项处理仍是一个薄弱环节。
现有方法局限
直接将复合选项作为整体进行提示或评分存在明显不足:模型可能对每个原子判断正确,却无法正确组合逻辑,导致最终选项错误。现有基准如 Logical-CommonsenseQA 显示,直接提示的 Macro-F1 仅 48.3。原因包括:(1) 复合表达式增加表面形式干扰,模型难以区分原子证据与逻辑组合;(2) 缺少针对每个原子的校准置信度,无法为逻辑组合提供可靠输入;(3) 没有显式建模运算符约束,预测可能在逻辑上不一致(如同时选择互斥的 AND 条件)。
为什么难/重要
原子判断与逻辑组合属于不同的推理阶段,要求模型对每个原子进行校准的置信度估计,并通过运算符约束进行全局组合。这需要从黑箱 LLM 中提取对比性假设评分,并构建 operator-constrained integer linear program 保证解满足 AND/OR/NEITHER/NOR 语义。业界对此关注度上升,因为多条件筛选、规则遵循、合规性判断等场景都依赖可靠的复合逻辑推理。
行业类比
类似多条件筛选的推荐系统:直接让模型输出“同时满足 A 且 B”的结果容易出错,分解为原子属性判断再通过逻辑约束组合,得到的结果更稳定、可审计。
核心洞察
- 将复合选项分解为原子判断并用算子约束的整数线性规划合成预测,避免 LLM 直接面对复合逻辑。该框架与直接提示模型选择复合选项的 baseline 形成对比:后者在 AND/OR/NEITHER-NOR 组合上表现脆弱,而分解后每个原子独立评分,再通过 ILP 施加逻辑一致性约束,结合了神经生成和符号推理,不同于纯生成方法或仅做评测的 compound-answer benchmarks,提供了可操作的推理增强路径。
- 对比假设校准显著提升原子置信度的可靠性。对每个原子构造成对对比假设(如“A 是否为真?”)并做相对校准,比独立真/假置信度、生成采样或口头化置信度更能抑制 LLM 的偏向性和过度自信。实验证明校准后的原子分数输入 ILP 能大幅提升 Macro-F1,说明校准本身是性能提升的关键因素,这一思路可迁移到其他需要可靠概率输出的复合决策场景。
方法
方法流程
输入:一道复合选项多选题,选项由 AND / OR / NEITHER/NOR 连接多个原子判断组成。
关键模块:
- 选项分解:将每个复合选项解析为原子答案集合,例如
"A and B"分解为A和B两个原子判断。 - 对比假设构建:为每个原子答案生成一对对比假设(原子为真、原子为假),用于后续置信度评估。
- 置信度获取:通过 paired multiple-choice prompting 让模型分别评估每个假设的置信度,模型在整个过程中只看到原子判断,不接触任何复合选项。
- 分数校准:使用相对校准(relative calibration)对原子置信度进行归一化,减少模型在绝对置信度上的系统性偏差。
- 全局约束推理:将校准后的原子分数输入操作符约束的整数线性规划(ILP)。ILP 中的决策变量对应每个原子判断的真值,约束条件由选项的逻辑操作符决定:AND 要求所有原子为真;OR 要求至少一个原子为真;NEITHER/NOR 要求所有原子为假。目标函数最大化复合选项的整体得分,最终得到每个选项的分数。
输出:选择得分最高的复合选项作为最终预测。
与同类方法的差异:与直接让 LLM 端到端推理复合选项不同,本方法将逻辑组合问题转化为“原子级置信度评估 + 符号约束优化”,显式分离了语言模型判断与逻辑推演,从而显著提升对 NEITHER/NOR 等复杂逻辑的处理能力。
实验
实验设计
框架在两个基准上评估:Logical-CommonsenseQA 和 Logical-SATA(由 SATA-Bench 派生)。每个复合选项(AND、OR、NEITHER/NOR)被分解为原子答案,对每个原子构造对比假设并由 LLM 进行校准评分,随后通过运算符约束的整数线性规划组合这些分数得到最终预测。基线为直接提示 LLM 选择复合选项。
关键发现
- Logical-CommonsenseQA 上 Macro-F1 从 48.3 提升至 77.0。
- Logical-SATA 上 Macro-F1 从 47.0 提升至 75.6。
- 提升在 NEITHER/NOR 类型选项上最为显著,表明分解与约束推理有效解决了复合逻辑判断的短板。
对比解读
直接提示要求模型一次性处理复合逻辑,容易在部分原子正确时整体判断错误。该框架通过原子级置信度校准和全局运算符约束,将符号推理与神经评分结合,避免了复合选项对模型造成的认知负荷。同时无需重新训练模型,仅改变推理流程即可部署,工程成本较低,展示了神经符号方法在逻辑组合任务上的实用性。
行业影响
落地场景
该框架可直接嵌入需要复合逻辑判断的问答与决策系统。典型场景包括:
- 电商商品筛选与客服问答:用户问“支持快充且防水,但不支持无线充电”,系统可分解为三个原子属性判断,再用
AND/NOR约束合成,避免 LLM 因长选项而漏判。 - 企业知识库与合规审查:保险、金融等领域的规则多为多条件组合(如“年收入>50k 且无不良记录,或提供担保”),可将每条规则拆为原子查询,提升自动审批准确率。
商业价值
- 降本:减少复合选项导致的误判,降低人工复核和售后纠纷成本;无需重新训练模型,推理时增加一个轻量求解步骤即可。
- 体验提升:在智能客服、教育测评、医疗辅助问诊等场景,逻辑一致性增强能显著减少用户对“模型不懂规则”的不信任。
- 增收:高准确率的自动决策可扩大无人值守服务范围,如自助保险核保、电商自动选品与推荐理由生成。
与现有产品/工作流的接口
该框架可作为LLM 推理后处理层集成:模型只输出原子置信度 → 校准 → 算子约束整数线性规划(ILP) → 最终选项。工程上可封装为微服务,挂接在现有 RAG 或 LLM gateway 之后;ILP 可用 OR-Tools、PuLP 等求解器,约束直接从选项的逻辑运算符自动生成。相比直接提示工程或投票集成,该方案把组合逻辑外置到可验证的求解器,对 NEITHER/NOR 类困难样本提升最大,适合对可解释性、可审计性有要求的业务场景。
局限
- **逻辑表达能力受限**:框架仅针对由 AND、OR、NEITHER/NOR 连接的可分解原子选项,不支持嵌套逻辑、单原子否定、条件组合等更复杂的命题结构。现实任务中的选项往往隐含逻辑关系或需要常识补全,原子分解难以自动化,且对比假设构建依赖人工设计模板,在跨领域扩展时成本较高。因此该方法目前更适合结构清晰的多选题基准,对开放生成或自由文本推理场景的适用性有限。
- **原子判断的校准假设脆弱**:整个框架的性能高度依赖原子证据置信度的校准质量,尤其是相对校准在不同模型、不同提示模板下的稳定性未被充分验证。若模型对单个原子判断产生系统性偏差或过自信,约束整数线性规划只会忠实地组合这些错误分数,无法纠正上游错误。此外,原子间独立性假设在部分题项中可能不成立,导致组合结果偏离真实逻辑。
- **评估范围与基准局限性**:实验仅在两个英文多选题 QA 数据集上验证,其中 LOGICAL-SATA 从 SATA-Bench 派生,可能继承原基准的选题偏置与领域分布。论文未报告在不同规模或不同架构 LLM 上的鲁棒性,也未对比生成式作答、思维链等基线在可泛化性上的差异。推理过程中每个原子选项需单独调用模型进行对比打分,计算成本显著高于直接提示,对于需要低延迟的生产环境存在瓶颈。