你确定你确定吗?论指令微调对置信度和词汇多样性的影响
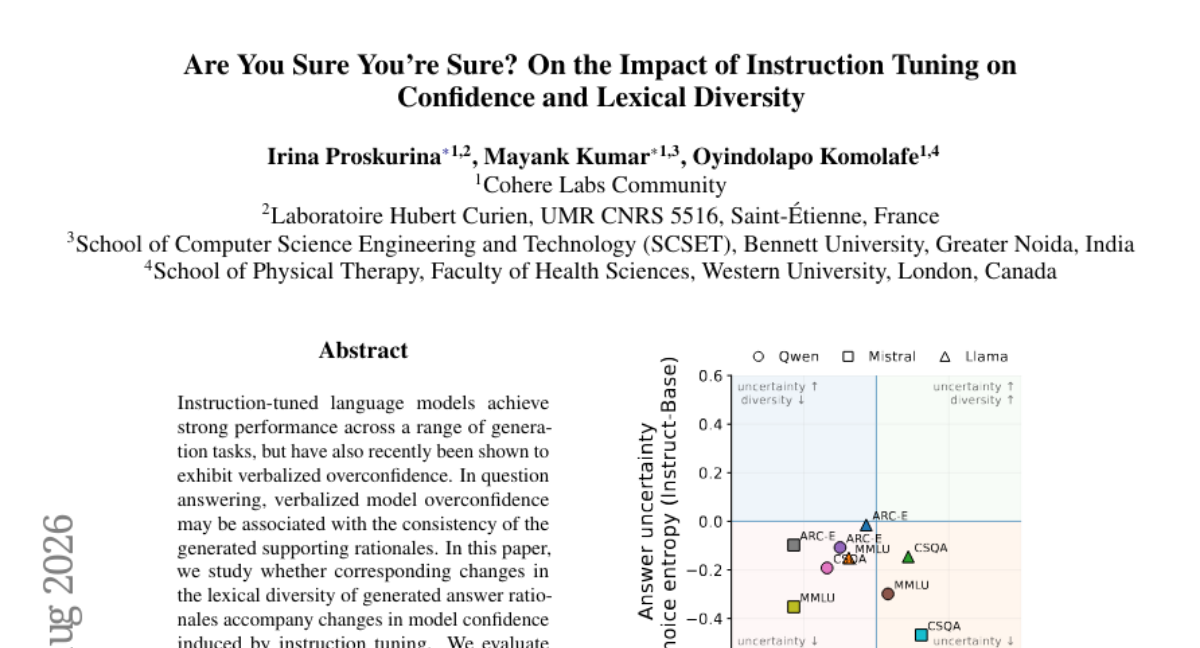
指令微调语言模型在一系列生成任务上表现强劲,但近期研究也显示它们会出现口头化过度自信。在问答任务中,模型口头化的过度自信可能与生成的支持性推理的一致性有关。本文研究指令微调引起的模型置信度变化是否伴随生成答案推理中词汇多样性的相应变化。 我们在问答基准上评估了三组匹配的基础模型与指令微调模型,发现指令微调始终改变答案置信度,尽管预测准确性变化有限且基于似然的校准度降低。其次,我们观察到指令微调对推理多样性的影响是非均匀的:跨推理多样性持续下降,而表层词汇多样性在不同模型和基准上的方向和幅度均有所不同。 最后,我们发现这些差异在控制答案选择和推理长度后依然存在,从而确认置信度和推理多样性捕捉的是指令微调的不同效应。
论文精读
TL;DR 研究指令微调对模型置信度与理由词汇多样性的影响:微调一致提高口头置信度但未改善校准,理由多样性变化非均匀且与置信度变化脱钩,提示需区分模型确定性与推理文本多样性。
问题
问题背景
指令微调模型在问答与推理任务中普遍表现出言语化过度自信,即模型输出的置信度与其实际准确率脱节。与此同时,模型生成的支持理由(rationale)在词汇层面的多样性变化尚未得到系统考察。
现有方法局限
以往研究主要关注似然校准或准确率变化,很少将置信度与理由的词汇多样性 关联分析。即使有工作涉及理由一致性,也多为定性观察,缺乏对基座模型与指令微调模型的配对定量对比。此外,基于似然的校准指标如 ECE 可能无法反映言语化置信度的变化,导致过度自信被低估。
为什么这个问题难且重要
置信度与理由多样性可能由模型内部不同的表征机制驱动,调节模型行为需要同时理解二者关系。指令微调会同时影响预测分布、生成风格和理由结构,分离这些因素需要控制答案选择与理由长度等混杂变量。实际部署中,过度自信在医疗、法律等高后果场景可能引发错误决策,而理由多样性的下降会削弱可解释性与用户信任。技术挑战在于指令微调带来的效应非均匀,不同模型和基准上方向不一致,难以用单一指标概括。
行业类比
类似对话式 AI 助手给出高置信度回答时,如果解释文本趋向模板化且重复,用户可能误判系统可靠性,类似自动驾驶系统给出决策置信度但解释单一,难以进行有效调试。
核心洞察
- 指令微调改变了模型的言语化置信度,但并未改善甚至降低了似然校准。研究比较 matched base 与 instruction-tuned 模型,发现 verbalized confidence 一致上升,而 accuracy 变化有限,且 likelihood-based calibration 系统下降。与之前分别研究 accuracy、calibration 或 confidence 的工作不同,本文将三者放在同一受控比较中,揭示出“模型声称的确定性”与“预测概率校准”之间的脱钩。工程上不能轻信模型输出的“我很确定”等表达,需引入外部校准或不确定性估计。
- 指令微调对 rationale 多样性的影响存在方向性分裂:跨样本结构多样性一致下降,但表面词汇多样性变化不固定。作者将 cross-rationale diversity 与 surface-level lexical diversity 分离,发现 instruction tuning 使模型对不同问题生成的 rationale 结构更趋同(如推理模板一致),但词汇层面的 TTR、MTLD 等指标在不同模型与 benchmark 上有升有降。这打破“微调后输出更重复/模板化”的单一叙事,提示在需要多样性解释的系统中,仅监控词汇多样性会掩盖结构性坍缩,应增加结构相似度检测。
方法
方法概览
输入为多个问答基准上的问题,模型需生成答案与支持理由。研究选取三组匹配的基础模型与指令微调模型,确保架构与参数规模一致,仅训练方式不同。
关键流程
- 生成与采样:对每个问题,模型生成最终答案及自然语言理由,并采样多次用于后续多样性估计。
- 置信度提取:
- 从生成文本解析主观确定性表达(verbalized confidence),如“definitely”“probably”,映射为置信度分数。
- 计算所选答案的序列似然,得到 likelihood-based calibration 指标。
- 准确率与校准评估:对比指令微调前后的预测准确率,并评估似然校准(如期望校准误差)。
- 词汇多样性计算:
- 跨理由多样性(cross-rationale diversity):同一问题多次采样理由的词汇重叠,如 Self-BLEU。
- 表面词汇多样性(surface-level lexical diversity):单个理由内部的词汇丰富度,如 type-token ratio。
- 控制变量分析:通过分层或回归控制 answer selection(模型是否选择同一答案)与 rationale length,分离指令微调对多样性的独立影响。
输出为各指标在 base 与 instruct 模型上的差异及跨基准趋势。
与同类方法的差异在于,本文不是单独考察置信度或多样性,而是将口头置信度、似然校准与理由词汇多样性联合分析,并通过控制变量排除答案选择和理由长度的混淆,从而揭示指令微调对推理表达与确定性的分离效应。
实验
实验设计
论文在 question-answering benchmarks 上评估三对匹配的 base 与 instruction-tuned 模型,分析指令微调对模型置信度、校准、理由多样性的影响。具体数据集名称未在摘要中披露。
关键发现
- 指令微调一致地改变答案置信度,但预测准确率变化有限,且 likelihood-based calibration 下降。
- 对理由多样性的影响非均匀:cross-rationale diversity 一致下降;表面层 lexical diversity 变化方向与幅度因模型和基准而异。
- 控制答案选择与理由长度后,上述差异依然存在,说明置信度与理由多样性捕获了指令微调的不同效果。
与基线对比解读
与 base 模型相比,instruction-tuned 模型虽常表现出更高自信,但校准反而变差,提示单纯依赖语言化置信度可能产生误导。同时,理由多样性的下降意味着理由生成趋于一致性,但表面词汇多样性无统一趋势,需要区分 语义多样性 与 表面多样性。指令微调带来的变化不能仅用准确率或困惑度衡量,校准与理由多样性应作为独立评测维度纳入 pipeline。
行业影响
落地场景
医疗 / 法律 / 金融问答系统:模型生成答案与 supporting rationale,口头置信度过高会导致高风险决策误判;可部署于辅助诊断、合规审查、合同分析等产品。
企业客服与技术支持:自动回答需判断何时转人工,校准差的模型会错误拦截或过度升级,影响效率与体验。
教育辅导与内容生成平台:解释性内容多样性下降可能削弱教学适配性,需要监控 rationale 多样性。
商业价值
- 降本 / 风控:指令微调后模型置信度上升但准确率未同步,误信高置信错误答案带来合规或临床风险;通过监测并校准 verbalized confidence 可降低人工复核成本。
- 可靠性增益:识别 rationale diversity 下降可避免模型陷入固定推理模式,保持多角度解释能力,提升用户信任与留存。
- 流程优化:在 instruction tuning 阶段引入校准正则与多样性约束,减少后期补救,缩短模型上线周期。
与现有工作流接口
- 在
eval harness中新增 verbalized confidence 与 rationale 多样性指标(如distinct-n、SelfCheckGPT、BLEU variance),作为 CI 关卡。 - 在生产 LLM 网关配置动态温度或
top_p,补偿校准漂移或恢复多样性。 - 在 RLHF / instruction tuning 数据配比中控制 rationale 多样性权重,监控
Cross-Rationale Diversity。
具体 use case:
- 医疗辅助决策:模型生成诊断建议及理由,系统监测其 verbalized confidence 与 rationale 多样性。若出现高置信但低多样性,触发人工复核流程,防止错误自动采纳。
- 企业级 RAG 问答:知识库检索增强生成答案,口头置信度可用于决定直接展示、附加免责声明或引用来源,降低误信风险,同时保留解释多样性。
局限
- **模型覆盖与泛化性有限**:论文仅评估了三对 base 与 instruction-tuned 模型,且均基于相似架构与规模(未公开具体参数,但从摘要推断为常见模型),未涵盖不同参数量级、不同微调数据配方或不同对齐方法。结论是否在更大模型或不同任务类型(如开放式生成、代码)中成立尚不明确。此外,实验集中在问答基准,推理任务之外的置信度与词汇多样性关系可能不同,限制了结论的普适性。
- **多样性度量不够全面**:文中采用的词汇多样性指标(表面-level 和 cross-rationale)只能部分反映理由的语义变化,无法捕捉推理逻辑的实质性差异。例如,同义词替换可能增加表面多样性但语义不变,而不同推理路径可能被忽略。这可能导致对指令微调影响的低估或误判。此外,未分析理由的正确性与多样性之间的权衡,也未将多样性变化与下游任务性能(如校准误差、事实性)进行关联,缺乏对实际部署的指导。
- **缺乏可操作的缓解方案**:论文属于观察性研究,指出指令微调会一致增加置信度并降低校准,但没有提出任何校正策略或训练技巧来缓解该问题。与近期校准相关的工作(如温度缩放、基于集合的置信度估计)相比,本文未提供如何恢复模型校准或控制理由多样性的方法,对工程师在实际系统中直接应用的价值有限。此外,没有探索不同微调超参数(如学习率、数据混合)对现象的影响,使结论停留在现象层面。