Self-Geometry: 面向几何一致 3D 视觉基础模型的无真值即插即用测试时自适应
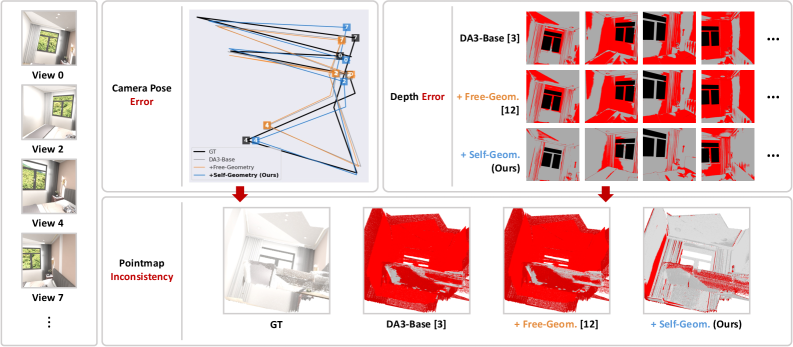
近期视觉基础模型(VFM)无需逐场景优化即可在前向传播中同时预测深度、相机位姿和点图,展现出强大的泛化能力。然而,显式的多视图几何一致性约束(如通过束调整)计算代价高昂,因此在 VFM 预训练阶段并未施加,导致模型输出可能存在几何不一致。 为应对这一问题,现有工作在测试时利用模型自身输出(如点图、特征)的隐式自一致性进行约束,但效果有限,尤其在预训练 VFM 预测严重失真的场景中。与此不同,我们提出 Self-Geometry,一种即插即用的测试时自适应(TTA)流程,直接以 2D 像素对应作为伪真值,施加显式的多视图几何约束。 Self-Geometry 由三部分组成:1) 几何解耦优化(Geometric Disentanglement Optimization),结合 多视图一致性损失 与 对极一致性损失,并通过 梯度解耦(Gradient Disentanglement)防止梯度冲突;2) 帧角邻域采样(Frame Angular-Neighbor),一种基于 SO(3) 测地距离 的视图采样器,以轻量方式施加上述约束;3) 轻量 TTA(Lightweight TTA),通过 LoRA 对 VFM 进行参数高效适配。 实验表明,我们的方法在 六个 VFM(VGGT、π³、DA3-Giant/Large/Base/Small)和 四个基准(7Scenes、ETH3D、ScanNet++、HiRoom)上均一致提升了位姿与几何估计精度。
论文精读
TL;DR Self-Geometry 用 2D 像素对应作伪真值,测试时对 VFM 施加显式多视角几何约束,通过梯度解耦和 LoRA 轻量适应,免 GT 即插即用地提升位姿与几何估计,在六个 VFM 上一致有效。
问题
问题背景
当前 3D 视觉基础模型(VFMs)如 VGGT、π³、DA3 系列,通过单次前向即可预测深度、相机位姿与点图(pointmap),无需逐场景优化,展现出较强泛化能力。然而,这类模型在预训练阶段通常不施加显式多视图几何约束,因为其计算代价过高(例如 bundle adjustment),导致推理时可能出现几何不一致。
现有方法局限
已有测试时适应方法多依赖隐式自一致性信号(如从 pointmap 或特征中提取的内部一致性),但在预训练模型对某些场景预测严重偏差时,隐式信号本身也失真,能提供的修正信息有限,性能提升遇到瓶颈。这种局限性源于缺乏对显式几何约束(如对极约束、多视图重投影一致性)的直接利用。
为什么难/重要
显式约束虽能提供更强监督,但直接引入会面临梯度冲突:多视图一致性与对极一致性损失可能相互干扰,导致优化不稳定。此外,测试时适应需保持轻量、即插即用,不能给推理带来过大开销。在多视图重建、SLAM、AR/VR 等应用中,几何一致性直接决定位姿与 3D 结构的可信度,因此该问题具有较高工程与学术价值。
行业类比
类似 LLM 推理中因缺乏逐步验证而产生事实幻觉,多视图几何模型若缺乏显式约束,也会在跨视角推理时“自相矛盾”,需要测试时干预来对齐输出。
核心洞察
- 显式 2D 像素对应作为 pseudo ground-truth 的 TTA 比隐式自一致性更鲁棒。现有 test-time 方法依赖模型自身输出的 pointmap 或特征进行一致性约束,本质是自我循环,无法注入新信息;当 VFM 初始预测严重错误时增益有限。Self-Geometry 利用跨视图 2D 像素匹配(如特征匹配或光流)作为显式几何约束,相当于在测试阶段执行轻量 bundle adjustment,但避免了全局优化的高计算成本。该思路可推广到任何存在可靠 2D 对应的下游任务,为 VFM 的 test-time 修正提供了新范式。
- 梯度解耦与 SO(3) 邻域采样是轻量 TTA 的关键工程技巧。多视图一致性损失和极线一致性损失对 LoRA 参数的梯度可能相互冲突,直接加权会导致优化震荡;Gradient Disentanglement 将每个损失的梯度投影到正交方向,消除冲突,使适配器稳定收敛。同时 Frame Angular-Neighbor 基于 SO(3) 测地距离选择覆盖充分的视图子集,避免使用所有视图带来的计算冗余,又比随机采样更有效。这两个组件不依赖特定 VFM 架构,可作为通用模块嵌入其他 test-time adaptation 框架。
方法
输入:给定多视图图像序列与预训练视觉基础模型(VFM,如 VGGT、π^3、DA3 系列),VFM 在单次前向传播中输出深度图、相机位姿与点图。
关键模块:
- Geometric Disentanglement Optimization (GDO):组合 Multi-View Consistency loss 与 Epipolar Consistency loss,以 2D 像素对应作为伪真值,显式施加多视图几何约束。同时引入 Gradient Disentanglement 解耦两条损失回传路径,避免梯度冲突。
- Frame Angular-Neighbor (FAN):基于 SO(3) 测地距离选取角度邻近帧作为视图采样器,以轻量方式施加几何约束,降低计算开销。
- Lightweight TTA:通过 LoRA 对 VFM 进行参数高效适配,仅更新少量低秩权重,保持训练稳定性。
输出:经过测试时适应的 VFM,在目标场景上产出具有多视图几何一致性的深度、位姿与点图预测。
与同类方法差异:相较先前依赖隐式自信号(如点图或特征一致性)的测试时适应,Self-Geometry 直接利用 2D 像素对应施加显式几何约束,即使 VFM 初始预测高度不准确,也能有效提升位姿与几何估计。
实验
实验设计
在六个预训练 Vision Foundation Models (VFMs) 上评估,包括 VGGT、π^3 和 DA3 系列(Giant/Large/Base/Small)。测试集覆盖四个场景级基准:7Scenes、ETH3D、ScanNet++ 和 HiRoom。方法采用 Lightweight TTA 通过 LoRA 进行极少参数更新,使用 Frame Angular-Neighbor (FAN) 基于 SO(3) 测地距离 采样邻近视图,并以 Geometric Disentanglement Optimization (GDO) 联合 Multi-View Consistency 和 Epipolar Consistency 损失,通过梯度解耦避免冲突。
关键发现
Self-Geometry 在所有六个 VFM 上均带来一致的姿态与几何估计提升。尤其当预训练 VFM 在特定场景高度不准确时,显式几何约束比先前依赖隐式自一致性信号(如点云或特征一致性)的测试时方法有效得多。该方法即插即用,仅需 2D 像素对应作为伪真值,无需真实标注或相机参数。
与基线对比
与之前测试时强制隐式自一致性的工作相比,Self-Geometry 直接施加显式多视图几何约束,在多视图一致性和对极约束之间通过梯度解耦避免冲突,从而在复杂场景中更稳健。与训练时使用 Bundle Adjustment (BA) 的显式方法相比,本方法在测试时通过 LoRA 适配,避免了 BA 的高计算开销,同时保持了对未知场景的泛化能力。
行业影响
落地场景
Self-Geometry 作为即插即用的测试时适应模块,可直接嵌入基于 Vision Foundation Models (VFMs) 的三维视觉管线,适用于电商商品三维重建、自动驾驶高精定位、室内扫描与数字孪生、AR/VR 空间感知等场景。例如,电商平台利用 VFM 从多视角商品图像快速生成三维模型,Self-Geometry 在推理时用显式几何约束校正深度与位姿,减少人工修复成本。自动驾驶车辆通过多相机系统实时建图,该模块可提升位姿估计精度,增强定位可靠性。
商业价值
该方法通过 LoRA 轻量适配,无需重训练或存储多套大模型,显著降低部署后的精度衰减与再标注成本。在内容生产侧,提升三维重建自动化程度,缩短商品展示、游戏资产、房地产扫描等项目的交付周期;在安全敏感领域(如自动驾驶、机器人导航),更准确的几何估计可降低定位误差,间接提升系统安全性,减少因模型漂移导致的潜在损失。
与现有工作流集成
Self-Geometry 以 LoRA 适配器形式挂载在现成 VFM 上,保持基础权重不变,仅需少量前向/反向计算进行在线微调,可集成到 MLOps 推理阶段或作为微服务部署。其 Frame Angular-Neighbor 采样基于 SO(3) 测地距离选择视图,与现有视觉定位系统(如 COLMAP、SLAM 后端)兼容,可作为几何一致性增强的后处理步骤,替代或补充传统 bundle adjustment,降低计算开销的同时保持可微分性,便于端到端优化。
局限
- **依赖 2D 像素对应质量** 该方法将 2D 像素对应作为伪真值来施加显式几何约束,因此对应点提取的精度直接影响优化方向。论文未明确讨论所用匹配器及其在低纹理、重复纹理或动态场景中的鲁棒性;在这些场景下错误对应会引入错误的极线或多视图约束,可能使 LoRA 权重向错误方向更新,导致原始 VFM 性能反而下降。相比隐式自一致性方法,显式约束对对应噪声更敏感,需要额外机制(如 RANSAC 或置信度加权)来缓解,但论文未提供此类消融。
- **测试时优化成本** 尽管采用 LoRA 进行轻量级 TTA,方法仍需在推理阶段对每个场景或序列执行多步反向传播以更新参数,引入不可忽略的延迟与显存开销。对于需要实时或低功耗部署的场景(如移动端 SLAM、在线重建),这种代价可能限制其应用。论文虽然进行了 Complexity Comparison,但未给出绝对推理时间或与纯前向 VFM 的端到端延迟对比;在吞吐敏感的工程环境中,是否值得为几何一致性提升而付出该成本仍需权衡。
- **评测场景覆盖有限** 实验仅在 7Scenes、ETH3D、ScanNet++ 和 HiRoom 四个以静态室内/小范围场景为主的基准上进行,缺乏大规模室外、动态物体、极端视角变化或稀疏视角条件下的验证。自监督 TTA 方法在分布外场景中可能出现负迁移,跨域泛化能力尚不明确。与依赖隐式自一致性或全量束调整的方法相比,其在更具挑战性的真实世界数据(如自动驾驶街景、手持视频)上的表现未见证据,方法实用性有待进一步检验。