超越像素:从视频先验到4D世界
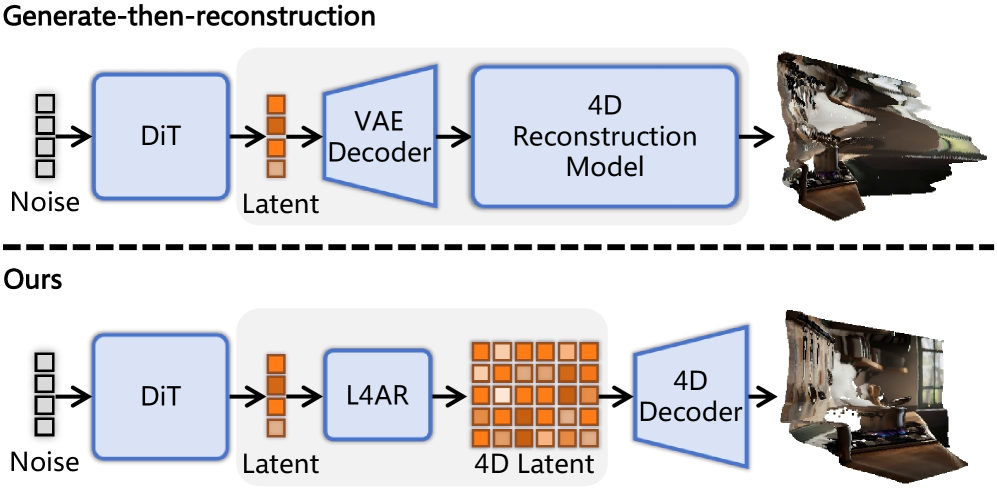
4D 生成旨在从文本或图像等条件中合成动态 3D 场景。现有方法要么使用独立的 4D 模型重建生成的 RGB 视频,要么改造特定的视频生成器直接预测几何。前者存在分布不匹配和错误传播问题,后者则将 4D 预测绑定到特定生成器,在生成器或条件机制变化时可能需要重新训练。 我们提出,共享变分自编码器(VAE)的视频模型最终去噪潜变量,可作为一种可复用的接口用于显式 4D 预测。基于此,我们引入直接 latent-to-4D 生成,并实例化为 Latent-to-4D:绕过 RGB,将视频潜变量与预训练 4D 解码器的 token 网格对齐,并通过逐帧与全局时空注意力进行细化。 训练仅使用约 1K 个重建片段,单个检查点即可在同一 VAE 家族内的多个视频扩散 Transformer 之间零额外训练迁移。在 Text4D-200 与 I4D-200 基准上,Latent-to-4D 相比匹配的同潜变量 Wan+4RC 级联,在投影 DINO-F1 上分别提升 2.88–3.45 与 5.81 个百分点,且人类评估者在几何、时间稳定性与整体质量上更偏好本方法。
论文精读
TL;DR Latent-to-4D 直接以视频扩散模型的去噪 latent 作为可复用接口,对齐预训练 4D 解码器并施加时空注意力,无需重训练即可跨同 VAE 家族 DiT 迁移,在 Text4D-200 / I4D-200 上超越 Wan+4RC 级联。
问题
问题背景
4D 生成旨在从文本或图像条件合成带显式几何和运动的动态 3D 场景,当前研究聚焦于结合视频生成先验与可微 3D/4D 重建,以支持虚拟制作、VR/AR 和具身智能等应用。
现有方法局限
主流方案分两类:generate-then-reconstruct 先用视频模型生成 RGB 观测,再用独立重建模型输出显式 4D;integrated feed-forward 则让视频生成器直接预测几何。前者存在分布不匹配、误差传播——生成的视频帧可能偏离重建模型训练分布,导致几何伪影或时序抖动;后者将 4D 预测绑定到特定生成器架构和训练流程,一旦更换生成器(如不同 DiT)或条件模态(文本 vs 图像),往往需要重新训练适配,缺乏可复用接口。
为什么这个问题难/重要
直接从视频 latent 到 4D 的映射需要对齐空间 token 网格与时间注意力,但不同 DiT 的 latent 布局差异大,如何设计共享接口是核心挑战。若成功,可复用同一 VAE 家族的多种视频生成器,无需为每个生成器训练适配层。业界对低成本、可扩展的动态 3D 资产生成需求强烈,尤其在与现有 video diffusion pipeline 集成的工程场景中。
行业类比
类似在文本到图像系统中,共享 VAE latent 空间允许下游任务(如深度估计)绕过像素解码直接消费 latent,减少信息损失并降低多模型串接的工程复杂度。
核心洞察
- 视频扩散模型的去噪 latent 可作为 4D 生成的通用接口,直接绕过 RGB 像素中间表示。与 generate-then-reconstruct 范式相比,该方法避免了 VAE 解码到 RGB 再重新编码带来的分布偏移与信息损失,从根源上减少误差传播;与 integrated feed-forward 范式相比,它不要求几何预测与特定视频生成器耦合,只要生成器共享同一 VAE 家族,即可复用同一个 4D 解码器,大幅提升模块化与可维护性。
- 单个 Latent-to-4D checkpoint 可在同一 VAE 家族内的多个视频 DiT 上无修改迁移,证明 latent 空间对齐加 token grid 对齐能有效解耦生成与几何预测。该工作借鉴了 4D 重建中 token grid 与注意力机制,但将它们作用在视频 latent 而非 RGB 特征上,使模型学习到的是生成器无关的映射关系。这为 4D 生成提供了一种新的架构范式:将 4D 解码器作为独立组件,与不同视频扩散模型组合,无需针对每个生成器重新训练几何分支。
方法
输入与共享隐空间
给定同一 VAE 家族内去噪后的视频 latent 作为输入,不做 RGB 解码,直接进入 4D 预测。
关键模块与流程
- 隐式对齐:将视频 latent 通过线性投影映射为与预训练 4D decoder 相同的 token grid 维度,形成统一的 latent-to-4D 接口。
- L4AR 精化:在 token grid 上先进行帧内 frame-wise attention,保持单帧几何结构与纹理一致性;再进行跨帧 global spatiotemporal attention,建模物体运动与外观时序变化。
- 预训练 4D 解码器:沿用已有 reconstruction 模型,将精化后的 token 解码为显式动态 3D 表示(可新视角渲染、可编辑)。
- 训练策略:仅用约 1K 重建片段训练对齐与精化模块,冻结或部分冻结 decoder,避免大模型遗忘。
输出与迁移能力
输出为动态 3D 场景,同一 checkpoint 可在同 VAE 家族的不同 video DiT(如 Wan 系列)间直接切换,无需重训。
相比 generate-then-reconstruct 的 RGB 级联,该方法在 latent 空间消除分布失配与误差传播;相比 integrated generation,它不绑定特定视频生成器,把 4D 预测抽象为可复用解码接口。
实验
实验设计
Latent-to-4D 在约 1K 现有重建剪辑 上训练,通过在视频潜在空间对齐预训练 4D 解码器的 token grid,并引入帧级与全局时空注意力。评估跨两个数据集:Text4D-200 与 I4D-200,指标采用投影 DINO-F1 和人类偏好评分。
关键发现
- 单个检查点可无修改迁移到同一 VAE 家族内的多个视频 DiT,无需重训练。
- 在 Text4D-200 上,投影 DINO-F1 较同潜伏 Wan+4RC 级联提升 2.88–3.45 点;在 I4D-200 上提升 5.81 点。
- 人类评估者优先选择 Latent-to-4D 的几何质量、时间稳定性与整体质量。
与基线深度对比
相比 generate-then-reconstruct 范式,该方法绕过 RGB,直接利用视频扩散模型的最终去噪潜变量,避免分布不匹配和误差传播。Wan+4RC 级联作为匹配的同潜变量基线被显著超越,表明潜在空间到 4D 的映射在可复用性和精度上优于两阶段重建。
行业影响
落地场景
Latent-to-4D 可直接嵌入需要动态 3D 内容的业务线:
- 电商虚拟展示:输入商品文本或图片,生成可旋转、带动态效果的 4D 商品模型(如运动鞋旋转、箱包开合),替代传统多角度拍摄与人工建模。
- 内容平台特效:短视频/直播平台用文本 prompt 实时生成几何一致的动态 3D 角色或道具,用于 AR 滤镜、虚拟主播。
- 自动驾驶仿真:基于文本描述生成动态 3D 交通场景(行人、车辆运动),补充罕见场景数据,加速感知模型训练。
商业价值
- 降本:跳过 RGB 解码和重建步骤,减少一次 VAE 解码 + 4D 重建的算力消耗;同一 checkpoint 跨多个视频生成器复用,避免为每个生成器单独训练 4D 模块。
- 体验提升:直接潜变量生成避免 RGB 中间误差传播,几何和时序稳定性更高,人类评估偏好明显,可减少后期人工修正。
- 增收:高质量 4D 内容生成能力可作为 API 对外提供,按调用量收费;内部可加速创意迭代和 A/B 测试。
与现有工作流接口
- 现有产品若已使用 Wan 等视频扩散 transformer 且属于同一 VAE 家族,可在 denoise 后直接接入 Latent-to-4D,替换原 RGB 重建链路,无需重训。
- 提供 token grid 对齐 和 帧级/全局时空注意力 模块,可封装为独立服务,输入视频潜变量,输出显式 4D 表示(如动态 Gaussians / NeRF),便于下游渲染引擎集成。
- 对已有 4D 重建模型可采取蒸馏或 adapter 思路,逐步替换前端生成器。
具体落地场景:某电商平台在商品详情页增加 3D 动态展示,利用该技术将商品文本描述直接转为 4D 模型,避免传统 3D 扫描成本;某自动驾驶公司需要生成大量罕见交通场景用于训练感知模型,通过文本控制生成动态 3D 场景,丰富数据多样性。
局限
- **共享 VAE 依赖** 限制了方法适用范围。Latent-to-4D 要求视频扩散模型与 4D decoder 使用同一 VAE 家族的 latent 空间,才能实现跨生成器的迁移。对于不同 VAE 架构或非扩散模型,需要额外对齐或重新训练,这削弱了其通用性。论文仅在 Wan 系列 DiT 上验证,未展示对其他 VAE 家族的可扩展性。该约束可能导致生态碎片化,从业者需为不同 VAE 分别训练对齐模块。
- **训练数据规模有限** 仅为约 1K 重建片段。尽管在 Text4D-200 和 I4D-200 上取得 SOTA,但数据量远小于视频生成模型的预训练规模。这可能导致对长视频、复杂交互或分布外几何的泛化不足。实验未在更广泛的数据集(如真实世界动态场景)上验证,模型可能过拟合到现有重建数据的偏差。
- **依赖预训练 4D decoder 的质量** 是一个潜在瓶颈。Latent-to-4D 直接将 latent 映射到显式 4D 表示,如果 decoder 对某些几何结构(如薄表面、透明物体)或高频纹理重建能力有限,该方法会继承这些缺陷。同时,绕过 RGB 中间表示虽减少了误差传播,但也失去了像素级监督,可能导致颜色准确性和细节保真度下降。