SPIEval: 评估大型语言模型作为移动助手处理分散个人信息的能力
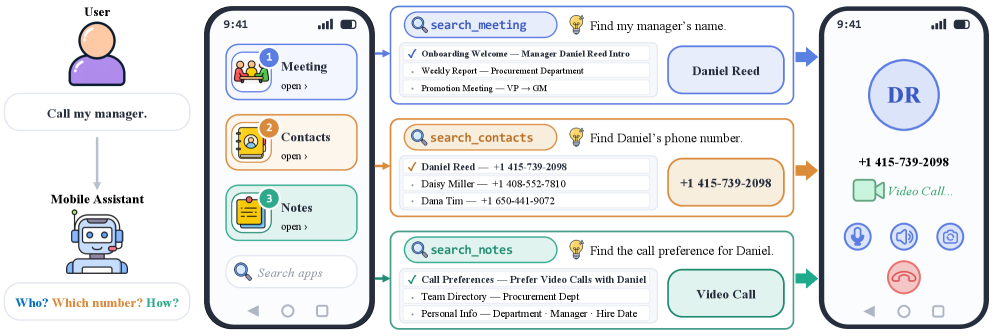
大型语言模型(LLM)越来越多地被部署为移动助手,其核心挑战在于利用分散在多个应用(APP)中的个人信息来完成用户指令。然而,由于缺乏专门的基准测试,其能力仍知之甚少。为填补这一空白,我们提出了 SPIEval,一个基于五种认知能力(即推理、消歧、整合、偏好推断和多意图分解)的人工策划基准。 SPIEval 包含 250 个任务,涵盖分布在 10 个应用中的 4,335 条个人记录,并通过 21 个工具支持多轮交互。分析表明,该基准具有场景多样、任务具有挑战性、信息分散、环境可控和结果可验证等特点。 我们评估了九个代表性的 LLM,发现仍有较大改进空间。表现最好的模型 GPT-5.5 (xhigh) 准确率仅为 57.3%,而最弱的模型准确率仅为 16.4%。进一步分析显示,79% 的失败源于不准确的信息定位,因为 LLM 常常固守于看似合理但错误的信息,而不是继续检索进行验证。我们还发现,只有不到 2% 的检索操作采用了高级搜索方法,并且不同模型的搜索效率存在显著差异。 这些发现揭示了当前基于 LLM 的移动助手的根本局限性,并激励了该方向的未来研究。数据和代码可在 https://huggingface.co/datasets/Junjie-Ye/SPIEval 获取。
论文精读
TL;DR SPIEval 基准用 250 个跨 10 个 app、4,335 条个人记录的任务评估 LLM 移动助手;最好模型仅 57.3% 准确率,79% 失败源于信息定位不准而非推理。
问题
问题背景
当前 LLM 正被快速部署为移动助手,核心挑战在于利用分散在多个应用中的个人信息完成用户的简短、模糊指令。
现有方法局限
现有评估基准主要存在以下局限:
- 信息假设过于理想:多数基准假设个人信息已预先给定或只需单次检索,未建模真实场景中信息分散在多个 app、需多步工具调用和动态验证的过程。
- 任务类型单一:缺乏对推理、消歧、整合、偏好推断、多意图分解等认知能力的系统性覆盖,导致 LLM 在真实移动助手场景下的能力评估严重不足。
- 交互与工具支持弱:仅少量工作支持多轮交互和丰富的工具调用,难以反映模型在复杂信息检索与操作中的实际表现。
为什么这个问题难 / 重要
移动助手任务中,用户指令往往极简且充满歧义,模型需要:
- 准确判断所需信息类型与来源;
- 在 10 个 app、4,335 条个人记录中定位相关信息;
- 通过 21 种工具执行多步检索、验证与整合。
实验显示,当前最强模型 GPT-5.5 (xhigh) 仅达到 57.3% 准确率,最弱模型仅 16.4%。更关键的是,79% 的错误源于信息定位不准确——模型倾向于接受看似合理但错误的信息,而非继续检索验证。此外,高级搜索方法的使用率不足 2%,搜索效率在不同模型间差异巨大。这些发现暴露了现有 LLM 移动助手的根本性缺陷,对行业部署构成直接挑战。
行业类比
这类似于 AI 驱动的个人知识管理助手:需要从邮件、日历、笔记、任务列表等多源数据中抽取并交叉验证信息,才能可靠地执行复杂指令。
核心洞察
- SPIEval 将"信息定位"作为独立评估维度,发现 79% 的任务失败源于检索不准确而非推理不足。与现有基准只测最终答案正确性或单步工具调用不同,SPIEval 通过任务构造显式区分"找到正确信息"与"基于信息推理",揭示当前 LLM 在开放环境中倾向于接受第一个看似合理的检索结果便停止搜索,而不是继续验证。这一发现把移动助手瓶颈从模型认知能力转移至搜索策略与不确定性校准,提示工程实践需引入验证式检索机制、主动信息获取奖励,而非仅增大模型参数或优化提示词。
- SPIEval 量化了多工具检索中的策略效率,发现不足 2% 的检索动作使用高级搜索方法(如过滤、排序、正则),且模型间搜索效率差异远超准确率差异。现有 tool-use 基准通常只评估是否选对工具并返回正确结果,忽略了多轮工具调用中的资源消耗与路径规划。SPIEval 在 10 个应用、4,335 条记录、21 个工具的稀疏环境中记录每次检索动作,暴露出模型普遍依赖低效的全表扫描式查找,导致 token 和延迟开销巨大。这提示移动助手工程优化应聚焦于搜索规划器、工具组合策略与元认知提示,而非进一步提升单次工具调用的执行成功率。
方法
输入与任务定义
SPIEval 将移动助手任务形式化为:给定一条简短、含歧义的用户指令,以及散布在 10 个 app 中的 4,335 条个人记录,模型需要通过多轮工具调用完成指令。输入包含用户指令、用户画像与系统提示、应用 schema 与工具 schema。
关键模块
- 认知能力框架:每个任务标注五项能力之一或组合——推理、消歧、整合、偏好推断、多意图分解,确保覆盖真实场景。
- 可控环境:定义 21 个工具,允许模型检索、浏览、过滤个人信息;环境提供确定性的 app 状态和返回结果,保证可验证。
- 数据构建:人工策展 250 个任务,4,335 条记录分布在不同 app,要求跨应用信息整合;任务设计强调信息分散、场景多样、结果可判定。
- 评估与诊断:以最终答案正确率为主要指标;额外追踪检索轨迹,统计信息定位错误占比、高级搜索方法使用率、搜索效率等。
输出与结论
模型输出最终答案,评测系统比对标准答案;进一步分析失败模式,发现 79% 失败源于信息定位错误,且 <2% 检索动作采用高级搜索。
与同类工作相比,SPIEval 显式以五类认知能力为框架,侧重分散个人信息下的跨应用检索与消歧,而非单一 app 内操作或通用 agent 能力。
实验
实验设计叙述
SPIEval 是人工策划的基准,包含 250 个任务,涉及 4,335 条个人记录,分布在 10 个应用 中,支持 21 个工具 的多轮交互。评估对象为九个代表性 LLM,包括 GPT-5.5 (xhigh) 等。任务要求模型从分散的个人信息中检索、整合并回答用户指令,覆盖推理、消歧、集成、偏好推断和多重意图分解等认知能力。评估指标为任务准确率,并进一步分析失败原因与检索行为。
关键发现
- 最佳模型 GPT-5.5 (xhigh) 仅达到 57.3% 准确率,最差模型为 16.4%,差距达 40.9 个百分点,说明当前 LLM 作为移动助手远未成熟。
- 79% 的失败 源于不准确的信息定位:模型经常承诺看似合理但错误的信息,而不是继续检索进行验证。
- 检索动作中 不到 2% 使用了高级搜索方法,模型普遍依赖简单查询,搜索效率存在显著差异。
与基线对比的深度解读
各模型间性能差异巨大,表明模型的基础推理和工具调用能力是瓶颈,而非单纯数据规模问题。信息定位错误的高占比凸显了 检索-验证循环 的缺失:模型缺乏反思机制,容易在首次检索不充分时过早给出答案。高级搜索方法使用率极低进一步说明现有 agent 工作流未能有效利用工具能力。工程上需要设计强制验证步骤、多步检索规划 和基于置信度的重试机制,将信息定位从一次性猜测转变为可审计的过程。
行业影响
落地场景
LLM 移动助手正在进入系统级助手、电商购物 App、健康管理等场景。SPIEval 直接覆盖此类产品的核心挑战:用户指令简短模糊,需跨多个 app 检索、整合个人数据。例如电商助手需同时查询订单、地址、优惠券和偏好来回答“包裹何时到?有哪些可用优惠券?”。SPIEval 提供 250 个真实任务、21 个工具和多轮交互评测,帮助量化模型的信息定位、推理和多意图分解能力。
商业价值
SPIEval 揭示的关键短板——79% 失败源于信息定位不准确,模型常坚持错误信息而不继续验证——直接影响用户信任和人工客服成本。引入 SPIEval 作为回归测试,团队可:
- 降低错误回答导致的客服工单或退货损失
- 提升任务完成率,减少多轮修复,优化用户体验
- 通过优化检索策略提高搜索效率,当前 <2% 使用高级搜索,可显著降低 token 消耗和延迟
最佳模型 GPT-5.5 (xhigh) 仅 57.3% 准确率,表明提升空间巨大,优先解决定位问题的产品可形成差异化。
与现有产品/工作流接口
SPIEval 可直接作为标准 evaluation suite 集成到现有 LLM 开发流程:
- 配合 RAG 或 function calling 框架,评测不同检索、召回排序和验证机制
- 通过 HuggingFace
datasets库加载,嵌入 CI 测试,监控模型升级后的能力回退 - 工具 schema 清晰定义,可与 MCP / Tool Use API 对齐,让评测环境与生产工具链一致
具体落地 use case
- 电商购物助手:跨订单、地址、优惠券、历史偏好回答用户指令。SPIEval 的
integration和preference inference能力评估多源整合与个性化推荐,定位错误会导致推荐不相关或漏用优惠,影响 GMV。 - 健康管理 App:个人健康助手整合可穿戴数据、日历、用药记录。SPIEval 的
disambiguation和reasoning能力帮助减少误导性建议,提升依从性和安全性。
局限
- **数据集规模与覆盖范围有限**:SPIEval 包含 250 个任务、4,335 条个人记录,仅覆盖 10 个应用场景。相比真实移动生态中上百种应用和复杂的数据关联,该基准的覆盖度仍显不足,可能无法充分反映 LLM 在更广泛、更多样化的个人数据环境下的表现。此外,任务设计由人类策划,虽保证了质量,但可能引入主观偏差,且难以穷举所有真实用户意图的组合。
- **评估环境简化了真实移动交互的复杂性**:基准中的工具调用和检索策略相对理想化,未充分模拟真实场景中的噪声、权限限制、应用间数据同步延迟、用户中途修改指令等动态因素。研究观察到模型倾向于在检索不完整时过早给出看似合理但错误的答案,但并未进一步分析如何通过强化学习或提示策略来缓解该问题,因此实验结论对实际部署的指导意义有限。
- **与同类基准的对比分析不充分**:论文主要与通用工具使用基准(如 ToolBench、API-Bank)比较,但缺少与更贴近移动助手场景的基准(如 Mobile-Env、AITW)的直接对比。此外,失败分析将 79% 的错误归结为信息定位不准确,但未深入拆解是检索规划、查询改写还是工具选择环节导致,这限制了后续针对性改进的方向。