DistilVDR: 一种通过双学生蒸馏实现的紧凑端到端视觉文档检索器
视觉文档检索(VDR) 目前由数十亿参数模型主导,这些模型在完整语料库规模下索引速度慢且服务成本高昂。先前的压缩路线要么从头训练一个较小的多向量编码器,要么仅对查询侧进行蒸馏;两者都无法获得端到端的紧凑单向量检索器。 我们提出 DistilVDR,一个 5.24亿参数 的端到端 VDR 系统,通过 点式余弦对齐损失 从单个 80亿参数视觉语言教师模型 中进行 双边蒸馏。所有监督信号均来自冻结教师模型的嵌入空间,而该空间本身已通过相关性监督进行训练,因此学生目标无需相关性标签、负采样或对比项。我们以 不对称编码器 匹配 VDR 的文本查询与图像文档输入不对称性,将视觉能力集中于文档侧,并保持查询侧仅有 7000万参数。 我们发布两个共享相同编码器和训练过程的变体,仅文档编码器的视觉块预算不同:DistilVDR-HiRes 在 ViDoRe v1+v2+v3 上达到 61.74 平均 NDCG@5(教师模型 8B 的 86.9%),并在高分辨率敏感的 v3 基准上领先所有复现的子 10 亿参数基线;DistilVDR-Fast 以 3 倍更小 的视觉块预算达到 59.98。两个变体在存储一百万文档时,索引大小比最强的子 10 亿多向量基线小 15.6 倍,索引语料库速度快一个数量级。代码已开源:https://github.com/Ryenhails/NanoVDR。
论文精读
TL;DR DistilVDR 通过双边蒸馏将 8B 视觉文档检索器压缩为 524M 端到端单向量模型,仅用余弦对齐损失,无需相关性标签或负采样;在 ViDoRe 上达到教师 86.9% NDCG@5,索引缩小 15.6 倍且索引速度快一个数量级。
问题
问题背景
视觉文档检索(VDR)需要在大规模图像文档库中按文本查询返回相关页面,当前领先方法多采用数十亿参数的视觉语言模型(VLM)教师,索引和查询编码慢、内存占用高。
现有方法局限
- 从头训练小型多向量编码器(如 ColPali 变体)仍需为每页生成大量 token 级向量,索引体积大、检索慢;
- 仅蒸馏查询端(
query-side distillation)保留了文档侧大模型,无法降低索引成本; - 紧凑单向量检索器通常会牺牲细粒度视觉理解,尤其在高分辨率版式敏感的 benchmark(如 ViDoRe v3)上掉点明显。
为什么这个问题难/重要
VDR 的输入不对称:文本查询短、图像文档长且包含复杂布局、表格、图表。要同时压缩两端、保留对齐空间,需要训练目标既避免对比学习的大 batch 与负采样成本,又不能让 524M 学生仅靠有限数据拟合教师嵌入。业界关注点在于:能否在保持 85% 以上教师精度的同时,将索引体积缩小一个数量级,并提升索引吞吐——这直接决定 VDR 能否用于亿级语料库的在线服务。
行业类比
类似在移动端部署 OCR-free 文档理解时,用紧凑非对称双塔替代云端大模型做首轮召回,既降低延迟又节省存储。
核心洞察
- 双边蒸馏配合点式余弦对齐损失,实现了从 8B 教师到 524M 学生的端到端单向量压缩,且完全无需相关性标签、负采样或对比项。以前的方法要么从头训练小多向量编码器(需要大量标注和负采样),要么仅蒸馏查询侧(文档侧仍庞大),而本工作直接对齐教师嵌入空间,教师本身已含相关性监督,因此学生目标简化为余弦相似度回归,显著降低训练复杂度和数据需求。
- 非对称编码器设计将视觉容量集中到文档编码器(大 tile 预算),而查询编码器仅 70M 参数,精确匹配了 VDR 中文本查询简短、图像文档信息丰富的输入不对称性。这与许多统一嵌入模型对称处理查询和文档的做法不同,避免了在查询侧浪费计算;也不同于仅压缩查询侧的方法,后者无法减小文档侧索引。该设计使 HiRes 变体在 ViDoRe v3 上领先所有 sub-1B 基线,同时索引大小比最强 sub-1B 多向量基线小 15.6 倍。
方法
输入与任务定义
DistilVDR 处理视觉文档检索(VDR):输入为文本查询 query 与图像文档 document,输出为各自单向量嵌入,用于点积相似度排序。训练阶段使用冻结的 8B vision-language teacher 预先编码所有 query 和 document,得到教师嵌入作为监督。
关键模块:非对称双学生编码器
学生由两个独立编码器组成,共享训练但结构非对称:
- Query encoder(约 70M 参数):轻量文本编码器,只处理查询文本,不引入视觉模块,保持低延迟线上推理。
- Document encoder(总系统 524M,文档侧占主要参数):编码图像文档为单向量。采用 动态 tiling 算法将文档切分为可变数量的视觉 tile,
visual-tile budget控制视觉 token 数。发布两个变体 DistilVDR-HiRes 与 DistilVDR-Fast 仅在此预算上不同(后者为前者的 3× 更小视觉 token 预算)。
蒸馏目标:点对点余弦对齐
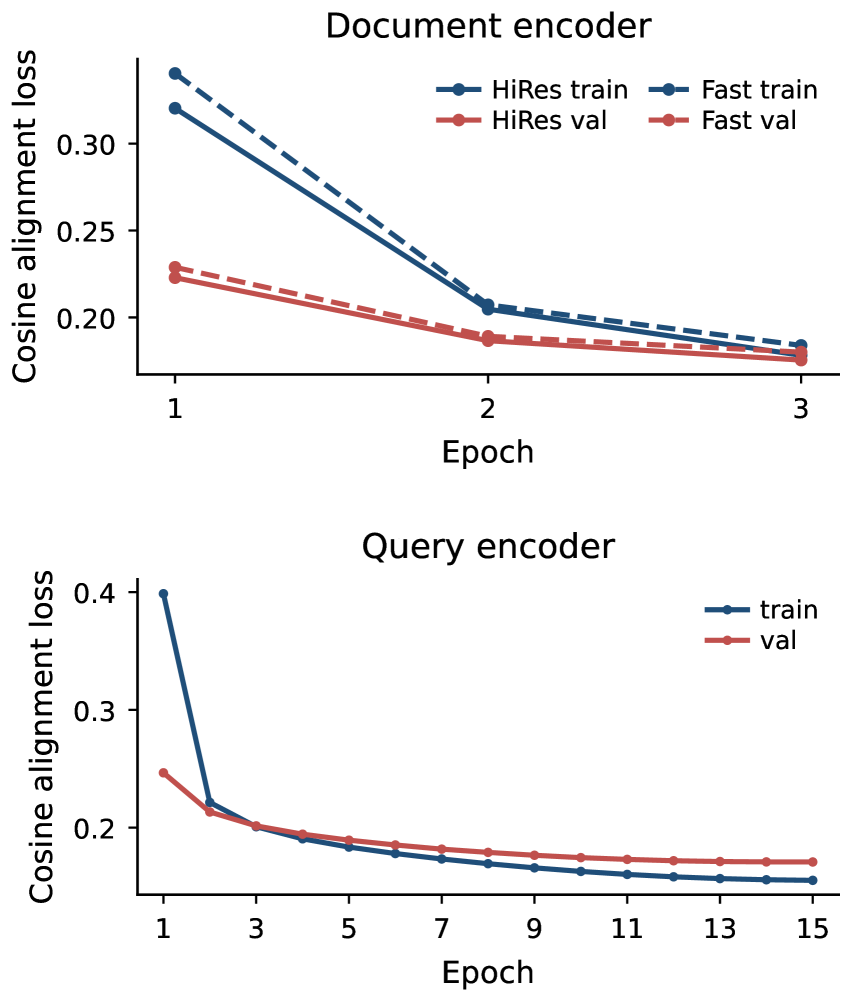
损失函数为 pointwise cosine alignment loss:对于每个输入样本,最小化学生 query 嵌入与教师 query 嵌入的余弦距离,以及学生 document 嵌入与教师 document 嵌入的余弦距离。由于教师嵌入空间已在相关性监督下训练,学生无需任何相关性标签、负采样或对比项,仅通过回归教师嵌入即可隐式继承排序能力。训练完全离线预计算教师嵌入,避免教师在线计算开销。
推理流程
推理时,query 和 document 分别经过学生对应编码器,输出单向量;文档索引存储为紧凑单向量,支持 ANN 快速检索和 15.6× 索引压缩。
与同类方法的差异:不同于“小多向量从头训练”或“仅蒸馏 query 侧”,DistilVDR 首次实现双边蒸馏下的端到端单向量 VDR,且完全去除对比损失与负采样。
实验
实验设计
DistilVDR 在 ViDoRe v1/v2/v3 三个基准上评估,以平均 NDCG@5 为主指标,重点关注对高分辨率敏感的 v3 基准。学生模型采用 524M 参数的不对称 encoder-only 架构,从单个 8B 视觉-语言教师模型通过逐点 cosine alignment loss 蒸馏,无需任何相关性标签、负采样或对比项。训练监督完全来自冻结教师嵌入空间,避免了昂贵的相关性标注。
关键发现
- DistilVDR-HiRes 平均 NDCG@5 达 61.74,达到 8B 教师模型的 86.9%,并在 v3 基准上领先所有复现的 sub-1B 基线。
- DistilVDR-Fast 以仅 1/3 的视觉 token 预算取得 59.98,实现了精度与效率的灵活折中。
- 两个变体存储 100 万文档的索引比最强的 sub-1B 多向量基线小 15.6 倍,索引速度提升一个数量级。
基线对比解读
多向量基线通常需要为每个文档存储多个向量,导致索引体积庞大且构建缓慢。DistilVDR 回归单向量表示,在几乎不损失精度的前提下大幅降低存储与计算开销。HiRes 在 v3 上的领先表明,对高分辨率敏感场景分配更多视觉 tile 可有效捕获细粒度信息。不对称设计将查询侧压缩至 70M 参数,适合低延迟在线查询,而文档侧集中视觉容量,贴合 VDR 输入特征。整体方法摆脱了对相关性标签的依赖,降低了数据获取门槛,对实际工程部署具有显著意义。
行业影响
落地场景
DistilVDR 适用于需要大规模视觉文档检索的业务,如企业知识库搜索、电商商品图像检索、内容平台的图文混合推荐等。以企业服务为例,法务、合规部门可对扫描合同、PDF 报告进行 OCR-free 语义搜索,直接输入自然语言查询定位包含特定图表或条款的页面。在电商场景中,用户上传商品截图即可检索相似在售商品或详情页,无需 OCR 前置处理。ViDoRe v3 上的高分辨率表现表明其擅长处理版式复杂、小字号密集的文档,适合金融研报、医疗文献等场景。
商业价值
核心降本来自索引体积与推理延迟的压缩:100 万文档的索引比最强 sub-1B 多向量基线小 15.6 倍,索引速度快一个数量级,可显著降低向量数据库的存储与计算成本。DistilVDR-Fast 在 3 倍更小的视觉 token 预算下仍保持高精度,允许根据业务需求在精度与成本间取舍。体验提升体现在单向量检索的低延迟,适合交互式搜索或高频 API 调用,同时接近 8B 教师的精度(86.9%)保证了结果质量。对企业知识库产品而言,更低的基础设施成本可转化为更具竞争力的定价或更高的毛利率。
跟现有产品/工作流的接口
DistilVDR 输出单向量,可直接存入 FAISS、Milvus、Qdrant 等标准向量数据库,无需定制多向量索引结构。在 RAG 流水线中,可替换掉重型视觉-语言检索器,或作为混合检索的第一阶段召回器,再配合重排序模型提升精度。两个变体(HiRes / Fast)共享编码器与训练,切换时只需修改文档编码器的视觉 tile 预算,无需重新训练。与现有 LLM 应用框架(如 LangChain、LlamaIndex)的集成方式与普通 dense retriever 一致,代码与权重已在 GitHub 和 HuggingFace 发布,便于快速评估与部署。
局限
- **教师依赖与上限**:DistilVDR 的性能严格受限于 8B 教师模型的能力,学生无法超越教师。论文未探讨更换更强教师或集成多教师蒸馏的影响,也未验证教师在不同领域数据上的泛化边界。若教师嵌入空间存在偏差或对某些文档类型敏感,该偏差会被蒸馏传递到学生,实际部署时可能需要针对特定语料重新蒸馏或微调,增加工程成本。
- **性能差距与绝对分数**:HiRes 变体平均 NDCG@5 为 61.74,仅达到教师的 86.9%,在要求高精度召回的场景(如法律、医疗文档检索)中仍有明显差距。Fast 变体以 3 倍视觉 token 预算缩减为代价进一步降至 59.98,效率与效果之间需要依据业务需求谨慎权衡。同时,论文未报告召回率指标,仅用 NDCG@5 可能掩盖长尾文档的检索质量。
- **实验覆盖与对比不足**:评估仅依赖 ViDoRe v1+v2+v3 基准,缺乏更多样化的 VDR 任务(如网页截图、复杂表格、手写文档)验证,跨领域泛化能力存疑。Baseline 全部为复现的 sub-1B 模型,未与量化、剪枝、稀疏化等其他压缩技术系统对比,也未与更大规模的非压缩模型在相同延迟预算下比较,因此难以全面定位 DistilVDR 在模型压缩图谱中的相对优势。