SWE-Bench ProMax: 大规模多语言代码重构智能体基准测试
随着 AI 编码智能体承担日益复杂、长周期的软件工程任务,现有基准迅速饱和,其评估质量也受到严重质疑:一项近期审计发现,SWE-bench Verified 中近 60% 的未解决实例存在缺陷测试——或过于狭窄而拒绝正确方案,或过于宽泛而检查未声明需求——且前沿模型能从训练数据中原样复现黄金补丁。代码重构要求跨多文件进行协调一致、保持行为不变的修改,为智能体能力提供了更难、更真实的考验,但现有基准对此覆盖不足。 我们推出 SWE-Bench ProMax,一个专家策划的多语言代码重构基准,包含来自七个编程语言(Python、Java、TypeScript、Go、C、C++、Rust)真实提交的 170 个实例。每个实例都经过严谨的多阶段筛选,直接针对此前基准中发现的质检问题:问题描述被彻底重写以提供精确无歧义的规格说明,测试套件经人工审查以剔除过窄和过宽的测试。过滤掉复杂度不足或跨文件范围有限的任务后,该基准包含具有挑战性的大规模重构任务,平均每个实例修改 11.4 个文件、261.6 行代码,远超现有基准的规模。 使用两种智能体框架对前沿模型的实验表明,最佳模型仅达到 41.2% 的解决率,证实 SWE-Bench ProMax 为当前 AI 编码智能体提供了一个有意义且尚未饱和的挑战。基准已发布于 https://huggingface.co/datasets/swe-bench-promax/SWE-Bench-ProMax。
论文精读
TL;DR SWE-Bench ProMax 针对现有基准的测试缺陷、数据泄露及饱和问题,构建了面向大规模多语言代码重构的严格基准,任务平均涉及 11.4 个文件、261.6 行代码,前沿模型解决率仅 41.2%,提供了更具现实挑战的评估。
问题
问题背景
AI 编程代理正从简单函数级补丁迈向跨文件、长周期的复杂软件工程任务,然而现有基准(如 SWE-bench Verified)的评估质量正面临严峻挑战。
现有方法局限
近期审计发现,SWE-bench Verified 中近 60% 的未解决实例存在测试缺陷:测试用例要么过于狭窄(拒绝正确但形式不同的补丁),要么过于宽泛(检测到任务描述未声明的需求),导致评估噪声极高。此外,前沿模型有时能直接从训练数据中逐字复现 gold patch,而非通过推理生成解决方案,使基准得分虚高。另一关键缺口是代码重构——这类需要协调多文件行为保持变更的任务,在现有基准中几乎缺席。已有的少数重构基准(如 CodeReviewer、Refactory)或规模过小,或语言单一,无法反映真实工程中动辄几十个文件、跨模块协调的重构挑战。
为什么这个问题难且重要
代码重构的难点在于:必须理解变更的全局语义,确保行为保持,同时涉及依赖分析、接口适配和回归测试修正,对代理的长上下文理解与多步规划能力要求极高。行业对 AI 编程助手的需求正从单个函数补全转向项目级重构(如框架升级、API 迁移),若无法可靠评估这类能力,则无法验证代理在生产环境中的实用性。当前最佳模型在全新基准 SWE-Bench ProMax 上仅取得 41.2% 的解决率,表明该任务远未饱和,是衡量代理是否具备真正工程推理的有效标尺。
行业类比
如同自动驾驶需要从封闭场地测试走向真实城市路网,AI 编程代理也必须通过大规模、多语言、跨文件的重构任务,才能证明其具备处理真实代码库演化的能力。
核心洞察
- **现有基准测试的评估质量缺陷可能严重误导模型能力判断**。本研究发现 SWE-bench Verified 中近 60% 未解决实例的测试存在过严或过宽问题,且模型可能靠记忆训练数据中的补丁通过测试,导致解决率虚高。SWE-Bench ProMax 通过对问题描述全量重写、人工审核测试套件、过滤低复杂度任务,直接消除了这些混杂因素,使评估更准确地反映代理的真实泛化能力,而非记忆或利用测试漏洞。
- **大规模跨文件重构是比修补 bug 更困难且更真实的智能体能力试金石**。该基准将任务设定为行为保持的代码重构,要求代理协调修改多个文件,平均每个实例涉及 11.4 个文件和 261.6 行代码,远超现有基准的单文件或小范围修复。这一设定切中了大型软件工程中缺乏精确规格的长程任务,迫使模型理解全局依赖并保持系统行为一致,目前最佳模型仅 41.2% 的解决率表明该方向仍有巨大提升空间。
方法
任务定义
SWE-Bench ProMax 将代码重构任务形式化为:给定一个代码库和一段精确的重构需求描述(issue),要求 AI 智能体生成行为等价的补丁(patch),修改跨多个文件的代码,并通过严格的人工审核测试套件验证。
数据集构建流程
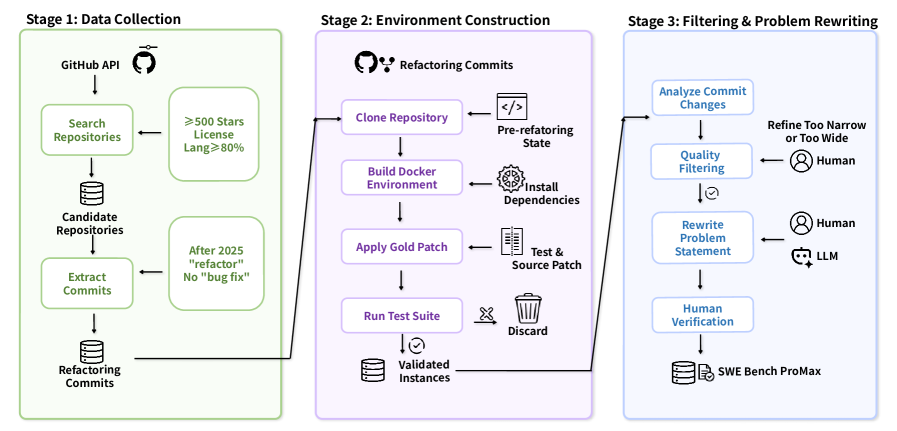
构造过程分为三个关键阶段,直接针对上一代基准(如 SWE-bench Verified)暴露的严重质量问题:约 60% 未解决实例的测试存在缺陷(测试范围过窄或过宽),且前沿模型能直接从训练数据中复制补丁。
数据收集
从 GitHub 上 7 种编程语言(Python、Java、TypeScript、Go、C、C++、Rust)的真实提交中抽取候选重构实例,确保问题源自实际开发场景。环境构建
为每个实例构建可复现的执行环境,锁定依赖版本,确保智能体能在隔离环境中运行测试和验证补丁。过滤与问题重写
- 复杂度过滤:丢弃跨文件范围不足、修改量过小的任务,保留平均修改 11.4 个文件、261.6 行代码的大规模重构。
- 问题描述重写:专家从零重写 issue 描述,提供精确、无歧义的重构规格,避免原 issue 中的模糊或隐含需求。
- 测试套件审核:人工逐条检查测试,移除范围过窄的测试(错误拒绝正确方案)和范围过宽的测试(检查未声明的需求),仅保留行为等价性验证的核心测试。
输出与质量保证
最终基准包含 170 个实例,覆盖多种重构类型(如重命名、移动抽象、API 迁移)。所有测试均能在隔离环境中稳定运行,评估时以 pass@k 或解决率(Resolve Rate)为主指标。
与同类方法的差异
不同于 SWE-bench 系列以缺陷修复为主且测试质量参差,SWE-Bench ProMax 专注于跨文件、行为保持的多语言重构,并通过多阶段专家整理彻底消除测试缺陷,为长周期软件工程任务提供了更难且更彻底的评估基准。
实验
实验设计
评估在 SWE-Bench ProMax 的 170 个实例上进行,覆盖 Python、Java、TypeScript、Go、C、C++、Rust 七种语言。每个任务均提供经专家重写的精准问题描述和手工审查的测试套件,平均涉及 11.4 个文件 和 261.6 行代码 的修改。实验采用两种 agent 脚手架(如 SWE-agent 和 OpenHands 等),以统一环境执行并统计 Resolve Rate 指标。
关键发现
当前最前沿模型在最大难度重构任务上仅达到 41.2% 的成功率,对比其在 flawed 的 SWE-bench Verified 上近饱和的表现形成巨大落差。分析显示,模型在多文件协同、跨文件依赖管理及重构后语义保持方面频繁失效,尤其当修改规模扩大时,agent 难以维持全局一致性。
与基线对比的深度解读
与饱受测试缺陷和数据泄露困扰的 SWE-bench Verified 相比,ProMax 以更严格的质量控制和更大规模的跨文件任务,揭示了现代 AI 编码代理的真实短板。Resolve Rate 远低于传统单文件 benchmark 预示着,向生产级长周期软件工程任务迈进,仍需在长程规划、跨文件上下文统一及精确的行为保持验证上取得突破。
行业影响
落地场景
SWE-Bench ProMax 瞄准的是大型软件工程中的跨文件、行为保持的代码重构,这在企业级产品与业务中极为普遍:
- 遗留系统现代化:电商、金融等领域常需将单体老代码(如 Java/C++)拆分为微服务,或迁移到新语言(Rust/Go),直接涉及成百上千文件的同步修改。
- SDK 与框架升级:内容平台、企业服务的 SDK 大版本发布时,需跨多仓库统一 API 签名、类型定义,AI 代理可自动完成此类重复性重构。
- 合规与代码审计:医疗、自动驾驶等安全敏感系统必须落实编码规范(如 MISRA C++),批量重命名、依赖解耦等重构可由 AI 驱动,显著降低人工审查成本。
商业价值
该基准直接验证了 AI 编程代理的自动化降本能力:
- 降本:当前最佳模型仅 41.2% 解决率,但已能处理平均 11.4 文件、261.6 行的任务,每实例可节省资深工程师数小时手动操作,直接压缩项目维护和迁移开支。
- 提质:严格的测试评估(剔除过宽/过窄测试)确保重构后的行为等价性,避免生产事故,提升系统可靠性与团队交付信心。
- 加速创新:通过该基准筛选出的强重构能力模型,可快速集成到内部工具链,让研发团队聚焦业务逻辑而非架构调整,加快产品迭代。
与现有工作流的集成
SWE-Bench ProMax 的设计天然适合嵌入现有 AI 软件开发生命周期:
- 基准评估:可直接为 SWE-Agent、OpenHands 等代理框架提供多语言、长程重构的标准化评估,辅助技术选型与持续优化。
- 模型微调:企业可抽取该数据集的实例-补丁对,微调内部代码大模型(如 CodeLlama、DeepSeek-Coder),增强其对大规模重构的规划与代码生成能力。
- CI/CD 集成:将经过验证的模型部署为 CI 管道中的 自动重构 bot,当代码合入触发重构 Issue(如“请将所有
print调用迁移到logging.logger”)时,代理生成 Pull Request 并附行为保持验证结果,人工仅需复核合并。
具体落地用例
- 电商大促架构改造:某电商平台计划将核心订单模块从 Python 单体 拆分为微服务,需跨 30+ 个仓库统一 API 调用方式。AI 代理根据 SWE-Bench ProMax 式规范生成变更,并在隔离环境中运行测试套件,保证功能不变,可将原本需数周的人工作业压缩至天内。
- 金融核心系统 Rust 迁移:一家金融科技公司将交易引擎从 C++ 迁移到 Rust,涉及内存安全重构与大量文件重命名。利用在该基准上验证过的代理,自动扫描目标代码库并生成可编译、测试通过的补丁,降低关键系统的迁移风险与人力成本。
局限
- - **数据集规模与泛化性限制**: SWE-Bench ProMax 仅包含 170 个精心策划的实例,虽然实例平均修改文件数达 11.4 个、平均代码行数为 261.6,但总量较小,可能无法覆盖重构任务的全部类型与真实世界的复杂性。实例提取自特定开源项目的历史提交,编码风格和上下文耦合度高,可能导致模型在陌生项目或不同编程规范下的泛化能力验证不足。同时,多阶段人工审查成本高昂,限制了数据集的快速扩展与定期更新,长期可维护性存疑。 - **评估生态与覆盖范围**: 当前实验仅使用两种 Agent 脚手架进行评测,难以全面反映各类 AI 编码工具的真实能力,不同工具链、提示策略或执行环境的差异可能导致排序不稳定。此外,基准聚焦于行为保持型重构,排除了需求分析、架构设计、持续集成等其他关键软件工程活动,对 Agent 整体工程能力的刻画较为单一。最后,论文未充分讨论本数据集被前沿模型训练数据污染的可能性,若未来模型记住了这些实例,评估有效性将再次受到威胁。