RynnValue: 基于时间距离扩展机器人价值基础模型
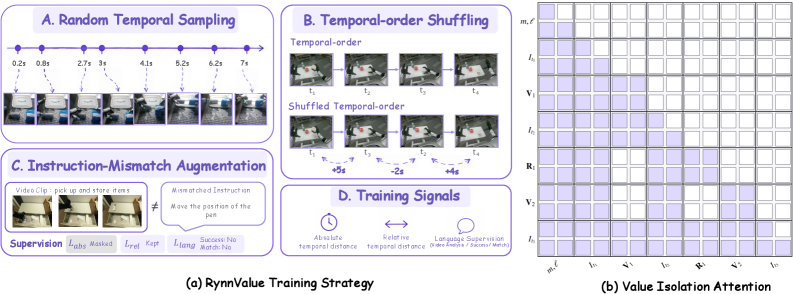
通用奖励模型日益成为扩展机器人学习的瓶颈,但从大规模异构数据中学习价值相关能力的配方仍未被充分探索。现有方法将监督信号绑定到任务内部锚点(如偏好或归一化进度),这些锚点均无法跨具身形态和数据源干净迁移。我们提出 RynnValue,一个开源的机器人操作价值基础模型,用 时间距离(temporal distance)取代上述锚点,即从观测到语言指定目标的定向代价(cost-to-go)。由于时间距离标签可直接从时间戳中导出,RynnValue 无需偏好或进度标注 即可扩展到超过 7,000 小时、约 300 万条指令条件片段。 为使时间价值学习在大规模下可靠,我们结合 随机时间采样、时间顺序打乱 和 价值隔离注意力(value-isolation attention),抑制会使预测对失败和退化不敏感的捷径。在没有任何偏好标签的训练下,RynnValue 在 RBM-EVAL-OOD 上达到平均 Kendall's taua 0.675,超越完全偏好监督的最先进方法(0.655),并且是仅进度监督基线(0.292)的两倍以上,同时零样本泛化到未见任务、具身形态和视角。 通过基于势的塑形(potential-based shaping)转换为密集奖励后,RynnValue 将真实世界策略成功率从 52.5% 提升至 72.5%(在线),从 63.8% 提升至 82.5%(离线)。这些结果确立了 时间距离 作为可扩展的监督目标和通用机器人策略的实用奖励接口。
论文精读
TL;DR RynnValue 以时间距离替代偏好标注,在 7000+ 小时异构数据上训练机器人价值基础模型,零样本泛化超越偏好监督 SOTA,并大幅提升真实世界策略成功率。
问题
问题背景
通用奖励模型(reward model)正成为扩展机器人学习(robot learning)的关键瓶颈。随着异构机器人数据的急剧增长,如何从大规模、多形态(embodiment)的数据中学习可迁移的价值函数(value function),以驱动通用策略学习,是领域关注的焦点。
现有方法局限
现有的价值学习监督方式通常绑定于任务内部锚点(task-internal anchors),主要包括两类:
- 偏好标注(preference labeling):依赖人工对比不同行为片段并给出偏好判断,标注成本极高且难以标准化,跨数据源和机器人平台迁移时偏好标准不一致,导致泛化能力严重受限。
- 标准化进度(normalized progress):通过任务进度(如开柜门的角度百分比)定义奖励,但这种进度定义高度依赖于具体任务和机器人形态,无法直接迁移到新任务或新平台,且许多操作任务难以定义连续的进度量。 这些方法本质上将奖励建模与特定任务的成功准则或主观偏好耦合,无法形成可跨任务、跨形态复用的通用价值表达。
为什么这个问题难/重要
从大规模异构机器人语料中学习通用价值模型面临两大技术挑战:
- 监督信号的通用性:理想的监督信号应完全脱离任务特定假设,仅从数据本身可计算,从而保证跨任务、跨形态的迁移能力。
- 对失败行为的敏感性:价值模型必须能区分成功与失败,避免被数据中的捷径(shortcut)所误导,例如仅靠视觉外观而非实际任务进度就给出错误的高价值预测。 时间距离(temporal distance)——即从当前观测到语言指定目标所需的定向时间成本——天然满足第一个要求,因为它可以直接从时间戳推导,无需任何任务相关的先验。这使得它能低成本覆盖超7000小时、约300万条指令条件的机器人操作片段。然而,单纯引入时间距离标签易受时间序列固有模式影响,导致模型对倒退或失败不敏感(如抓取后掉落物体仍被预测为高价值)。RynnValue 通过随机时间采样、时序混排、价值隔离注意力等训练策略,有效抑制了此类捷径,使价值预测真正与任务进度对齐。
业内日益关注能零样本泛化的奖励接口:一个预训练的价值基础模型,能为任意新任务提供稠密奖励,大幅降低真实世界策略学习的数据需求和试错成本。
行业类比
类似视觉-语言模型(如 CLIP)从海量图文对中学习通用对齐,再零样本迁移到下游视觉任务,价值基础模型从时间对齐的机器人操作数据中学习通用的“任务进展感”,为通用机器人策略提供即插即用的奖励信号。
核心洞察
- - **以时间距离为通用奖励接口,突破跨具身与数据源的监督瓶颈**:现有方法依赖偏好或归一化进度作为任务内锚点,难以在不同机器人形态和数据分布间迁移。RynnValue 用时间戳直接导出时间距离(即到达语言指定目标的 cost-to-go),无需人工标注即可从异构海量数据(7000+ 小时,约 3M 片段)中学习。这种监督信号天然与具身无关,为价值基础模型的大规模扩展提供了可落地的配方。
- - **价值隔离注意力强制模型感知失败与退化,避免时间排序捷径**:单纯的时序信息会让模型仅依赖观测帧的顺序,忽视任务是否执行成功。RynnValue 通过随机时序采样、顺序打乱和价值隔离注意力,显式抑制对帧间时间接近度的直接编码,迫使模型关注失败片段和价值回归。这一设计使仅用时间距离训练的模型在 RBM-EVAL-OOD 上的 Kendall's τₐ 达到 0.675,超越全量偏好训练的 SOTA(0.655),并带来零样本泛化能力。
方法
输入
模型以 历史图像序列 与 语言指令 为输入,无需额外的偏好标注或进度归一化。通过从混杂数据源(多具身、多任务)中读取时间戳,直接为每一对观测–目标计算 时间距离 (temporal distance)——即从当前状态到语言指定目标所需的代价步数估计。
关键模块
架构基于 Transformer,包含四个核心设计:
- 分组时间查询 (Grouped temporal queries):将多帧图像编码后,引入可学习的查询向量组,分别负责预测绝对时间距离、相对时间顺序以及自然语言对齐。
- 连续时间读出 (Continuous temporal readouts):输出连续值,避免离散化导致的精度损失。
- 价值隔离注意力 (Value-isolation attention):显式屏蔽观测–观测之间的注意力,迫使模型仅通过任务进展信号进行推理,从而消除对失败与回退的预测短路径。
- 自然语言视觉分析:附加的视频–语言对齐模块,用于指令正确性验证,提升模型对语言条件的敏感性。
训练策略
训练目标的构建不依赖人工标注:
- 时间距离重标记:利用记录中的时间戳自动为每一帧分配到目标帧的剩余步数作为标签。
- 随机时间采样与顺序打乱:在多帧采样时随机打乱时间顺序,防止模型仅凭帧间视觉连续性推断,迫使学习真正的时间距离。
- 指令不匹配增强:以一定概率配对不同指令,训练模型区分相关与无关条件。
- 联合损失:
- 绝对时间距离回归损失 (L1 或 Huber)
- 相对时间距离排序损失 (成对比较)
- 自然语言对齐损失 (对比学习)
输出与奖励接口
推理时,模型对给定观察和指令输出 时间距离曲线。通过基于势能的塑形函数 (potential-based shaping):
[ r_t = \gamma \Phi(s_{t+1}) - \Phi(s_t) ]
其中 (\Phi) 为负的时间距离预测值,该信号作为密集奖励直接注入强化学习框架,指导策略学习。
与同类方法的差异
相较于依赖偏好比较 (如 RLHF) 或归一化进度 (如 progress-based reward) 的方法,RynnValue 使用原始时间戳作为唯一监督源,无需跨具身适配标签空间,天然支持零样本泛化到新任务和视角,同时训练数据规模达到 7000+ 小时,验证了时间距离作为通用价值接口的可行性。
实验
实验设计
RynnValue 利用超过 7000 小时的多机器人操作视频,通过时间戳自动标注时间距离 (temporal distance),训练通用价值基础模型。评估分为两部分:
- 在 RBM-EVAL-OOD 基准上,零样本测试指令-轨迹对齐能力,指标为 Kendall's tau_a。
- 在真实世界机器人操作任务中,将时间距离价值转换为稠密奖励,分别用于离线 RL (IQL) 和在线 RL (DSRL) 策略训练,对比基于偏好或进度的奖励模型。
关键发现
- 无需任何偏好标注,RynnValue 在 RBM-EVAL-OOD 上的 Kendall's tau_a 达到 0.675,超越完全由偏好监督的 SOTA 模型 (0.655),比仅用进度的模型 (0.292) 高出一倍以上。
- 转换为潜在奖励后,在线策略成功率从 52.5% 提升至 72.5%,离线策略成功率从 63.8% 提升至 82.5%,表明时间距离是一种高效、可扩展的通用奖励接口。
与基线的深度对比
与主流偏好标注范式不同,RynnValue 的时间距离标签可从时间戳自动生成,无需人工标注,且天然跨具身、跨数据源迁移。随机时间采样、时序打乱与值隔离注意力 (value-isolation attention) 的组合,有效抑制了从时间戳学习价值时的捷径问题,使模型对失败和回退保持敏感,从而在分布外任务和不同视角下仍能输出一致的价值评估。这一结果突破了奖励模型必须依赖任务内部锚点的局限,为训练通用机器人策略提供了新的可扩展范式。
行业影响
落地场景
RynnValue 作为通用机器人操控价值基础模型,可直接嵌入工业机器人、物流仓储、移动操作、家用服务机器人等产品的决策与评估链路。其核心能力——从异构机器人数据中学习时序距离,无需偏好标注即可输出任务进度与失败信号——尤其适合需要快速适配新任务、新机型的柔性产线、无人仓库分拣、多品类物体抓取等场景。
商业价值
- 降本:监督信号完全来自时间戳,省去昂贵的人工偏好/进度标注,数据制备成本大幅降低;模型可零样本泛化到新任务与新视角,减少逐场景重新训练的投入。
- 增效:将价值预测转化为基于势能的密集奖励后,在线任务成功率提升 20%(52.5%→72.5%),离线提升约 19%(63.8%→82.5%),显著缩短策略迭代周期,提升机器人产出效率与任务可靠性。
- 体验提升:通用奖励模型增强了策略对失败和状态退化的敏感度,使机器人在动态环境中表现更稳健,减少人工干预需求。
与现有产品/工作流的接口
- 即插即用的奖励接口:
Temporal-distance potential可直接作为 RL 算法(如 IQL、SAC)的奖励函数,或为已有策略提供辅助价值信号,无需修改网络架构。 - 多模态 VLM 集成:RynnValue 天然支持语言指令与视觉输入,可与现有**视觉-语言-动作(VLA)**模型(如 RT-2)组合,在推理时增强其价值判断,或作为离线数据过滤/重标记工具。
- 开源生态补充:模型权重与代码开放,可通过 HuggingFace 或自有部署服务接入,与现有的 ROS、Isaac Sim 等机器人中间件及仿真环境无缝配合。
具体落地 use case:
- 电商仓储自动化:在 Amazon Robotics 类似的案例中,移动操作机器人需要频繁处理新上架的商品类型。利用 RynnValue 作为通用价值模型,可快速评估拣选、放置动作的潜在价值,无需为每种 SKU 重新录制大量演示或标注偏好,实现新品类上线即用的自适应操作。
- 自动驾驶车队远程操控:自动驾驶远程接管中心需要评估人工操作员接管前后车辆状态的“距离”,以优化调度与培训。将 RynnValue 适配到驾驶场景,可从时间戳自动生成价值标签,构建操作质量评分模型,辅助安全员培训与实时监控,降低事故风险。
局限
- **依赖时间戳精确对齐的演示数据**:RynnValue 的训练标签从视频帧的时间戳推导,这要求数据集中每条轨迹有连续、无缺失的时间戳,并且任务进度与时间流逝呈单调关系。对于大量未精确标注时间戳的机器人操作数据(如遥操作或人类视频),需要额外的对齐和插值处理,可能引入噪声。此外,时间距离仅在任务单调推进时有效,如果任务中存在反复或倒退(如探索性动作、错误恢复),时间戳与真实进度不一致,会导致价值预测偏差。
- **时间距离对复杂长周期任务的局限性**:虽然时间距离在短周期操作任务中表现良好,但在需要多步推理、分层决策或非均匀进展的任务中(如装配、需暂停等待环境反馈的交互),时间距离可能无法捕捉关键子目标的价值变化。例如,一段静止等待的时间段会给出持续下降的时间距离,但实际任务进度可能停滞,导致价值估计误导策略学习。论文在 case study 中展示了时间价值曲线的合理性,但未深入讨论此类边缘情况。
- **跨实体和场景的泛化仍有待验证**:尽管 RynnValue 在零样本跨任务、跨视角、跨机械臂的测试中表现优异,实验对象仍主要限于桌面操作环境,未见在移动操作、导航或人机交互等动态场景中的评估。此外,模型对背景、光照、相机参数等视觉分布偏移的鲁棒性未充分探索。将时间距离作为通用奖励接口,在更大规模的异构数据上是否仍能保持稳定的价值排序,需要进一步实证。