Evo-Bench: 语言模型能否改进智能体框架?
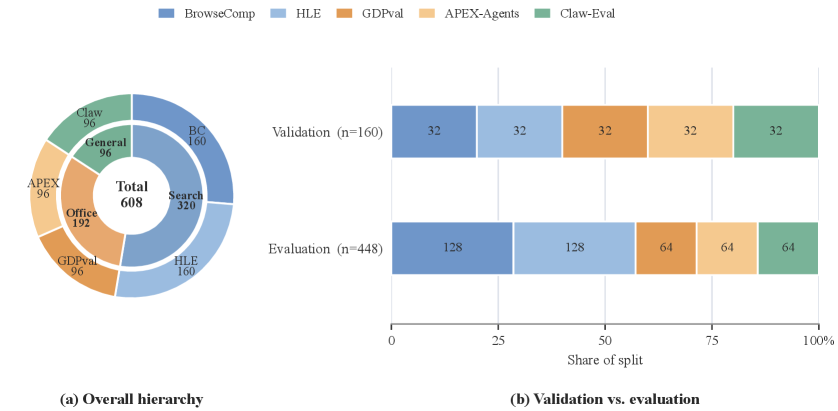
大语言模型(LLMs) 推动了自主智能体的快速发展,但现有评估仍局限于静态任务求解。一个新兴的前沿方向是 框架演化(harness evolution)——智能体自主优化其运行框架的能力。然而,系统化地基准测试这一能力仍具挑战,现有评估无法将框架改进与基础模型强度分离,难以防止任务特定过拟合,或覆盖长程迭代研究。 为解决这些问题,我们提出 Evo-Bench,首个专门评估模型在 搜索(Search)、办公(Office) 和 通用代理(General agent) 领域内在框架演化能力的基准。为严格隔离该能力,Evo-Bench 采用新颖的 框架引导式构建框架(harness-guided construction framework):利用 辅助任务演化 识别对框架改进真正敏感的任务,随后通过 敏感性感知分层划分(sensitivity-aware stratified splitting) 确保跨套件的稳健泛化。 对九个前沿及开放权重模型的广泛评估显示,顶尖模型取得了高达 16.6 分 的绝对提升,接近最先进的人工设计基线。关键的是,虽然自主演化在通用任务中优于人工框架并在搜索任务中表现出色,但在需要高度特定处理流程的办公任务中表现不佳。 进一步的分析揭示了诸如 早期饱和(early saturation) 等关键时间异常,同时表明合成框架可作为 高迁移性的推理结构,持续增强多样化的策略模型。
论文精读
TL;DR Evo-Bench 是首个评估大模型自主优化智能体工作框架的基准,通过敏感度感知任务构建隔离框架进化能力,揭示顶尖模型可逼近人工设计基线,但在办公等需特定流程的任务中仍存不足。
问题
问题背景
当前 LLM-based autonomous agents 的研究重心正从完成单次静态任务转向 自主能力进化(self-improvement)。其中,“harness evolution”(框架进化)指模型不依赖人类干预,自动优化自身运行脚手架(如工具调用框架、记忆结构、推理流程),这是通往更高阶 Agent 自治的关键一步。
现有方法的局限
现有评测范式存在三个核心缺陷:
- 无法隔离框架优化能力与基座模型能力:评测信号混杂,难以判断性能提升究竟来自更好的 harness 还是更强的 base model。
- 缺乏任务敏感性筛选:随机选取的任务集可能对 harness 改进不敏感,导致大量实验投入在“伪提升”或“天花板效应”上,且易引发 task-specific overfitting。
- 未覆盖长周期迭代优化过程:多数基准仅评估最终效果,忽略了进化过程的动态特征(如早期饱和、退化)和跨任务泛化性。这导致无法区分真正的框架进化与一次性的 prompt 工程技巧。
技术挑战与重要性
构建可信的 harness evolution 基准面临双重挑战:
- 挑战一:甄别敏感任务。需设计一种机制,从海量潜在任务中找出那些真正受益于 harness 改进的任务,而非仅仅依赖基座模型记忆的任务。
- 挑战二:保证跨套件泛化。如果评测任务与进化任务同分布,则过分乐观的指标会掩盖过拟合;必须通过分层划分(如 sensitivity-aware stratified splitting)迫使模型在未见过的任务套件上证明框架的迁移性。 业界对“模型自我改进基础设施”的需求急剧上升,因为人工维护 agent 框架成本高昂,且面对动态环境时难以实时更新。可靠的 harness evolution 能力有望让 Agent 在部署后持续自我适配,大幅降低工程开销。
行业类比
类比 AutoML 中的神经架构搜索(NAS),但对象由模型结构变为 Agent 工作流框架:让模型自行搜索更优的推理结构与工具编排,而非由人类专家反复调参。
核心洞察
- **Evo-Bench 通过 harness-guided 任务构建实现了能力隔离**:以往基准难以区分智能体性能提升是源于基座模型能力还是框架优化,Evo-Bench 引入辅助任务演化(auxiliary-task evolution)来识别对框架真正敏感的任务,并结合敏感性感知的分层划分(sensitivity-aware stratified splitting)确保跨套件泛化,从而严格评估模型的自主 harness 演化能力。这为未来智能体基准设计提供了避免混淆因素的范式。
- **自主演化在结构化办公任务中存在显著局限性**:实验表明,尽管前沿模型在搜索和通用领域通过自主演化的 harness 能逼近甚至超越人工设计的基准,但在 Office 任务中表现挣扎,因为这些任务高度依赖特定的处理工作流。这揭示了自动化框架优化的一个重要工程问题:对于流程固化、规则密集的场景,脱离人类经验的纯粹端到端演化可能不如手工精心设计的 harness,启示我们在实际部署中需根据任务特性混合使用自动化与人工知识。
方法
输入
Evo-Bench 的输入包含一组原始 Agent 任务套件(覆盖 Search、Office、General 三类场景)和一组辅助任务(auxiliary tasks)。这些任务通常以完整的执行流程定义,包括环境交互、工具调用和最终性能指标。
关键模块:Harness-Guided Construction 框架
阶段一:辅助任务上的 Harness 演化(Auxiliary Harness Generation)
- 首先在辅助任务上运行多个 Harness 演化轮次,让待评估的 LLM 尝试自主改进其操作框架(harness),例如调整推理策略、规划流程或工具调度。
- 通过对比不同演化步骤下的性能变化,识别出对框架改进真正敏感的任务(即 harness-sensitive tasks)。这类任务的成功率会随 harness 质量显著波动,而非仅由模型基础能力决定。
阶段二:敏感性感知的分层任务选择(Sensitivity-Aware Stratified Splitting)
- 将原始任务划分为高敏感组和低敏感组,再从每组采样组成训练集和测试集,确保:
- 训练与测试分布一致,避免跨套件性能偏差;
- 测试任务未被演化过程直接见过,防止过拟合;
- 任务难度与敏感性平衡,使基准能可靠衡量 intrinsic harness-evolving capability。
- 最终构建的 Evo-Bench 基准定义为:
“给定一个初始 harness,模型需要在多轮迭代中自主优化该 harness,并在未见过的任务上评估提升幅度。”
输出
基准为每个模型输出演化收益(evolution gain),即从初始 harness 到自主演化后 harness 的绝对性能提升(例如最高达 16.6 分),并与人类工程师设计的 SOTA harness 对比。同时,演化轨迹记录(trajectories)用于分析长周期迭代趋势(如早熟收敛)和所合成 harness 的可迁移性。
与同类方法的差异
不同于依赖静态测试集的 Agent 评测,Evo-Bench 通过任务敏感性分层与跨套件泛化设计,首次将评估焦点从“解决任务”转向“改进框架本身”,从而剥离基础模型强度干扰,精确量化 LLM 的自主 meta-optimization 能力。
实验
实验设计
Evo-Bench 在 Search、Office、General 三大代理领域上评估了 9 个前沿及开放权重模型。每个模型执行自主 harness 演化:通过迭代优化其运行框架(提示词、工具编排等),再使用固定策略模型测试性能提升。任务构建采用 harness-guided construction 流程:先利用辅助任务演化识别对框架改进真正敏感的任务,再通过 sensitivity-aware stratified splitting 划分训练/测试集,确保跨套件泛化。
关键发现
- 顶级模型实现 +16.6 绝对收益,接近 SOTA 人类工程基线。
- 自主演化在 General 任务中超越人工框架,Search 任务表现优异,但在需要高度定制工作流的 Office 任务中受挫。
- 演化轨迹分析揭示 过早饱和 等时序异常,但生成的 harness 可作为 高度可迁移的推理结构,一致提升不同策略模型。
基线对比解读
与静态任务求解和人工设计 harness 相比,Evo-Bench 严格隔离了 框架改进 与 基础模型能力,避免任务特定过拟合。尽管模型显著自我提升,与人类专家基线仍有差距,尤其在需领域深层知识的 Office 场景,暴露了当前 LLM 在 长期迭代研究 上的短板。这暗示未来需强化模型对复杂工作流的建模与探索策略。
行业影响
落地场景
Evo-Bench 所评估的 harness evolution 能力,直接推动 自主 Agent 的持续自我优化,可落地于需要长期运行的复杂任务场景:
- 搜索增强型 Agent:如智能客服、知识库问答系统,自动进化检索策略与信息整合逻辑,适应不断变化的文档库与用户意图。
- 办公自动化 Agent:如邮件处理、报表生成,虽当前 Office 任务尚有挑战,但未来的进化能力可减少人工编排工作流。
- 通用任务 Agent:如代码生成与调试助手,进化推理结构与工具调用策略,提升跨场景的泛化能力。
商业价值
- 降低维护成本:传统 Agent 框架依赖工程师手工调整 prompt 模板、工具组合 与 控制流,而 harness 自主进化可显著减少人工迭代开销,让模型在部署后持续适应新数据分布。
- 提升鲁棒性与稳定性:通过 sensitivity-aware stratified splitting 构造的基准能更好地泛化,避免任务过拟合,最终模型在未见任务上更可靠,减少线上事故风险。
- 快速推向多种业务:同一进化流水线可横向复制到不同领域的 Agent 产品,加速产品矩阵扩张。
与现有产品/工作流的接口
- 对齐现有 Agent 框架:可将进化模块集成到 LangChain、AutoGPT、MetaGPT 等主流框架中,作为周期性执行的 meta-optimizer,对 Agent 的 system prompt、tool schema、planning strategy 等 harness 组件进行变异与选择。
- 与 MLOps 管道结合:利用 评判模型 (Judge Model) 进行自动化评估,生成进化轨迹数据,再通过 RLHF 或 DPO 微调底层策略模型,形成闭环。
- 渐进式上线:先在低风险场景验证进化 harness 的收益,再逐步推广到核心业务,确保安全拦截。
具体落地 Use Case
- 全球电商平台的智能客服 Agent:面对频繁更新的商品目录、促销规则和退货政策,Agent 可通过 harness 进化自动调整其搜索与问答策略,例如改变多轮查询的分解方式或知识库索引偏好,避免人工重写 prompt,始终保持高准确率。
- 跨国金融机构的自动化报告生成 Agent:每日需从多个数据源抽取并整合市场分析报告。通过进化 harness,Agent 可自行探索更高效的 数据提取顺序 和 图表生成参数,在合规框架下大幅缩短报告生成时间,释放分析师资源。
局限
- **办公室任务适应性不足**:论文明确指出,自主框架进化在需要高度特定处理流程的办公任务上表现挣扎,不如人工设计的框架。这表明该方法对结构化、规则密集的领域泛化能力有限,实际部署时可能需人工干预或混合策略。
- **进化过程存在早期饱和与异常**:分析揭示进化轨迹中出现过早收敛和局部最优(如 DeepSeek-V4-Pro 过早停滞),以及模型误判性能衰退为噪声(Qwen3.6-27B)。这限制了长期迭代优化的潜力,提示当前进化算法缺乏有效的探索-利用平衡机制。
- **基准构造可能引入选择性偏差**:Evo-Bench 依赖辅助任务演化筛选对框架改进敏感的任务,尽管采用了分层划分,但这种基于敏感性的构造可能过滤器掉某些任务类型,导致基准覆盖不够全面,且敏感性指标本身可能受特定辅助任务集影响,无法完全模拟真实代理系统的异质性。