Sci-VBench:评估科学领域中知识与推理密集型视频生成
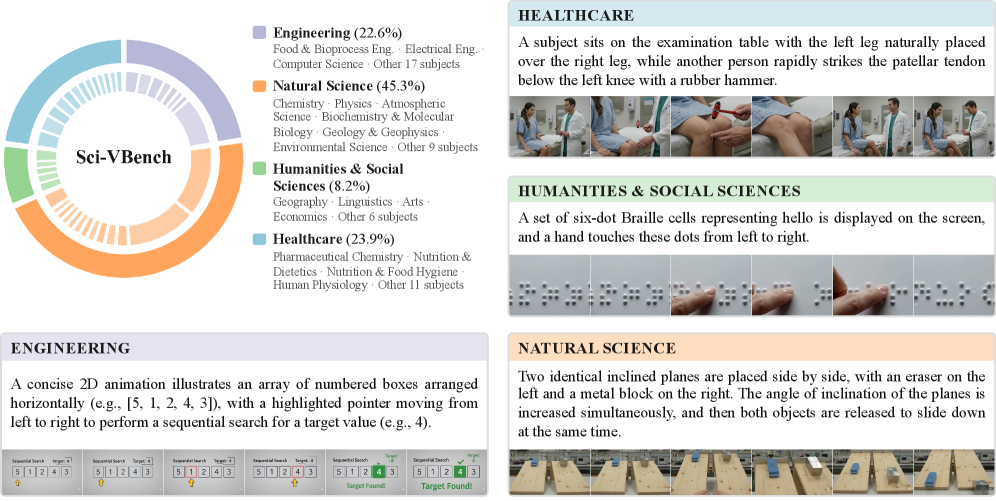
我们推出了 Sci-VBench,一个用于评估科学领域中知识与推理密集型视频生成的综合基准。该基准包含 1,253 个专家标注的示例,涵盖 四大核心学科(自然科学、医疗健康、人文与社会科学、工程学)下的 60 个主题。每个示例要求模型生成时间上丰富的视频,这些视频需要科学推理和基于知识的综合能力,而不仅仅是表面上的视觉合理性。 我们进一步建立了一套基于评分标准的评估协议。分析表明,在该协议下,非专家人类评估者和 MLLM-as-Judge 系统都能与专家判断达到较高的一致性,从而支持大规模的可复现评估。 我们对 16 个前沿专有和开源模型进行了基准测试,结果发现:虽然自动感知质量得分在不同系统间紧密聚集,但在 提示语义还原 和 科学及因果正确性 上的表现差异显著,并且专有模型与开源模型之间存在明显差距。这些发现表明,视觉真实性的进步尚未转化为对科学和因果动态的可靠建模。
论文精读
TL;DR Sci-VBench 构建了首个跨学科的科学推理视频生成基准,揭示前沿模型虽视觉逼真但缺乏因果与科学正确性,并暴露出专有与开源模型的显著差距。
问题
问题背景
视频生成模型已能产出高视觉保真度的内容,但评估仍主要聚焦于低层感知质量(如 VBench 中的时序闪烁、运动平滑度等),难以衡量生成视频在科学推理、因果逻辑和领域知识一致性上的表现。
现有方法局限
现有基准的指标设计普遍存在两类缺陷:
- 维度单一:仅覆盖视觉质量,缺乏对提示词落地(Prompt Grounding)、科学正确性与因果合理性的细粒度评分,导致模型只要“看起来真实”即可获得高分。
- 评估协议可复现性差:人工评估常依赖直觉判断,缺乏标准化的评分量规(rubric),专家与非专家、自动化评估间的一致性难以保证。
为什么这个问题难且重要
科学视频生成要求模型同时处理静态领域知识(如化学反应细节)和动态因果推演(如物理过程的时间演化),两者耦合使生成任务复杂度远超普通场景。此外,视觉真实感的提升容易误导评估——模型可能生成符合常识但实际违背科学原理的画面(如“伪科学”细节),这对医疗教学、工程仿真等高风险场景构成潜在危害。业界对可解释、可信赖的生成式 AI 需求日益迫切,因此构建兼顾感知质量与深层语义正确性的评估体系尤为关键。
行业类比
如同自动驾驶评测不能只检测图像清晰度,而必须验证场景理解与物理推演能力一样,科学视频生成也需从“画得像”迈向“画得对”。
核心洞察
- 视觉感知质量的趋同掩盖了科学推理能力的巨大差距:主流模型在低层保真度指标上得分高度集中,但在 Prompt Grounding 与 Scientific and Causal Correctness 维度上表现分化,且闭源模型显著优于开源模型。这揭示出视频生成领域的进步主要来自视觉逼真度的提升,但并未同步解决对科学动态、因果逻辑的准确建模,提示评估体系需从“看起来真实”向“在物理与因果层面正确”转型。
- 基于 rubric 的评估协议使非专家与 MLLM 判官达成与专家高度一致的评价,为大规模、可复现的复杂视频评估提供了方法论基础。此框架通过分层评分量规和规范化的评估指南,大幅降低了对评估者领域知识的要求,同时保持了评价结果与专家判断的强相关性,克服了以往基准依赖主观整体评分或简单自动指标无法反映科学推理质量的局限性。
方法
Sci-VBench 的构建与评估方法以“输入→关键模块→输出”为线索,聚焦于科学知识驱动与推理密集型视频生成的系统化评测。
输入与评估维度定义
输入的是一套覆盖四大科学领域(Natural Science, Healthcare, Humanities & Social Sciences, Engineering)的视频生成任务,要求模型输出需具备Prompt Grounding、Scientific and Causal Correctness 以及 Perceptual Quality 等维度的综合性能。
关键模块
基准构建流水线
- 科目与样本选择:从 60 个具体科目中精心筛选出 1,253 个示例,每个示例都设计为需要深度科学推理与知识融合,远超表面视觉合理性的常规基准。
- 专家标注流程:领域专家经过招募与培训后,完成两项关键任务:
- 视频提示词标注:撰写富含科学逻辑且要求时序一致性的文本提示。
- 评估规范策展:为每个示例编制高层参考指南及细粒度评估 rubrics,明确各维度的评分标准,这是实现可复现评估的基石。
- 数据质量控制:通过多轮检查与反馈迭代确保标注的准确性与难度分层。
评估协议设计
- 人类评估:以专家评分为金标准,分析非专家评估者在有无评估规范辅助下的表现,验证 rubric 可以有效提升非专家与专家判断的一致性。
- 自动化评估:
- 低层感知保真度:沿用并适配 VBench 中的自动指标,对视频的失真、噪声等底层属性进行量化。
- 高层语义与因果评估:采用 MLLM-as-Judge 框架,将多模态大模型作为评判者,依据 rubrics 对 Prompt Grounding 和 Scientific & Causal Correctness 进行评分,并与专家判断校准,验证其在规模评估中的可靠性。
输出与应用
基准测试最终输出模型在三大维度上的性能剖面,揭示出视觉逼真度指标(Perceptual Quality)在各系统间差异不大,但科学正确性与因果推理维度则存在显著的专有-开源模型鸿沟。
与 VBench 等现有视频评估工作的差异:Sci-VBench 不再止步于通用视觉质量或简单动作一致性,而是首次系统性地将科学知识正确性与时序因果推理确立为核心评测维度,并通过可扩展的 rubric 评估协议实现了高一致性的人类与自动化对齐。
实验
实验设计
Sci-VBench 基准包含 1,253 个专家标注样例,覆盖自然科学、医疗保健、人文社科和工程四大领域的 60 个科目。评估维度涵盖 感知质量、Prompt Grounding 以及 科学和因果正确性。作者制定了基于量规的评分规范,并分别采集了专家、非专家人类评估员以及 MLLM-as-Judge 系统的评分,以验证评估协议的可重复性。最终对 16 个前沿闭源与开源视频生成模型进行评测。
关键发现
在感知质量上,各模型得分高度聚集,差异微小;但在 Prompt Grounding 和 科学因果正确性 上,模型间性能差距显著。闭源模型整体优于开源模型,两者之间存在明显性能鸿沟。这一结果表明,当前视频生成模型的视觉逼真度提升,尚未有效转化为对科学动态与因果逻辑的可靠建模能力。
与基线的深度对比
与传统视频生成评测基准(如 VBench)相比,Sci-VBench 首次将评价重心从低层次视觉质量移至知识密集型推理维度,揭示了单纯追求 FID 或 IS 等感知指标的局限性。该基准证实,即便最先进的生成模型在需要准确科学知识表达的场景中仍会失败,凸显了未来模型需融合领域知识、强化时序因果推理的工程方向。同时,规则化评分协议与自动化评委的较高一致性,为大规模、低成本的科学视频生成评测提供了可行路径。
行业影响
落地场景
Sci-VBench 直接面向科学可视化与教育内容生成。典型产品包括:
- 科普视频自动生成:平台(如 YouTube、Khan Academy)利用视频生成模型将教科书文字转化为动态演示,需确保化学反应、物理运动等的因果逻辑正确。
- 医疗培训与手术模拟:生成符合解剖学与操作规范的视频,错误运动可能导致培训误导。
- 工程仿真预览:辅助设计师快速生成物理过程的视觉草案,要求模型理解力学、流体等约束。
- 内容审核与事实校验:对于 UGC 平台,可借此评估自动化工具检测科学类视频中的因果性错误的能力。
商业价值
- 降低专业内容生产成本:传统科学动画制作依赖领域专家与动效师协作,成本高、周期长。通过 Sci-VBench 筛选出科学正确性达标的生成模型,可大幅减少人工修正与重拍。
- 提升用户信任与产品溢价:在教育科技、医疗模拟等场景,内容准确性直接影响产品合规性与付费意愿。一个通过严格基准的模型能成为差异化卖点,支撑更高的订阅或授权价格。
- 加速模型迭代:自动化评估(MLLM-as-Judge)可集成至模型训练的奖励模型或 RLHF 流程,持续优化因果一致性和知识对齐,使模型更快达到商用门槛。
与现有产品/工作流的接口
- 评估 pipeline 集成:可与视频生成平台(如 Runway、Pika)的评测套件结合,在模型上线或版本更新时自动运行 Sci-VBench,输出Prompt Grounding 和Scientific & Causal Correctness 分数,作为质检门禁。
- 数据飞轮:将 Benchmark 中的专家标注示例用于微调生成模型或多模态评审器,形成领域特定能力的持续增强。
- 工具链插件:为内容创作工具(如 Adobe Premiere Pro 的 AI 插件)提供实时科学性校验,在导出前扫描视频片段的动作、关系是否符合预设学科规则。
具体落地 use case
- 教育科技公司(如 Khan Academy)采用文本生成视频模型制作教学素材。部署前使用 Sci-VBench 筛选模型:选择一个在“化学反应”类提示上因果正确性得分最高的版本,避免产生“试管未加试剂却变色”这类逻辑错误,从而保证教学严谨性,减少用户投诉。
- 医疗模拟系统供应商(如 Osso VR)需要大量手术操作演示视频。将 Sci-VBench 中的 Healthcare 子集嵌入模型评估流程,确保生成视频中的器械操作顺序、解剖结构符合临床指南。这不仅提升培训效果,也有助于满足医疗设备软件的法规要求(如 FDA 的 SaMD 指南)。
核心启示:视觉真实感已趋同,但科学领域的视频生成竞争焦点正转向因果正确性与知识对齐。Sci-VBench 为这一转型提供了可复现的大量化标尺,工业界可借此建立面向垂直领域的可信生成标准。
局限
- Sci-VBench 目前仅涵盖自然科学、医疗、人文社科与工程四个核心学科,60个科目虽广但科学领域众多,无法覆盖所有知识密集型视频生成场景(如法律、军事等特殊学科),样本量1253可能限制复杂推理多样性的全面表示。基准构建依赖专家手工标注与审核,成本高、周期长,难以快速扩展到新学科或应对领域知识的快速迭代。评估协议采用 MLLM-as-Judge,虽与专家一致性较高,但 MLLM 在长链科学推理、细微因果错误上仍可能出现偏差,且其判断可能受训练数据偏见影响,对某些特定错误的敏感度不足,进而影响评估结论的稳健性。
- 该基准仅评估文本到视频的生成能力,未考虑多模态输入(如文字结合示意图、公式或实验装置图),而这在实际科学教育或传播中更为常见。评估维度聚焦于提示接地与科学因果正确性,但未深入分析视频的时间连贯性、物理规律长效一致性(如化学反应步骤间的时间依赖),这些对科学视频的可信度至关重要。此外,基准发表于2026年,仅评测了当时的16个前沿模型,由于视频生成技术迭代极快,其结论的时效性存疑,未来需要持续更新模型列表和评测数据。
- 相比 VBench、EvalCrafter 等通用视频评估基准,Sci-VBench 首次将科学推理纳入评估,但缺乏对生成错误来源的逐步诊断能力,无法区分知识缺失、逻辑推理错误或视觉幻觉等具体失败模式。评估协议并未引入外部科学知识库进行事实核验,可能局限于标注者自身知识边界。同时,实验发现不同模型在感知质量指标上差异细微,而在科学正确性上差距明显,从侧面说明现有自动质量指标无法有效反映科学内容质量,但基准并未针对这一缺陷提出面向科学视频的新感知指标,限制了评估的深度和可操作性。