Addressable Memory for Video World Models
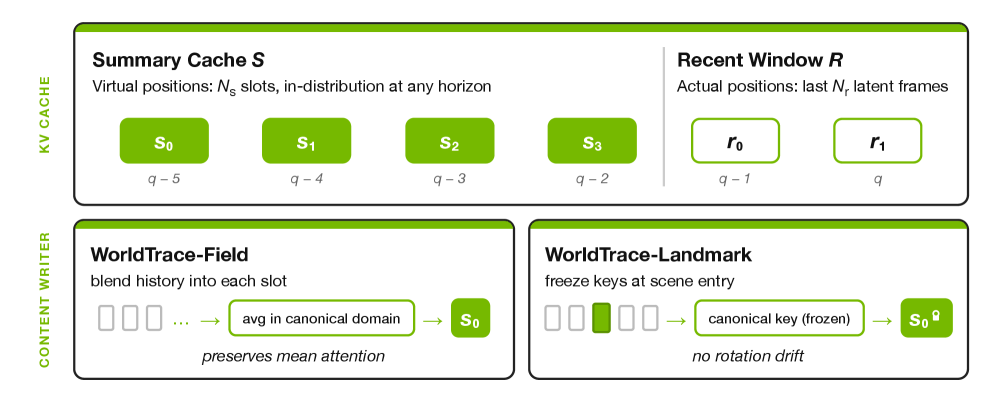
交互式视频世界模型依赖 Key-Value (KV) 缓存作为不断增长的视觉记忆,以携带先前生成的帧。然而,研究发现一旦推出时间超出训练范围,模型便无法可靠地寻址存储的内容,因为时间旋转位置嵌入 (RoPE) 的偏移落在训练期间见过的范围之外,模型通过注意力检索相关信息变得困难。此外,在 RoPE 旋转空间中简单压缩缓存会混淆不兼容的位置阶段,从而损坏记忆。 为解决这一问题,我们提出 WorldTrace,一个无需训练的记忆框架,用于长视野视觉持久性。WorldTrace 为每个摘要槽分配独特的、分布内的虚拟位置,使压缩记忆保持可寻址。在此框架下,我们研究了两种记忆压缩方法:WorldTrace-Field 压缩历史以实现时间一致性,WorldTrace-Landmark 在检测到的场景转换处存储逐字场景痕迹,以支持情节回忆。 我们进一步引入 LoopBench 基准,用于评估压缩缓存能否在长绕行后重建先前访问过的场景。实验结果表明,WorldTrace-Field 在 LoopBench 上将时间一致性提升 15.5%,WorldTrace-Landmark 将情节回忆提升 19.5%,无需重新训练即可扩展视觉持久生成的性能。
论文精读
TL;DR **WorldTrace** 为视频世界模型构建可寻址压缩记忆,用虚拟位置解决长时 RoPE 偏移导致的历史帧寻址失败,无需重训练即可大幅提升时间连贯性与情景回忆。
问题
问题背景
交互式视频世界模型(如游戏环境模拟、具身智能仿真)依赖键值(KV)缓存作为“视觉记忆”,在生成长序列时持续回溯历史帧。然而,现有模型普遍使用旋转位置嵌入(RoPE),这导致记忆访问面临根本性限制。
现有方法局限
- 位置不可寻址:RoPE 的时序偏移在 rollout 超出训练长度后,会落入训练分布外。模型注意力无法正确检索到对应的历史帧,即使缓存中保存了完整信息。
- 压缩破坏记忆:为降低显存,直接对 RoPE 旋转后的缓存做池化(如平均),会混合不同相位的键,产生无意义的表征,严重损害视觉保真度。
这两个问题相互耦合:前者源于位置编码的有限泛化,后者源于在旋转空间压缩时忽略了相位连续性。
技术挑战与重要性
长程视觉持久性是交互式环境的核心能力(例如,在迷宫中长时间探索后仍需回忆起点场景)。挑战在于:视频世界模型是自回归生成,必须用有限尺寸的缓存代表无限增长的观察历史;而训练时见过的序列长度有限,难以覆盖真实交互中的远距离回访。工业界对此高度关注,因为无论是世界模型驱动的自动驾驶仿真,还是具身智能的长期规划,都要求记忆模块既能跨时间寻址,又能有效压缩。
行业类比
类似自动驾驶车辆需要记住数分钟前路过的临时施工标志,但位置编码失效会导致该标志在记忆中“漂移”,最终无法正确回归。
核心洞察
- **位置可寻址性是长视频生成中记忆检索的瓶颈**:随着 rollout 延长,RoPE 的位置偏移超出训练分布,导致模型无法通过 attention 定位已存储的视觉信息。WorldTrace 通过为每个压缩槽分配在分布内的虚拟位置,保持了记忆的地址有效性,从位置编码的角度而非模型容量或压缩算法重新定义了长时记忆问题。
- **内容压缩必须与位置表示解耦**:直接在 RoPE 旋转空间内对 KV 做平均会因相位不兼容而破坏记忆。WorldTrace-Field 在规范键空间进行平均后再加位置编码,WorldTrace-Landmark 则冻结场景切换时的原始键值以保留精确记忆,二者分别实现了时序一致性和情节回忆的大幅提升(+15.5% 和 +19.5%),表明解耦策略是解决“压缩即遗忘”的有效路径。
- **LoopBench 暴露了长周期回忆的评估真空**:现有基准缺少针对长距离绕行后场景重建能力的测试。LoopBench 模拟了“离开-返回”的循环路径,度量压缩缓存是否能恢复之前访问过的场景,从而推动世界模型记忆评估从短时一致性转向持久性,为记忆压缩方法的比较提供了统一标尺。
方法
输入:交互式视频世界模型在自回归生成过程中,将先前帧的视觉表征缓存在日益增长的 KV 缓存中,并通过时间 RoPE 编码位置。当 rollout 长度超出训练范围时,RoPE 偏移落入分布外,模型无法通过注意力可靠地检索记忆内容;直接压缩缓存又因旋转相位不兼容而破坏记忆可寻址性。
关键模块:
- 可寻址压缩记忆:WorldTrace 引入固定数量的摘要槽位,每个槽位被分配一个位于训练分布内的虚拟位置,使压缩后的记忆条目仍能被注意力机制像普通 token 一样查询。
- 记忆压缩作为结构化稀疏注意力:将全注意力近似为低秩或分组结构,通过构造投影矩阵 $P$ 将长序列映射到固定槽位,避免直接操作 RoPE 空间。
- WorldTrace-Field:采用规范键平均,对一段历史窗口内的键进行均值投影,生成时间连贯的摘要,用于保持场景一致性。
- WorldTrace-Landmark:检测场景转换点,将关键帧的键值对冻结为地标,保存原始视觉信号,实现情节回忆。冻结键同样获得虚拟位置,保证可寻址。
- 位置-内容解耦:压缩在原键空间完成,再与虚拟位置相加,避免压缩与位置编码的相互干扰。
输出:在长程生成中,模型能持续产生视觉一致的画面,并在重访先前场景时准确再现细节。在 LoopBench(环路记忆测试)上,WorldTrace-Field 将时间一致性提升 +15.5%,WorldTrace-Landmark 将情节回忆提升 +19.5%。
差异点:与滑动窗口或注意力汇聚等现有 KV 缓存压缩方法不同,WorldTrace 通过为压缩槽位赋予可寻址虚拟位置,首次解耦了记忆压缩与位置编码,并区分为连贯性压缩和地标式压缩,无需重新训练即可扩展视觉持久性生成。
实验
实验设计
论文提出 LoopBench 基准,专门评估视频世界模型在长距离绕路后能否准确还原之前访问过的场景。实验沿用主流视频世界模型架构,将标准 KV 缓存扩展至超长序列,对比多种无训练缓存压缩方案,包括朴素压缩、RoPE 外推变体以及本文的 WorldTrace-Field 与 WorldTrace-Landmark。
关键发现
- WorldTrace-Field 通过可及记忆的时间一致性压缩,在 LoopBench 上将时间一致性提升 +15.5%,表明为摘要槽位分配分布内虚拟位置能有效保持序列连贯。
- WorldTrace-Landmark 在检测到的场景切换点存储精确场景痕迹,使情景回忆能力提升 +19.5%,验证了关键帧冻结对长程记忆恢复的重要性。
- 消融实验证实,位置可及性与内容压缩二者耦合:仅改进压缩而不分配虚拟位置,性能仍会因 RoPE 偏移超出训练分布而退化。
与基线对比的深度解读
朴素压缩直接在 RoPE 旋转空间中平均 KV 向量,导致位置相位不兼容,记忆快速损坏。本文方法将记忆重新索引为分布内虚拟位置,从而使注意力检索有效运作。相比其他位置外插或滑动窗口近似,WorldTrace 在可及性与信息量之间取得平衡:Field 模式保证时序平滑,Landmark 模式保留关键离散事件。两种模式均无需微调,仅通过结构化稀疏注意力逼近全注意力,为部署长时视频生成提供了一种即插即用的记忆方案。
行业影响
落地场景
WorldTrace 为交互式视频世界模型提供了一种训练无关的长时记忆强化方案,核心落地场景包括:
- 视频生成与流媒体创作:在 AI 驱动的虚拟世界、游戏剧情生成、数字孪生中,需要跨长时间窗口保持场景一致性(如角色重返过去的地点,房间布局、物体位置不变)。
- 仿真与数字孪生:自动驾驶仿真、机器人导航模拟中,环境必须随时间演化并保持记忆,例如车辆驶过一段路再返回时,路口标志、障碍物仍需正确再现。
- 沉浸式交互内容:VR/AR 环境中的连续叙事体验,用户探索后返回,场景内容不能丢失;教育场景中的持续演示视频,逻辑连贯性要求高。
商业价值
- 提质降本:避免对视频世界模型进行昂贵的二次训练,以即插即用的推理时修改大幅延长生成画面的时间连贯性,直接降低长内容创作的计算与人工修正成本。
- 体验升级驱动增长:在短视频、互动影视、虚拟偶像等消费场景,视角往返时的视觉重现一致性直接提升沉浸感,增强用户留存与内容变现能力。
- 开辟新应用边界:使基于 world model 的虚拟场景生成可用于对持久性要求苛刻的专业仿真,拓展了产品商业化的技术基础。
与现有工作流的集成
- 模型层接口:可直接嵌入基于 Transformer 的视频世界模型推理管线(如 GameNGen、DIAMOND),修改 KV 缓存更新策略,不改变模型权重,易于被现有生成服务采用。
- 平台层集成:视频生成平台(如 Runway、Sora 类服务)可将 WorldTrace 作为长视频生成的扩展选项,在输入提示词中加入“返回某个地点”时自动启用,提供更连贯的生成结果。
- 工具链兼容:由于是训练无关的方法,开发者可以在推理脚本中直接加入虚拟位置分配与缓存压缩逻辑,与现有量化、蒸馏等优化并行。
具体落地 Use Case
- 电商虚拟场景展示:为商品生成连续环绕视频,当镜头在旋转一圈后又回到正面,模型必须“记住”之前已经展示过的细节,确保商品外观一致,不出现变形或细节丢失。
- 自动驾驶仿真闭环测试:利用 WorldTrace-Landmark,在模拟器中,自车多次绕行同一街区,每次返回到路口时,交通灯、行人、临时障碍物的状态应能准确复现,从而提高规划算法测试的可信度。
局限
- **WorldTrace-Landmark** 依赖场景转换检测来存储关键帧,这一步骤目前由预训练的检测器或启发式规则完成,其检测质量会直接影响记忆存储的完整性和召回精度;而在长视频中,场景转换的误检或漏检可能导致记忆碎片化或关键信息丢失。**WorldTrace-Field** 通过平均池化压缩历史,虽能保持时序连贯,但会模糊细粒度视觉细节,在需要再现纹理或细小物体的任务中存在性能瓶颈。
- 方法采用固定的**虚拟位置分配策略**(如均匀间隔的槽位),假设记忆重要性随时间均匀分布。这在实际动态场景中并不成立,使得重要事件可能被分配到远离查询的位置,从而降低注意力检索效率。此外,当前框架未适配自适应内存预算,限制了在超长演进中的可扩展性。
- 与基于微调的长期记忆方法(如通过重访监督训练的记忆策略)相比,**WorldTrace** 作为无训练方案,虽然消除了微调成本,但其压缩率与重建质量的权衡无法通过数据驱动优化,导致在极端压缩比下可能不如学习型压缩方法。**LoopBench** 目前仅评估了单一的回访记忆能力,尚未覆盖需要动态交互、多物体跟踪等更复杂的记忆需求,其泛用性有待扩展。