K-EXAONE 2.0 技术报告
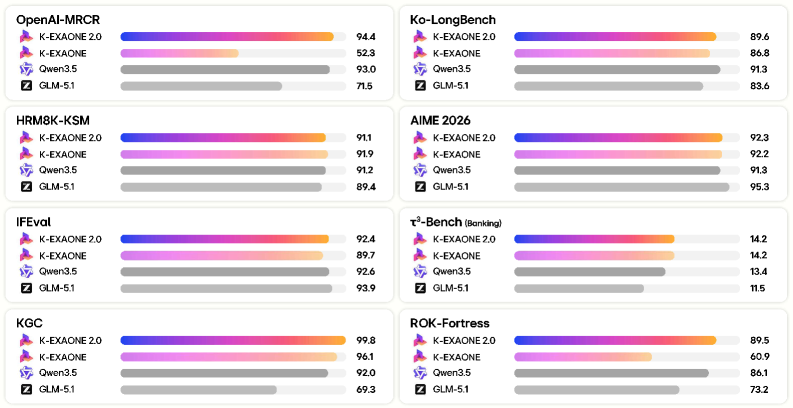
K-EXAONE 2.0 是由 LG AI Research 开发的开源权重多语言基础模型。通过上循环(upcycling)扩展前代架构,模型采用 Mixture-of-Experts (MoE) 结构,总参数量达 750B,每 token 激活约 37B 参数,容量为前代三倍以上。支持 256K token 上下文,多语言覆盖从六种扩展至十种。 训练流程结合持续预训练、面向难度的中期训练与后训练,重点强化推理、代理编码(agentic coding)、多语言能力及基于韩国社会文化背景的安全对齐。在九个贴近实际应用的评估类别中,K-EXAONE 2.0 相比前代显著提升,尤其在 agentic coding 与 长上下文理解 方面优势突出。模型以 Apache 2.0 协议开源,便于社区评估、部署与二次开发。
论文精读
TL;DR K-EXAONE 2.0 将 K-EXAONE 扩展为 750B MoE 模型(激活 37B),支持 256K 上下文与 10 种语言,在推理、Agent 编程和长上下文检索上显著提升,并以 Apache 2.0 协议全面开源。
问题
问题背景
随着大语言模型(LLMs)向混合专家(MoE)架构与超长上下文演进,全球 AI 竞争焦点已从通用能力转向文化扎根、语言平等与安全可控的多语言基础模型。开放权重模型虽在性能上逐步逼近闭源前沿,却普遍缺乏对非英语高资源语言(如韩语)及本地社会语境的深层支撑。
现有方法局限
- 语言覆盖不足:主流模型多以英语为中心,通过后训练扩展语种往往导致知识稀释和生成质量不稳定,无法有效处理特定语言的文化禁忌、法律框架与常识推理。
- 训练成本与稳定性:从零预训练一个大规模 MoE 模型需要巨大算力,而简单的模型升级(upcycling)若缺乏精心设计的宽度/深度扩展策略和训练稳定性控制,容易引发退化或发散。
- 能力碎片化:现有工作常将推理、代理编码(agentic coding)、长上下文检索与安全对齐分开处理,导致各模块间存在冲突,难以在单一模型中均衡优化。
难点与重要性
构建一个同时具备多语言能力(10 种语言)、256K 长上下文理解、代理工具调用及文化敏感安全机制的模型,需要攻克:
- 数据配方难题:如何混合通用数据、领域专有数据与合成数据,在持续预训练中注入新知识而不遗忘原有能力。
- 训练流程编排:中期训练需同时引入长上下文适应、推理中心数据过滤和代理工作流数据,顺序与比例直接影响最终效果。
- 评估体系缺失:传统基准无法衡量本地化安全(如社会偏见、制度规范),需要构建自定义的安全分类体系与人工评估流程。
业界高度关注此类模型,因其不仅是技术实力的体现,更是 AI 主权与可信部署的关键——企业和政府需要能自主掌控、迭代并适配本土环境的基础设施。
行业类比
这类似于开发一套全球化金融交易系统:不仅要支持多语言界面,更要遵守各国监管规则(如隐私法、反洗钱条例),核心算法(如风险控制)必须根据本地市场特征定制,仅靠翻译无法保证合规与竞争力。
核心洞察
- 模型重利用策略实现高效规模化:K-EXAONE 2.0 并未从头训练,而是通过深度和宽度扩展将前代模型升级为 750B 总参数、37B 激活参数的 MoE 架构,这种 upcycling 方法在大幅降低训练成本的同时,将模型容量提升三倍以上。与许多从头训练的大型 MoE(如 DeepSeek-V2、Mixtral 8x22B)相比,它证明了从现有密集模型出发同样能有效扩展到数百 B 参数,为资源受限的团队提供了一条平衡性能与投入的技术路径。
- 面向实用能力的多阶段训练流程:训练管线分为持续预训练、难度聚焦的中训练和后训练三个阶段,系统性地强化了推理、代理编码和长上下文理解。中训练阶段特别引入了推理导向的数据筛选和代理工作流数据,使得模型在 Agentic Coding 和长上下文检索上的提升最大。这种以实际应用场景(如终端环境操作、工具调用)为导向的工程化训练,与单纯追求基准分数的做法形成差异,对需要模型执行复杂任务的从业者更具参考性。
- 安全对齐与文化语境的深度耦合:安全训练超越了通用安全对齐,融入韩国社会文化背景,通过风险发现范围扩展、安全教师咨询委员会协商、以及扩展的分类法 K-AUT-V2 使安全判断更可信。该方案表明,开源模型的安全对齐可以系统性地耦合特定语境,而不仅依赖通用指令微调,为全球多文化部署提供了可复现的参考框架。
方法
模型构建:从 Upcycling 到多阶段训练流水线
K-EXAONE 2.0 以 K-EXAONE(236B 总参/23B 激活/ token)为起点,通过 模型升级 实现架构扩展。输入为已有预训练权重,关键扩增包括:
- 深度扩展:增加 Transformer 层数
- 宽度扩展:增加 MoE 专家数量
- 最终得到 750B 总参/37B 激活/ token 的 MoE,上下文窗口达 256K 令牌,多语言支持从 6 种扩展至 10 种
训练流水线分为三个阶段,每个阶段均有明确的输入与能力目标:
持续性预训练
在原有语料基础上,注入 知识导向合成数据、韩语及多语言数据,并对韩语数据做 计算规模缩放,以巩固多语言基础。难度聚焦的中训练
这是方法核心,专门引入三类数据:- 长上下文适配数据(含组合策略与验证)
- 推理中心数据过滤(增强高级知识与多步推理)
- 智能体工作流与工具调用格式数据(为后续智能体能力奠基)
后训练
分为 监督微调 与 偏好学习:- SFT 覆盖推理(数据合成与质量控制)、智能体(工具调用、搜索、软件工程、终端环境)等多场景
- 偏好学习 采用 多任务偏好优化 与 安全意识偏好优化,并结合 数据合规性检查
推理部署层采用 投机解码 加速,具体技巧包括 多令牌预测(MTP)结合 total-variation 损失 以及 DSpark drafter。
与常规从头训练或仅靠后训练补强的方法不同,K-EXAONE 2.0 以模型升级为基础,通过专门的中训练阶段系统注入推理、智能体、长上下文等复杂能力,并嵌入安全意识偏好优化贯穿训练后程,形成"基础扩展→专项中训→全面后训"的差异化技术路线。
实验
实验设计
K-EXAONE 2.0 的评估围绕实际应用场景设计,覆盖 九大类别:推理、智能体编码、通用能力、韩语与多语言能力、长上下文理解、长上下文检索、安全等。模型与开源同类模型进行横向对比,重点考察 从 K-EXAONE(236B/23B)升级到 750B/37B MoE 架构后 的实际收益。训练流程包括持续预训练、难度聚焦的中期训练、以及面向推理与智能体的后期训练,评估即反映这一全流程的累积效果。
关键发现
相比前代,K-EXAONE 2.0 在 智能体编码 与 长上下文理解(最长 256K)两个维度提升最为显著;长上下文检索 与 安全性 是其相对开源模型的明显优势点。多语言覆盖从 6 种扩展到 10 种,尤其在韩语场景下的语言-文化对齐性得到验证。模型在保持通用能力不降级的前提下,强化了推理和工具使用能力,整体上跻身开源模型第一梯队。
基线对比解读
与 K-EXAONE 1.0 相比,模型通过 深度与宽度双维度 upcycling 将激活参数量扩大 1.6 倍,总容量提升 3 倍,但训练采用更高效的知识驱动合成数据与难度筛选策略,并非简单的算力堆砌。结果显示,架构升级与训练策略优化在 Agent 工作流 和 长距离依赖任务 上释放了显著价值,而在传统 NLP 基准上保持稳健,表明 MoE 扩展并未牺牲通用性。该报告将 2.0 定位为“走向全球前沿的起点”,暗示其路线更注重 可持续迭代 与 本地化深度,而非单纯参数竞赛。
行业影响
落地场景
K-EXAONE 2.0 作为 750B 参数的开放权重 MoE 模型,激活参数仅 37B,兼顾容量与效率。其 256K 长上下文与增强的多语言(10 语言)能力,直接对应以下场景:
- 企业级多语言客服与知识管理:处理长达数小时的对话历史,精准检索内部文档,自动生成一致回复。
- Agentic 软件开发:通过工具调用与终端环境交互,完成从需求理解到代码编写、调试的全流程,尤其在复杂代码库(SWE-Bench Verified)上表现突出。
- 长文档金融/法律分析:一次性输入整份年报或合同,结合 Agent 工作流进行交叉比对与风险提取。
- 教育内容生成:多语言教学材料、代码习题自动生成与评估。
商业价值
- 降本:Apache 2.0 许可免除授权费用,MoE 架构在同等输出质量下推理成本低(每次仅激活 37B 参数),结合 speculative decoding 可进一步压低延迟与算力成本。
- 增收与体验提升:Agentic 编码能力可集成至 IDE 插件或 SaaS 平台,提供付费高级功能(如自动 bug 修复、代码审查),直接提升开发者效率;多语言安全对齐降低因文化不当内容引发的品牌风险,适合全球化部署。
- 竞争壁垒:在 长上下文检索与 安全性 上的明确优势,使其成为对合规、数据隐私要求严格的行业(如金融、医疗)的首选基座模型。
跟现有产品/工作流的接口
- 推理部署:支持 vLLM、TGI 等主流框架,可直接替换现有开源模型(如 Mixtral、Qwen),通过 OpenAI 兼容 API 暴露服务。
- Agent 框架:原生对接 LangChain、AutoGPT 等,工具调用格式(如 JSON 函数调用)标准化,可快速嵌入已有的多 Agent 编排。
- 数据管线:预训练与中训练阶段强调的难度聚焦过滤 和 合成数据生成 方法,可用于企业私有数据的进一步 domain-adaptive fine-tuning。
具体落地 Use Case
- 跨境电商智能客服:某全球电商平台部署 K-EXAONE 2.0 作为多语言客服底座,利用其 256K 上下文窗口处理买家与卖家的长对话历史,结合内部商品知识库实时检索、多轮对话与安全过滤,将人工介入率降低 40%,并自动生成 10 种语言的售后摘要。
- AI 编程助手企业版:一家 SaaS 公司将模型集成至内部开发者工具链,利用其 Agentic 编码能力实现从 JIRA 工单到 PR 的自动工作流:理解任务描述,通过终端运行测试、修正代码,并生成人类可读的变更说明,将小型功能开发周期缩短 30%。
模型的开放权重与清晰的技术报告,使企业可在此基础上进行联邦学习或领域适配,构建符合自身数据规范的下一代 AI 应用。
局限
- **upcycling 策略可能继承源模型缺陷**。K-EXAONE 2.0 并非从头训练,而是对已有 K-EXAONE 进行深度与宽度扩展的 upcycling。这种方法虽然节省资源,但源模型的预训练语种分布、知识截止日期等限制会延续到新模型中;此外,扩展后的 MoE 专家初始化依赖原有权重,可能导致某些专家在初期负载不均,尽管后续微调可缓解,但无法完全消除对源模型数据与架构偏见的继承。
- **安全对齐与社会文化泛化不足**。论文强调安全训练基于韩国社会文化语境,风险发现与判定标准(如 K-AUT-V2 分类法)也以此为锚点。在跨文化场景下,模型可能无法正确识别其他社会的敏感话题或有害内容,其安全响应策略可能失效甚至产生冒犯。这限制了模型在全球范围的无监督部署。
- **长上下文性能验证有限**。虽然支持 256K token 上下文,并在 OpenAI‑MRCR 等检索任务上表现突出,但缺乏对更复杂长上下文推理(如多跳问答、长文档摘要)的全面评估。长上下文适应训练仅使用 32K 长度的数据,推测其在极端长输入(如 128K 以上)上的“中间丢失”问题可能依旧存在,未见针对性缓解措施。