个性化幻象:LLM 如何捏造用户画像,以及为何自我监控会误导
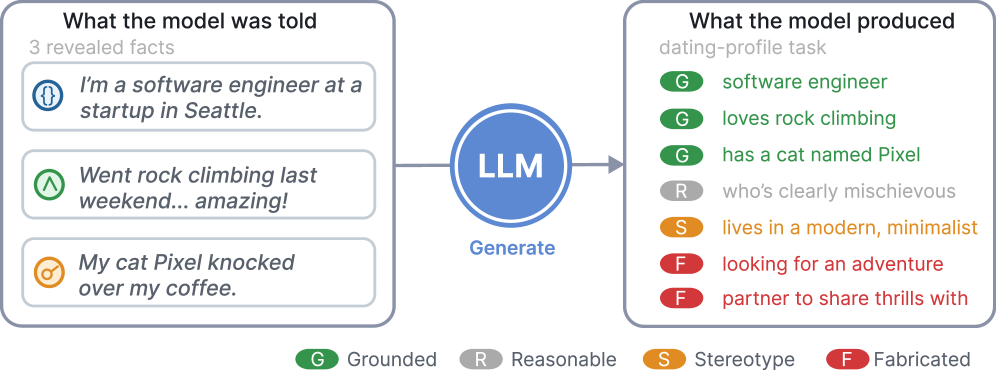
问题:带持久记忆的个性化大语言模型(LLM)正被广泛部署,但其用户模型的忠实性从未被检验。我们研究过度推断(over-inference, OI):LLM 捏造超出证据支持的用户属性的现象。 方法:我们引入 MirageBench,包含 150 个人设(在刻板、反刻板和中性画像间均衡)、6 个个性化任务(覆盖“想象梯度”)、一个由独立裁判操作的四类忠实性分类法(基于 400 条声明与盲态人工标注验证:Cohen's kappa = 0.863(四类),0.900(二值)),以及一个涵盖 7 个家族 12 个模型的排行榜(共判定 143,616 条声明)。 实验:我们发现过度推断普遍存在:所有 12 个模型均对 35%–49% 的声明过度推断(跨模型均值 41.6%;声明加权 41.8%),无一幸免。最值得注意的是,我们发现了自我监控反转:在模型选择层面,模型自评的 OI 与裁判测量的 OI 呈负秩相关(rho = -0.60, p = 0.044;探索性,宽自助 CI [-0.90, +0.06], n = 12)。报告过度推断最少的模型往往被判定为捏造最多,因此自我报告置信度在比较模型时是误导性信号,尽管在单一模型内部,自我审计仍能中等程度地对该模型自身的声明排序(AUROC 0.58–0.83)。 结论:我们进一步表明 OI 依赖任务(27%–59%),且在多轮试验中,推断属性近似线性累积,极少修正。MirageBench 将外部验证(而非模型自我报告)定位为可信个性化的更可靠基础。
论文精读
TL;DR 个性化LLM普遍虚构用户属性(过度推断率35–49%),且自我监控信号颠倒——模型自评越克制,实际虚构越严重,外部验证才是可信基础。
问题
问题背景
个性化大语言模型(LLM)正成为智能助手的核心,它们通过持久记忆构建用户模型,以提供定制化服务。然而,用户模型的忠实度(faithfulness)尚未被系统审视——模型可能在证据不足时“脑补”用户属性,即 过度推断(over-inference)。
现有方法局限
当前个性化系统依赖两类机制却均存在盲区:
- 记忆库与外部审计缺失:多数方案仅用记忆存储用户陈述,却无独立法官验证生成内容的依据是否充分,导致虚构属性难以察觉。
- 自我监控失效:模型常被要求自我审查推断是否合理,但本研究发现 自我监控反转(Self-Monitoring Inversion):模型自我报告的过度推断率与真实过度推断率呈负相关(Spearman rho = -0.60),即“越自信越不可信”。这使得模型自我评估成为误导性信号,跨模型比较时尤其危险。
技术挑战与重要性
过度推断源于 LLM 的预训练先验与续写惯性:当对话缺乏明确信息时,模型会依据刻板印象或统计关联自动补全,而非承认不确定性。这导致:
- 风险累积:在多轮交互中,推断出的属性几乎线性增长且很少修正(multi-turn pilot 显示),虚假信息不断沉积,最终污染用户画像。
- 任务敏感:不同任务(如偏好推理、人口属性预测)的过度推断率差异巨大(27%–59%),但无模型能一致避免。
- 安全与公平:在医疗建议、金融推荐等场景,虚构的用户病史或风险偏好可能引发实质伤害,并固化社会偏见。
行业类比
如同推荐系统盲目强化“信息茧房”而无法察觉用户真实需求异化,个性化 LLM 若仅依赖内部置信度,终将产出“看似贴心却完全失实”的交互,侵蚀用户长期信任。
核心洞察
- - **自我监控倒置(Self-Monitoring Inversion)**:模型自身评估的过度推断率与外部法官测量值呈负相关(ρ=-0.60),即模型越“自信”声称自己较少捏造属性,实际上反而捏造得越多。这揭示了当前LLM在自我评估个性化输出忠实度上的系统性错位,与以往工作假设模型自我审计可信截然不同。这一发现直接警告从业者:在模型选型或安全过滤时,若依赖模型自报的置信度或忠实度指标,将得到完全相反的真实排名,外部验证必不可少。
- - **过度推断(Over-Inference)是普适且严重的架构性问题**:在覆盖12个模型、7个家族的评估中,每个模型都有35%–49%的声明属于过度推断,平均41.6%,且无明显模型能幸免。这表明个性化LLM普遍倾向于用预训练先验或刻板印象填补用户信息空白,而非坚持证据边界。该发现打破了“仅靠模型能力提升或对齐微调即可解决个性化忠实度”的幻想,揭示出当前记忆增强架构在忠实度保证上的根本缺陷,亟需从训练目标或解码策略层面进行结构性干预。
方法
任务定义与基准构建
该方法聚焦于过度推理(Over-Inference, OI)——LLM 在为个性化系统构建用户画像时,生成超出给定证据的虚假属性。为此构建 MirageBench 基准,核心流程为:
- 输入: 150 个精心平衡的人物角色(Personas),覆盖刻板、反刻板和中性特征,每个角色附带一段简短的个人描述。
- 关键模块: 设计 6 个覆盖“想象梯度(Imagination Gradient)”的个性化任务(如推断生活方式、预测偏好等),从直接事实提取到高度推测逐步递进。模型在读取角色后生成一系列个性化声明。
- 忠实度分类体系: 每条声明由一个独立法官(Unified Judge,基于 GPT-4o 的提示模板)分为四类: Grounded(有据可依)、Reasonable(合理推断)、Stereotype(刻板印象)、Fabricated(凭空捏造)。法官经 400 条声明与盲注人类标注对比,获得四分类 Cohen’s κ=0.863,二值 κ=0.900 的强一致性。
- 评估指标: 主指标为 OI Rate(Inferred+Stereotype+Fabricated 占比),辅以 Grounded Rate、Reasonable Rate,并引入自我监控差距(Self-Monitoring Gap) 衡量模型自我报告与法官评分的偏差。
- 输出: 对 12 个模型在 7 个家族上的 143616 条判定结果进行统计分析,生成每模型、每任务的 OI 率,并通过 Spearman 排序相关性检验发现自我监控反转(Self-Monitoring Inversion): 模型自我评估的过度推理倾向与法官实测 OI 呈负相关(ρ=-0.60, p=0.044)。此外,设计多轮试点(Accum)来观察推断累积效应。
与同类方法的差异
区别于传统幻觉评测或自我反思研究,该工作将外部验证(独立法官)作为可信基准,系统量化了个性化场景下的过度推理,并首次揭示了模型自我监控的跨模型误导信号,为构建可审计的个性化记忆系统提供了评估工具。
实验
实验设计
MirageBench 基准包含 150 个合成 persona,均匀覆盖刻板、反刻板和中性三类,避免过拟合特定社会模式。配合 6 个个性化任务(从简单偏好回忆到复杂推断,形成“想象梯度”),共计产生 143,616 条模型推断主张。每条主张由一个独立评判模型(与盲审人类标注者一致性 κ = 0.863 / 0.900)按忠实度四分类标注:
- Grounded(证据充分)
- Inferred (Reasonable)(合理推断)
- Inferred (Stereotype)(刻板推断)
- Fabricated(编造)
参评对象覆盖 7 个模型家族、12 款模型(含开源与闭源 API),解码采用贪婪策略。
关键发现
过推断(OI)现象毫无例外地存在:所有模型的 OI 比例在 35%–49%,跨模型均值 41.6%(主张加权均值 41.8%)。最突出的模式是 自我监控反转(Self-Monitoring Inversion):当模型自评 OI 严重性时,其自报值与外部评判测得的 OI 率呈 显著负相关(Spearman ρ = -0.60, p = 0.044)。换言之,自我声称“最诚实”的模型,往往被外部评判抓到最多编造。尽管在单一模型内部,自我审查对自身主张仍保有中等区分力(AUROC 0.58–0.83),但该信号跨模型完全失效。
此外,OI 程度高度 任务依赖(27%–59%),且在 多轮交互试点 中,推断属性近似线性累积,极少修正。
与同类工作对比
区别于通用幻觉研究,本工作将 “有记忆却编造” 这一过推断维度独立出来,连接了 个性化记忆系统 与 语言模型忠实度 两大领域。自我监控反转的发现直接挑战了当前依赖模型自我汇报的评估范式,暗示了 外部验证(外部评判+来源追溯) 是构建可信个性化 AI 的更可靠基础——即便模型内部自审有一定作用,不能作为跨模型选型的依据。
行业影响
落地场景
个性化记忆型 LLM 的过度推断直接影响任何依赖持久用户模型的产品,包括:
- 电商与推荐系统:对话式购物助手根据少量交互就虚构用户偏好(例如“喜欢户外运动”),导致推荐偏差。
- 内容平台:新闻或视频摘要生成时,模型可能无依据地推断用户立场或敏感属性,引发内容安全与信任危机。
- 企业级客服与 CRM:基于历史会话构建客户画像,若模型过度推断职业、意图等字段,将污染下游的营销与分群逻辑。
- 教育辅导与医疗咨询:对学习者能力或患者健康状态的错误推断可能带来误导性建议,合规风险高。
商业价值
- 信任与合规:直接减少因虚构用户属性导致的错误推荐、不当内容推送和法律纠纷,降低品牌声誉风险。
- 成本控制:避免基于错误画像的无效运营活动(如推送错误的优惠券),减少用户流失和客服投诉处理成本。
- 体验提升:当模型能区分“有证据的推断”与“合理猜测”时,可通过溯源标注向用户解释推荐理由,增强透明度与用户控制感。
- 差异化竞争:率先采用外部验证机制的团队能构建更可靠的个性化系统,形成技术壁垒。
与现有产品 / 工作流的接口
- 解耦用户模型与生成:将用户属性存储与生成式推断分离,每次生成前调用一个独立的法官模型(如论文中的 unified judge)验证新推断是否基于实际对话证据。
- 证据链与溯源:在用户画像的每个字段后附加引用(原始对话片段),使下游任务可追溯,也便于人工审核。
- 集成现有监控栈:在 RAG 或 Agent 流水线中加入 OI 率指标,与幻觉率并列监控,偏差过高时自动降级(如回退到无记忆模式)。
- 模型选择陷阱:严禁依赖模型自我审计得分对比不同模型,必须使用跨模型的外部评测基准(如 MirageBench)指导模型选型。
具体落地 use case
- 电商智能客服:某平台部署记忆型对话机器人,用于处理退换货咨询。系统实时记录用户偏好,但在用户仅提及“跑步鞋”一次后,模型自行推断用户“经常参加马拉松”并推荐专业装备。引入外部 judge 后,只有被对话直接证实的偏好(如尺码、品牌)才被存入长期画像,大幅降低错误推荐率。
- 在线教育自适应学习:辅导系统根据学生错题记录推断其“注意力不集中”,进而推荐专注力训练课程。实际可能只是题目过难。通过证据溯源要求模型关联具体行为日志,避免主观标签,使干预策略更精准。
局限
- **单一 LLM 评判者与有限的人类验证**: 论文使用独立 LLM 评判者对声明进行四路忠实度分类,虽然在一组 400 条声明上与盲审人类注释者的 Cohen's kappa 达到 0.863, 但该验证规模相对较小, 且可能无法完全捕捉人类对“合理推断”与“虚构”的细微判断差异。LLM 评判者本身可能继承训练数据中的偏见, 在特定领域或边缘案例上产生系统性错误, 限制了评估结果的可信度。此外, 未与多个人类注释者的共识进行比较, 可能高估了自动评判的稳健性。
- **基准的覆盖范围与生态效度**: MirageBench 的 150 个角色虽然平衡了定型、反定型和中性特征, 但数量仍有限, 且固定角色无法完全模拟真实用户动态变化、多面性的偏好与身份。6 个任务尽管覆盖了“想象梯度”, 但主要集中在静态文档分析, 对对话交互中的增量记忆更新、遗忘等真实个性化场景的刻画不足。多轮试点中的累积推断为线性近似, 实际情况可能更复杂, 结论的生态效度有待更大规模、更多样化场景的验证。
- **自我监控反转的探索性与因果分析缺失**: 所发现的 Self-Monitoring Inversion (模型自我评估的 OI 与真实 OI 负相关, ρ = -0.60) 是基于 12 个模型的探索性分析, 宽 bootstrap 置信区间 [-0.90, +0.06] 表明该关系可能不稳定或受少数模型影响。论文未深入分析反转的深层原因 (如校准偏差、回复长度混淆), 也未提供缓解策略。对于工程实践, 仅指出自我报告不可靠而缺乏替代方案, 使得指导意义受限, 需要更多模型和干预实验来巩固此发现。