JoyAI-Video-Edit: 基于自回归扩散的实时开放式视频编辑
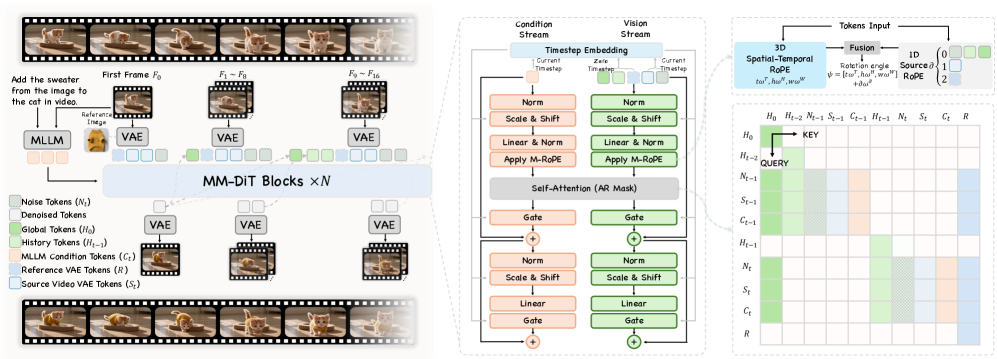
实时视频编辑需要在有限计算资源下进行低延迟的因果生成,同时保持源视频保真度和长期时间一致性。我们提出 JoyAI-Video-Edit,一个 16B 参数的自回归扩散框架,用于实时、开放式的视频编辑,无需访问未来帧或预定义视频时长。 我们的方法结合了分块自回归适配、源锚定分布匹配蒸馏 (Source-Anchored Distribution Matching Distillation, SA-DMD) 和长时程自回归蒸馏,以减少训练-推理不匹配、在两步生成中保持源保真度,并缓解累积的时间漂移。 大量自动化和人工评估表明,JoyAI-Video-Edit 显著优于现有的流式编辑系统,并且在短视频和长视频上均与强离线系统保持竞争力。完整系统在单个 Nvidia B200 GPU 上实现了约 30 FPS 的端到端 720p 视频编辑。代码已开源:https://github.com/jd-opensource/JoyAI-Video-Edit.
论文精读
TL;DR JoyAI-Video-Edit 是 16B 自回归扩散模型,实现实时开放式视频编辑,无需预知未来帧,单卡 720p 30FPS,保真度和一致性显著超越流式方法。
问题
实时视频编辑的核心挑战
随着视频内容生成与消费向实时化演进,指令引导的视频编辑 正从离线后期工具走向持续可用的在线服务。在直播、AR 交互、视频会议等场景中,系统需在视频流到达时即时生成编辑帧,且不依赖未来信息,这对模型架构与推理效率提出全新要求。
现有方法的局限
主流扩散模型(如 Stable Diffusion、VideoComposer)依赖多步去噪与全局时空注意力,无法满足流式因果编辑:
- 必须访问完整视频或预定义长度,不能逐帧/逐块即时生成;
- 蒸馏加速(如 LCM、DMD)虽降低步数,却常导致 源帧细节丢失 和 时序不一致;
- 现有流式方案(如 TokenFlow、CoDeF)在分块处理时存在 训练-推理窗口不匹配,长视频累积漂移严重,且保真度不足。
难点与重要性
实时视频编辑需同时应对三大挑战:
- 低延迟:720p@30FPS 要求在单卡上完成端到端推理,传统扩散模型计算量过大;
- 源保真度:编辑必须严格保留未指定区域的背景与人物身份,任何失真在视频流中会被立即察觉;
- 长程时序一致性:自回归生成易出现误差累积,导致闪烁或结构突变,破坏了观看体验。
这些技术难题直接制约了实时视觉 AI 在内容创作、交互媒体等千亿级市场的落地,因此高效、高保真的流式编辑成为学术界与工业界共同攻坚的方向。
行业类比
流式视频编辑 与实时语音翻译类似,都需在连续输入下即时产生连贯输出,既不能依赖“听完/看完所有内容”,又要保证质量不会随长度而衰退。
核心洞察
- **自回归扩散模型与流式视频编辑的结合** 通过 chunk-wise 自回归适应将扩散模型改造为因果生成器,无需未来帧即可实时处理任意长度视频,与依赖完整视频的离线编辑系统形成本质差异。这种设计使得模型可以在单 GPU 上以 30 FPS 完成 720p 编辑,为直播、视频通话等低延迟场景提供了可行的技术路线,并采用长时域自回归蒸馏缓解累积漂移,突破了自回归模型长序列生成的稳定性瓶颈。
- **Source-Anchored Distribution Matching Distillation (SA-DMD)** 在将生成步数压缩至仅两步的极端蒸馏条件下,依然保持对源视频内容的高保真编辑,避免了传统蒸馏常见的细节损失或编辑意图漂移。这一方法通过分布匹配目标直接锚定源帧信息,实现了效率与保真度的平衡,对需要低计算预算的端侧部署具有直接参考价值,且其与长时域自回归蒸馏的联合训练进一步保证了跨帧一致性。
方法
JoyAI-Video-Edit 方法围绕自回归扩散框架构建,将视频编辑视为因果序列生成任务:给定当前帧和编辑指令,逐块预测后续帧,无需未来帧或预设总时长。
输入与基础架构
输入为在线视频流和用户指令(如“将天空换成黄昏”)。模型基础是一个 16B 参数扩散 Transformer,经过基础训练后具备视频生成能力。随后通过三个关键模块适配为实时编辑器。
关键模块
分块自回归适应(Chunk-wise Autoregressive Adaptation)
将视频划分为固定大小的块(如 4 帧),每个块内使用因果注意力,仅基于之前的块和当前块内已生成帧预测后续帧。这种设计模拟推理时的逐块到来模式,消除训练‑推理不匹配,并支持任意长度视频的流式处理。源锚定分布匹配蒸馏(Source-Anchored Distribution Matching Distillation, SA-DMD)
用于在极少采样步(2 步)下保持编辑结果与源视频的结构一致性。SA-DMD 通过分布匹配损失将学生模型(快速推理)的输出分布与教师模型(多步扩散)对齐,同时添加源锚定约束,强制保留源帧的关键特征(如边缘、物体位置),既加速又防止过度编辑。长时域自回归蒸馏(Long-Horizon Autoregressive Distillation)
在长视频中,自回归生成会累积时间漂移。该模块在训练时模拟长序列生成,通过蒸馏迫使模型在较长时间步上保持与真实编辑分布的一致性,从而减轻漂移,提升长视频的时间一致性。
输出与部署
最终系统在单张 Nvidia B200 GPU 上实现端到端 720p @ ~30 FPS 的实时编辑输出。
与同类差异:相较于现有流式编辑器(如 StreamMultiDiffusion),JoyAI-Video-Edit 通过分块自回归适配 + 双蒸馏策略,在保真度、时间一致性上大幅领先,甚至接近离线全帧编辑器的性能。
实验
实验设计
评估设计覆盖两大维度:自动指标与人工评估。自动评估在短视频和长视频上对比主流流式编辑器及离线系统,衡量源保真度、时间一致性与编辑质量。人工评估则关注感官质量与指令跟随度。系统效率在单张 Nvidia B200 GPU 上测量端到端延迟,以验证实时性。
关键发现
JoyAI-Video-Edit 在流式编辑任务中显著超越现有方法,同时与离线系统保持竞争力。在 720p 分辨率下,模型稳定达到约 30 FPS,满足实时交互需求。核心创新点作用明显:
- Source-Anchored DMD 缓解了蒸馏带来的源内容丢失,在两步生成中保持源保真度;
- Long-Horizon Autoregressive Distillation 有效抑制了长时域累积漂移,使长期一致性大幅提升。
基线对比深度解读
与离线系统相比,该模型以接近的质量实现了因果、低延迟的流式处理,打破了“高质量必需离线”的固有认知;与现有流式编辑器相比,其在保真度和一致性上优势明确,证明了自回归蒸馏框架在实时视频编辑领域的突破。但离线系统在极端复杂编辑场景下可能仍有质量优势,未来需在蒸馏效率与编辑灵活性之间进一步权衡,并探索更通用的指令跟随能力。
行业影响
落地场景
JoyAI-Video-Edit 的实时、开放词汇视频编辑能力,使其天然适用于需要低延迟流式处理的交互式应用。典型场景包括:
- 直播与视频会议:实时替换背景、添加虚拟道具或美颜,无需预定义视频时长,编辑指令可随画面动态调整。
- 短视频与内容创作:创作者在拍摄过程中即时应用风格化、对象替换等效果,缩短后期制作周期。
- 交互式娱乐:在游戏直播或虚拟现实应用中,根据观众指令实时修改画面元素,提升参与感。
商业价值
系统在单张 Nvidia B200 GPU 上实现 720p、约 30 FPS 端到端编辑,为以下商业目标提供直接支撑:
- 降低成本:将原本需要离线集群处理的高质量视频编辑任务压缩到单卡实时完成,大幅减少云端推理成本。
- 拓展收入:为直播平台、短视频工具提供差异化付费功能(如实时特效包、品牌定制滤镜),提高用户付费意愿。
- 体验提升:流式编辑消除了传统离线等待,使创作过程“所见即所得”,能显著提高用户留存与使用时长。
集成接口与工作流
模型以 自回归扩散框架 输出因果帧序列,可无缝嵌入现有视频管线:
- 输入侧:接受连续视频流与文本/图像引导指令,与标准推流 SDK 兼容。
- 处理侧:通过分块自回归蒸馏与分布匹配蒸馏,将推理步数压缩至 2 步,易于封装为微服务并部署在 GPU 节点上。
- 输出侧:直接生成编辑后的帧序列,可对接后续编码、推流或本地渲染模块。
典型行业用例
- 电商直播:主播实时试穿虚拟服装或切换商品展示背景,编辑效果随镜头运动保持时间一致性,降低物理样品与布景成本。
- 在线教育:教师在直播授课时动态添加板书动画、实验演示叠加层,增强远程教学交互性,且模型支持开放词汇指令,无需预设模板。
局限
- - **硬件依赖性强**:模型参数量为 16B,推理需要 Nvidia B200 等高端 GPU,论文未讨论在消费级或边缘设备上的部署可行性。720p 30FPS 的性能指标虽然领先,但计算成本限制了其在资源受限环境(如移动直播、嵌入式系统)中的采用,削弱了实时编辑的普适性。
- - **编辑保真度与蒸馏的权衡**:Source-Anchored DMD 将生成步数压缩至两步,虽然大幅降低延迟,但可能牺牲部分细节还原能力或复杂编辑(如大幅结构修改)的灵活性。与离线多步扩散模型相比,在极端编辑任务中可能产生更多伪影或保真度下降,论文缺少对蒸馏损失上界的量化分析。
- - **长视频累积误差缺乏深度分析**:Long-Horizon Autoregressive Distillation 旨在缓解时序漂移,但自回归因果生成本质上无法完全避免帧间误差累积。论文仅在典型长度视频上评估,未明确给出在超长视频(数十分钟以上)或剧烈运动场景下一致性失效的条件与边界,工程实践中需自行评估风险。