UniWorld-Design: 从像素生成到图层原生设计
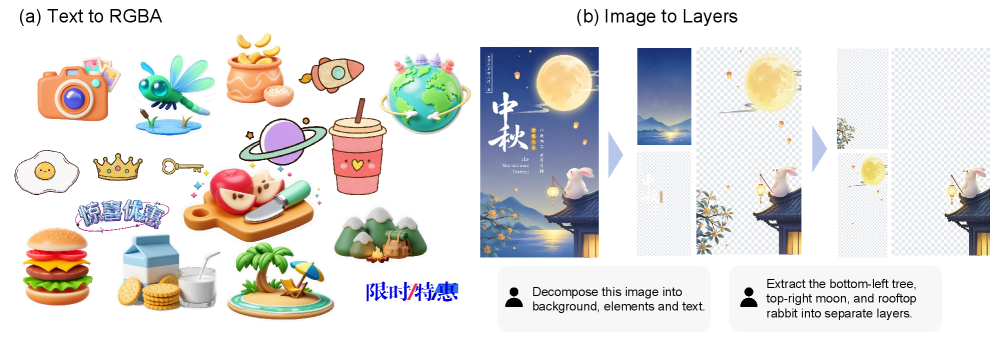
我们提出 UniWorld-Design,一个将图像生成从平面像素合成重构为结构化视觉组合的框架,以 语义 RGBA 图层 作为生成、理解和编辑的原子单元。核心洞察在于:像素定义图像的渲染方式,而图层定义图像的创建、理解和编辑方式。正如人类设计师通过图层而非原始像素来创建和操作视觉内容,UniWorld-Design 为多模态生成模型赋予了图层原生的设计空间。 UniWorld-Design 由两个模型组成。Text-to-RGBA(T2RGBA) 模型直接从文本生成独立的 RGBA 资产;Image-to-Layer(I2L) 模型以成品图像、全局指令和逐图层提示为条件,联合生成有序且完整的语义 RGBA 图层。其指令接口支持 顶层分解、递归分解 和 定向提取,使分层成为一种可通过指令寻址的操作,适用于智能体编辑。由于 I2L 学习的是完整语义对象而非可见像素分割,其图层在移动或移除后依然可用。 在 Crello 基准上,I2L 将逐层 RGB L1 误差降低 37%,并在 Alpha Soft IoU 上较 Qwen-Image-Layered 取得 34% 的相对提升。此外,T2RGBA 取得最高 CLIP Score,优于 LayerDiffuse 和 OmniAlpha。
论文精读
TL;DR 将图像生成从像素合成推进到以语义 RGBA 层为原子单位的层原生设计,实现结构化构图与可编辑性,分层质量提升显著。
问题
问题背景
多模态生成模型的发展正从纯粹追求像素级真实感,转向对图像结构化、可编辑性的需求。设计行业的工作流天然依赖图层,但现有 AI 生成工具普遍停留在“一张图”的模式,难以无缝融入设计、复用和迭代流程。
现有方法局限
- RGBA 生成:如 LayerDiffuse 和 OmniAlpha 虽支持带透明度通道的资产生成,但仅能处理单个前景对象,缺乏对完整场景多对象、分层结构的建模能力,且无法从已有成品图反推图层。
- 图层分解:现有方案(如 Qwen-Image-Layered)本质做可见像素分割,输出的图层仅包含未被遮挡的“碎片”区域,一旦移动或删除某一层,便暴露空洞,无法还原完整物体。这违背了图层编辑的初衷:对象应保持语义完整性。
- 交互接口:缺少指令可控的分解方式,无法按需进行顶层分解、递归拆分或定向提取,使得图层化操作难以集成到 Agent 驱动的自动化编辑管线中。
难点与重要性
从单张成品图推断完整语义图层是一个严重欠定问题:模型必须“想象”出被遮挡部分的形状与纹理,同时保持各层之间的空间一致性和遮挡关系。这要求生成模型具备形状补全、语义理解与层次化合成能力。此外,生成图层的高保真(Alpha 边缘质量、像素对齐)直接影响后续编辑的可用性。在模板设计、广告创意、游戏资产生成等场景中,直接输出分层源文件可将后期修改成本降低一个数量级,因此受到工业界的广泛关注。
行业类比
如同前端开发从“切图标注”演进到组件化设计系统,分层生成让 AI 模型直接输出可编辑的“设计源文件”,把生成结果从一次性成品转化为设计迭代的起点。
核心洞察
- **从像素合成到图层原生设计的范式转换**。UniWorld-Design 将图像生成重新定义为以语义 RGBA 层为原子单元的创作过程,区别于以往以像素为中心的生成模型(如 Stable Diffusion)或仅在后处理中引入图层的方案(如 LayerDiffuse)。其核心主张“像素定义渲染方式,而层定义创作、理解与编辑方式”直指设计意图的保留:生成模型直接学习完整语义对象(包括被遮挡部分),使层在移动或删除后仍然可用,为下游编辑提供真正的结构化资产。
- **指令可寻址的分层操作与完整对象学习**。Image-to-Layer(I2L)模型通过全局指令和逐层提示联合生成有序的语义 RGBA 层,支持顶层分解、递归分解和定向提取,将分层变为可直接编程的操作。与仅分割可见像素的图层分解方法(如 Qwen-Image-Layered)不同,I2L 学习完整语义对象,因此在层移动后仍保持内容完整性,在 Crello 基准上 RGB L1 误差降低 37%,Alpha Soft IoU 相对提升 34%。这为代理式(agentic)编辑流程奠定了交互基础。
- **文本到 RGBA 的高质量直接生成**。Text-to-RGBA(T2RGBA)模型直接从文本生成独立 RGBA 资源,通过 RGBA 自编码器与 RGB 潜在对齐训练策略克服了通道扩展难题,在 CLIP Score 上超越 LayerDiffuse 和 OmniAlpha。该方法使生成透明素材的语义一致性显著提升,可无缝接入图层原生设计空间,填补了现有文本到透明图像生成在质量和可控性上的不足。
方法
整体框架
UniWorld-Design 将图像生成从像素合成提升至结构化层组合,核心包含两个模型:Text-to-RGBA (T2RGBA) 与 Image-to-Layer (I2L),二者共享一个 RGBA 自编码器 作为潜在空间桥梁。
输入
- T2RGBA:仅文本提示。
- I2L:一幅完整图像、全局指令(如“分解为语义层”)以及每层对应的文本提示。
关键模块
RGBA 自编码器与 RGB 潜在对齐
在标准 RGB 自编码器基础上扩展输入/输出通道至 4,同时通过训练让 RGBA 潜在空间与预训练 RGB 潜在空间对齐,使后续扩散模型能直接利用成熟的 RGB 文本到图像先验。T2RGBA 生成
基于流匹配或扩散范式,在 RGBA 潜在空间上执行去噪过程,从随机噪声和文本条件生成独立的 RGBA 素材(包含透明度通道)。指令控制的 I2L 分解
- 层–指令绑定注意力:将每层的文本提示与对应图像区域强制关联,避免层间混淆。
- 层索引 3D 旋转位置编码:为不同层赋予可区分的位置信号,使模型理解层的顺序与空间关系。
- 条件训练:同时以全局指令和逐层提示为条件,联合预测所有层的 RGB 和 Alpha 通道。
- 支持三种操作模式:顶层分解、递归分解、定向提取,使分层变成可由语言指令触发的原子操作。
语义层树构建与训练监督
从 PSD 文档自动构建语义层树,通过树结构推导监督信号,明确保留遮挡区域的内容(而非仅分割可见像素)。训练时结合渐进式对抗蒸馏与任务特定奖励(如 Alpha Soft IoU),提升层完整性与可编辑性。
输出
- T2RGBA:直接可用的 RGBA 图像素材。
- I2L:一组有序、完整的语义 RGBA 层,每一层对应一个独立对象,即使被遮挡或移出画面边缘也能保持完整形状。
与同类方法的差异
I2L 并不学习“可见像素的划分”,而是推断每个对象的完整语义形状(包括被遮挡部分),这使其层在移动或删除后仍保持可用,而 Qwen-Image-Layered 等方法因仅分割可见区域,编辑后会出现空洞或残缺。
实验
实验设计
UniWorld-Design 从两个维度验证层原生生成能力:
- Image-to-Layer (I2L):在 Crello 基准上与 Qwen-Image-Layered 对比,评估逐层 RGB L1 误差和 Alpha Soft IoU,同时通过编辑性测试衡量层的可移动与可移除性。
- Text-to-RGBA (T2RGBA):使用 CLIP Score 与 LayerDiffuse、OmniAlpha 比较文本对齐质量。
关键发现
- I2L 的 per-layer RGB L1 误差降低 37%,Alpha Soft IoU 相对提升 34%,且分解出的层在移动/移除后仍保持完整——这源于模型学习完整语义对象而非仅可见像素分割,尤其在遮挡区域能推理出被遮挡内容。
- T2RGBA 取得了最高的 CLIP Score,证明其生成的 RGBA 资产与输入文本语义一致性最优。
基线对比解读
Qwen-Image-Layered 作为像素分割式方法,常产生残缺边缘与可见伪影;I2L 通过指令可寻址分解(包括顶层分解、递归分解、定向提取)生成有序的完整 RGBA 层,大幅提升编辑可用性。T2RGBA 超越 LayerDiffuse 和 OmniAlpha 的关键在于 RGB 潜在空间对齐的 RGBA 自编码器与渐进式对抗蒸馏,使生成的透明通道边缘更精准、视觉质量更高。
行业影响
落地场景
UniWorld-Design 将图像生成从扁平像素合成升级为 语义 RGBA 层原生设计,直接服务于需要灵活编辑与结构化素材的场景。典型应用包括:
- 在线设计平台:如 Canva、Figma 等,用户上传参考图后自动拆分为可独立移动、替换的矢量/位图层,无需手动抠图。
- 电商广告自动化:批量生成商品展示图,通过 Image-to-Layer 将成品图分解为产品、背景、文案等独立层,便于 A/B 测试不同布局或促销标签。
- 社交媒体内容创作:为内容创作者提供 文本直出带透明通道素材 的能力,快速合成创意图片。
- 游戏/影视资产生成:直接用文本生成 RGBA 精灵、图标,或从概念图提取分层资源,加速前中期制作。
商业价值
核心价值在于 降本 与 增收 双线:
- 降本:传统设计流程中,抠图与分层占设计师大量时间(据估算可占素材处理工时的 30% 以上)。I2L 模型在 Crello 基准上降低 37% 的 RGB L1 误差,Alpha Soft IoU 相对提升 34%,意味着人工修正量大幅减少,人力成本直线下降。
- 增收:更快的素材迭代速度让营销活动能够实时响应热点,从而提高广告点击率与转化率。同时,T2RGBA 模型生成的透明素材可直接融入多种设计方案,缩短从创意到上线的周期,提升总体广告消耗。
与现有产品 / 工作流的接口
- API 集成:以 RESTful API 或 gRPC 形式提供,输入图像或文本指令,输出分层 PSD / SVG / 带 alpha 通道的 PNG 序列。可直接嵌入已有内容管理系统 (CMS) 或智能设计工具中。
- 插件生态:开发 Figma / Adobe 插件,让设计师在熟悉界面中一键完成分层或生成资源,降低迁移成本。
- Agentic 编辑流水线:I2L 的指令接口支持
top-level、recursive分解与targeted抽取,可被编排为自动化编辑 Agent,例如在电商系统中,对每个新 SKU 自动生成多套广告分层模板。
具体落地 Use Case
- 全球化电商平台的广告素材工厂:某电商平台每天需生成数万张产品推广图。利用 I2L 将设计稿自动拆分为产品主体、光影背景、促销文案等层,运营人员只需替换文本或调整位置,无需另行设计,单人产能提升 5 倍以上。
- 在线印刷设计工具:类似 Vistaprint 的服务,用户上传 logo 和图片后,系统使用 T2RGBA 生成可印刷的装饰元素(如徽章、边框等)并直接以透明层叠加,确保印刷质量与后期编辑灵活性。
局限
- **Alpha 边缘与密集文字渲染缺陷**。论文明确指出,模型在生成包含锐利边缘或半透明区域(如毛发、玻璃)的 RGBA 层时会产生伪影,尤其在处理**密集排版**(dense typography)时表现不佳,对**中文文本**的渲染更是明显短板。这限制了其直接产出专业平面设计素材的可用性,因为设计师对边缘质量和文字精度要求极高,此类伪影仍需后期修补。
- **训练数据依赖与泛化性瓶颈**。该方法的核心监督来自从 PSD 文档提取的**语义层树**,这要求训练集具备完整的分层元数据。因此,模型对无图层信息的自然图像(如照片)进行层分解时,泛化能力受限,可能产生语义不合理或不完整的分层结果。实验仅基于 **Crello** 等合成设计数据集,在真实场景素材上的鲁棒性仍有待验证。
- **与更广泛分解范式的对比不足**。I2L 主要对标 **Qwen-Image-Layered** 等近期方法,但未系统比较基于分割大模型(如 **SAM**)或交互式抠图(matting)的混合方案。这些方法在边缘细节上可能更具优势。此外,当图层间存在复杂遮挡与透明度混合时,模型输出的层次结构可能累积重建误差,影响对层可编辑性要求严苛的专业工作流。