Omega-S: 大语言模型微调的功能韧性指标
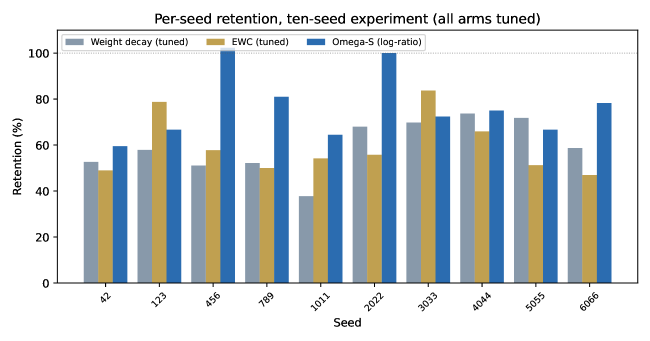
在微调大语言模型时,新数据的学习往往会破坏模型先前获得的能力。我们提出 Omega-S,一种即插即用的惩罚项,仅由权重矩阵计算而得:它无需先前任务数据、无需 Fisher 矩阵,也无需存储旧权重副本。在现有训练循环中仅需三行代码,且每步计算成本增加不到 4%。 在保留能力方面,使用 Llama-3-8B 与 LoRA 进行实验,从代码微调到散文,并以 HumanEval 在十次随机种子上测量。Omega-S 在 9/10 个种子上比无正则化保留更多原始能力(pass@1 从 0.173 提升至 0.238;符号检验单侧 p=0.011,Wilcoxon p=0.006),保留率从 62.9% 提升至 84.1%。同时,它在 10/10 个种子上优于调优的权重衰减(p=0.002),并在 8/10 个种子上优于调优的 EWC(p=0.014),所有对照均在相同会话中重新测量。 机制层面,我们通过测量而非断言来验证。Omega-S 在设计上是拓扑的,其目标函数基于 Tr(A^3) 构建,但我们测得其四个因子中三个实际上并不起作用:它们对权重的弹性不超过 1e-4,而度数方差项为 9e-3。实际实现中,复合项本质上变成对节点度数方差的惩罚,即对方阵模块的行幅值和非方阵模块的方向对齐进行惩罚。我们报告这一点,因为一个名称所承诺的与实际梯度所做不同的方法应当说明自身。我们亦列出了开放的设计选择,包括一种保对比度构造——它确实按设计工作,但在所有十个种子上反而使保留效果更差。 重复相同配置(相同种子与硬件)时,保留率的标准差为 0.104。我们尚未发现低秩语言模型微调中有此量化,而这限制了该领域所有种子配对比较(包括我们自己的比较)。代码、逐种子结果及完整负面记录均公开可用。
论文精读
TL;DR Omega-S 是一种即插即用的低秩微调正则化项,仅凭权重矩阵计算节点度方差并施加惩罚,无需旧数据即可显著保留 LLM 原有能力,计算开销不足训练步的 4%。
问题
问题背景
大语言模型(LLM)微调后,在新任务上表现提升的同时,往往会遗忘旧任务的能力,这一现象被称为“灾难性遗忘”。如何在不访问原始训练数据、不存储历史模型副本的前提下,提升微调后的能力保留率(retention),是持续学习与模型工程部署中的核心难点。
现有方法局限
现有主流方法存在明显不足:
- 弹性权重巩固(EWC) 依赖费舍尔信息矩阵(Fisher)估计参数重要性,但需要旧任务数据或梯度,计算开销大,且对低秩适配(LoRA)支持有限。
- 权重衰减仅能限制参数范数,无法区分关键连接,保留效果不稳定。
- 多数方法需要存储旧权重或回放数据,在隐私敏感或存储受限场景不可用。 此外,现有实验对运行间变异性缺乏量化,无法区分方法提升与随机波动。
技术挑战与重要性
LLM 微调已从全参数转向低秩适配(如 LoRA),但低秩空间内的稳定性-可塑性权衡仍未被清晰解耦。理想方法应:
- 无需访问旧数据或旧权重;
- 计算成本极低,可嵌入训练循环;
- 能自适应保护关键拓扑结构,而非仅约束范数。 从行业视角看,模型需频繁在多个垂直场景间迭代,若每次微调都导致核心能力退化,将大幅增加评测成本与回滚风险,因此无感式能力保留方案在 MLOps 管道中需求强烈。
行业类比
类似自动驾驶感知模型的持续迭代——在不回放海量历史路测数据的条件下,新场景训练后仍要保证对基础交通元素的稳定识别,这要求正则项能够自动保护网络中的“关键连接”,Omega-S 正是从图拓扑角度提供了这样一种解法。
核心洞察
- Omega-S 的实际正则化效果几乎完全源自对权重矩阵节点度方差的惩罚,而非其构造时宣称的 Tr(A^3) 复合目标。论文直接测量了四个因子随权重变化的弹性,发现除度方差项外其余弹性均低于 1e-4,从而揭示方法名与梯度方向的不一致。这一做法与大多数正则化工作形成鲜明对比:多数方法倾向声称某种几何或拓扑机制,但很少提供梯度层面的实证;本文的“测量而非断言”使得工程落地时可以放心忽略复杂推导,直接理解为一个简单的度平衡惩罚。
- Omega-S 是纯粹基于权重矩阵的即插即用惩罚项,不需要旧任务数据、Fisher 矩阵或存储旧权重,仅需三行代码即可集成到现有训练循环,单步开销低于 4%。同类方法如 EWC 需要 Fisher 信息与旧权重副本,调整后的权重衰减(tuned weight decay)也需要仔细调参;而 Omega-S 以无数据、无状态的方式,在 Llama-3-8B 的 LoRA 微调中实现更优的原始能力保留(10 个种子中 9 个优于无正则化,全部优于调参后的权重衰减),且对低秩适配器透明,极具工程实用性。
方法
Omega-S 是一个专为 LoRA 低秩适配 设计的即插即用正则化惩罚项,核心思想是通过维护权重拓扑结构的“度分布均匀性”来抑制灾难性遗忘。
输入与构建
直接作用于 LoRA 适配器的权重矩阵 W(即低秩矩阵 BA),无需任何旧任务数据、Fisher 矩阵或权重快照。将 W 视为一个无向图的邻接结构:
- 对于 方阵模块(如 attention 中的投影层),定义邻接矩阵
A = W^T W,节点度对应行范数; - 对于 非方阵模块,方向对齐量替代行范数,以统一度量节点重要性。
关键模块:从 Tr(A³) 到度方差惩罚
Omega-S 的原始形式是 Tr(A³) 的迹惩罚,其内在拓扑意义是惩罚图中三角形聚集的不均匀性,从而抑制“权重垄断”(即少数节点主导信息流)。实际部署时,通过对数比复合形式 Log-Ratio Composite 实现,最终梯度几乎全部由 节点度序列的方差 驱动:作者实测发现,目标函数中四个因子有三个的弹性系数低至 10⁻⁴ 量级,仅度方差项弹性达 9×10⁻³,因此方法本质上退化为一个简洁的度方差惩罚。
计算与开销
每步仅需计算权重矩阵的度序列及其方差,可结合 Hutchinson 迹估计器 以保持低开销。实测在 Llama-3-8B LoRA 微调中,单步额外耗时低于 4%。
输出
返回标量惩罚值,直接累加到微调任务损失上,形成 loss = task_loss + λ·Ω(W)。训练循环中仅需三行代码插入。
与同类方法的差异点:Omega-S 完全从权重矩阵的拓扑属性自身构造正则项,无需像 EWC 那样依赖 Fisher 信息矩阵来评估参数重要性,也避免了 L2 衰减 对所有方向的无差别压制,天然适配 LoRA 低秩结构,以极低成本实现平稳的可塑性 - 稳定性权衡。
实验
实验设计
- 模型与微调:Llama-3-8B + LoRA,从代码生成任务微调至散文生成,再用 HumanEval 评估原始代码能力保留。
- 对比基线:无正则化、经过调参的 weight decay 和 EWC(弹性权重巩固),各在 10 个随机种子上运行。
关键发现
- 保留能力显著提升:相对于无正则化,Omega-S 将绝对
pass@1从 0.173 提高到 0.238(+0.065),保留率从 62.9% 提升至 84.1%(9/10 种子胜出,p=0.011)。 - 全面超越经典方法:在一对一比较中,Omega-S 在 10/10 种子 上均优于 weight decay(p=0.002),在 8/10 种子 上优于 EWC(p=0.014),且无需旧数据或 Fisher 矩阵。
- 作用机制揭示:梯度测量表明,复合惩罚项中仅节点度方差项实际活跃(弹性 ~9e−3),其他三项几乎不移动(≤1e−4),因此 Omega-S 实际上退化为对 权重行范数方差 的惩罚,有效防止了少数节点垄断表征。
- 运行间变异量化:相同配置下保留率的标准差达到 0.104,这一变异性在以往低秩微调文献中未被强调,可能影响种子对比较的可靠性。
基线对比解读
Weight decay 和 EWC 分别依赖全局范数约束和过去任务的重要性估计,而 Omega-S 仅从当前权重矩阵的拓扑结构出发,通过抑制度分布的方差来保持网络的均衡性。这本质上是一种 无需任何任务数据的结构化正则,其实现仅需三行代码,计算开销不足 4%,为持续微调提供了高性价比的解法。同时,作者坦诚揭示了实际生效的单一因素,保证了方法的透明性与可复现性。
行业影响
落地场景
Omega-S 特别适用于大模型持续微调 (Continual Fine-Tuning) 的场景,尤其是通过 LoRA 等低秩适配方式,频繁更新模型以适应垂直领域任务,但又不希望丢失基础能力的业务。例如:
- 智能客服与对话系统:针对不同客户群、产品线或合规区域,需要持续注入新知识,同时保持礼貌、安全过滤、通用问答等核心行为的稳定。
- 代码助手与开发工具:为特定组织或框架定制代码补全/审阅能力,但要保留通用的编程语言理解与最佳实践,避免微调后模型对旧任务完全退化。
- 内容安全与审核平台:需快速适应新兴有害模式(如新型仇恨言论、欺诈模板),但基础的安全判断标准不能因新数据而偏移。
商业价值
Omega-S 直接降低灾难性遗忘 (Catastrophic Forgetting) 带来的隐性成本:
- 节省计算与存储开销:无需保留旧模型副本或回放数据,也无需计算昂贵的 Fisher 矩阵(如 EWC),训练步长开销仅增加 < 4%,极大利于大规模部署和频繁更新。
- 提高模型利用率:一份基础模型可通过多条 LoRA 路径服务多种垂直场景,而 Omega-S 保证基础能力不被后来的 LoRA 模块覆盖,使模型复用率提升,减少重复训练成本。
- 加速迭代与风险控制:产品团队可更自由地试验新的数据集,而不必担心“微调越好,原任务性能越差”的困境,从而缩短上线周期,同时降低线上事故风险。
与现有产品/工作流的接口
Omega-S 作为 即插即用 (drop-in) 的正则项,三行代码即可嵌入现有训练循环:
- 在 PyTorch 训练循环中,对 LoRA 权重矩阵调用
Omega_S_penalty = compute_omega_s(weight_matrix)。 - 将返回的惩罚值乘以一个可调的超参数
lambda后加到总 loss 上。 - 无需修改数据加载、评估流程或推理管线,完全兼容 Hugging Face Transformers、PyTorch Lightning 等主流框架。
与现有方法的差异与集成优势:
| 方法 | 需要旧数据/旧模型 | 额外计算开销 | 集成难度 |
|---|---|---|---|
| EWC | 需要 Fisher 信息阵 | 高(需存储和计算二阶梯度) | 中等 |
| Weight Decay | 不需要 | 低 | 简单 |
| Omega-S | 不需要 | 极低(<4% 步长耗时) | 最简单(三行代码) |
实际用例
跨国电商平台的 AI 导购:该平台的智能客服需用 LoRA 快速学习最新促销术语、退换货政策,但必须保留基础的意图识别、情绪安抚、多语言翻译能力。Omega-S 可以在每次政策更新时,让 Llama-3 基座上的 LoRA 模块学会新话术,而的 HumanEval 分数(作为通用推理能力代理指标)的保留率从 62.9% 提高到 84.1%,保障基础对话安全,避免因微调导致连贯性下降或安全过滤失效。
医疗辅助诊断系统的持续学习:基于大模型的临床决策支持需不断纳入新的医学指南、药物相互作用数据,但必须保持对通用病理描述、实验室数值判断等基础能力的准确。使用 Omega-S 后,在 LoRA 微调新领域数据时,无需存储或回放敏感的旧病历数据,符合数据合规要求,同时有效维持原有的诊断准确率,降低灾难性遗忘带来的临床风险。
局限
- **泛化性受限**:当前实验仅基于 **Llama-3-8B** 在 **代码→散文** 单一任务上使用 **LoRA** 微调,并以 **HumanEval** 作为保留能力指标。未在更多模型规模(如 7B、13B)、不同架构(非自回归模型)或更广泛的任务类型(如多语言、常识推理)上验证。也未在全面微调(full fine‑tuning)或其它参数高效微调方法(如 Adapter、Prefix Tuning)中测试,方法的通用性存疑。
- **梯度方差与解释性**:作者测量发现复合目标中仅有**度方差项**产生明显梯度,其余三项弹性均低于 1e‑4,实际惩罚退化为对节点度方差的约束(square 模块即行范数,非 square 模块为方向对齐)。虽然声明了机制,但该“简并”现象削弱了其作为**功能韧性指数**的理论深度,且实验测得的保留比率标准差高达 **0.104**,使得不同种子下的对比结论稳定性不足,文献中此类量化少见,可能高估方法的实际优势。
- **对比基线不足**:仅对比了无正则化、调优的**权重衰减**和调优的**EWC**,缺少与近期持续学习方法(如 **SI**、**MAS**、**PackNet**、**HAT**)的系统比较,也未探索与数据回放策略的结合效果。EWC 的实现仅使用调优超参,未必代表最优性能;权重衰减作为控制条件时,其超参搜索范围又引入了新的实验偏差(如附录所述)。此外,声称每步仅增加 **4%** 计算开销,但未讨论对收敛速度或总 wall‑clock time 的影响,实际部署成本仍不明确。