OmniPack: 面向高效全模态大语言模型的统一 Token 压缩
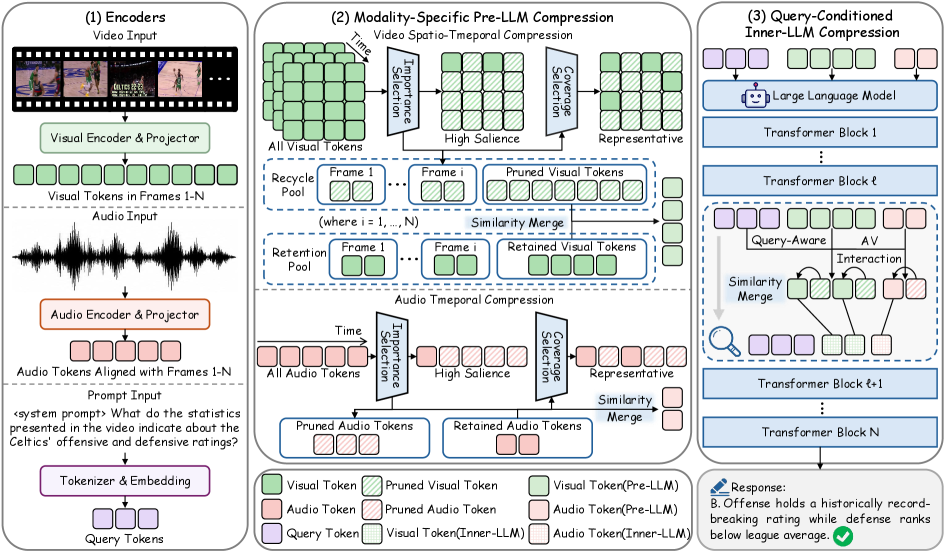
全模态大语言模型在音视频理解上表现优异,但处理长且高度冗余的视觉与音频 token 序列需承担巨大计算开销,迫使研究者采用激进的 token 压缩以提升部署效率。现有方法在低 token 预算下性能退化明显:LLM 前压缩可能丢弃结构重要且全局分布的证据,LLM 内压缩则常未充分利用查询条件下的音视频协作。 针对上述问题,我们提出 OmniPack,一个无需训练的框架,协同 LLM 前的结构压缩与 LLM 内的任务相关语义精炼。在 LLM 之前,OmniPack 通过模态特定重要性、全局覆盖与相似性感知合并去除结构冗余;在充分的多模态交互后,则借助文本指导和音视频协作进一步整合多样化、任务相关的表示。 在三个 Omni-LLM 骨干、五个基准上的大量实验显示,OmniPack 在不同保留比例下均取得最佳性能-效率权衡,优于现有方法。值得注意的是,在 Qwen2.5-Omni-7B 上,OmniPack 保留了 98.0% 的原始性能,同时将 FLOPs 降至 16.7%;即便仅使用 6.8% 的 FLOPs,仍能保持 92.9% 的原始性能。
论文精读
TL;DR OmniPack 无需训练,通过前置结构压缩与 LLM 内查询感知语义精炼协同,大幅降低全模态模型计算量,同时保持近乎无损的性能。
问题
问题背景
全模态大语言模型(Omni-LLMs)在音频、视觉联合理解任务上表现突出,但其输入的视觉与音频 token 序列通常较长且高度冗余,导致计算开销巨大,难以高效部署。
现有方法局限
当前主流 token 压缩方法分为两类,均在低 token 保留率下暴露出明显弱点:
- 预 LLM 压缩(如基于重要性的剪枝或合并):在 token 进入 LLM 主干前直接丢弃部分 token。这类方法容易忽视结构上关键但非局部显著的信息——例如散布在全局的小物体间空间关系——导致下游推理所需的核心证据永久丢失,压缩率越高,性能退化越剧烈。
- 内 LLM 压缩(如查询感知的注意缩减):在 LLM 层间通过查询引导压缩。但这些方法往往只对单模态执行稀疏化,或简单拼接多模态信息后压缩,未能充分挖掘查询条件(问题或指令)引导下的音视频协同,即音频线索如何帮助聚焦相关视觉区域,反之亦然,从而无法在极低计算预算下保留任务相关的多模态语义。
为什么这个问题难且重要
- 技术挑战:多模态 token 序列中,冗余与关键信息交织,且模态间存在互补与冲突。压缩必须辨别任务相关的细粒度语义,同时处理跨模态的长距离依赖,这对无需训练的压缩框架是极大挑战。
- 业界关注度:随着 Omni-LLMs 从研究走向实际应用(如实时会议理解、视频问答),高昂的 FLOPs 与延迟成为落地瓶颈。能在尽可能低的计算量下保持原有性能的压缩方案,是推动全模态模型规模化部署的关键。
行业类比
类似于视频流媒体中的自适应编码——不是简单降低分辨率,而是动态识别并保留对当前观看任务最重要的关键帧与音频段,丢弃感知不敏感的冗余数据,用极小资源开销实现近似无损的体验。
核心洞察
- OmniPack 是一种训练无关的双阶段压缩框架,通过结构化冗余去除与语义细化协同,解决了低 token 预算下性能骤降的难题。与单一的预 LLM 或内部压缩不同,它先利用模态特定重要性、全局覆盖和相似性合并进行无损结构压缩,再通过文本引导的音视频协作精炼任务相关表示,既避免了丢弃全局证据,又充分挖掘了跨模态交互,在多个基座模型上一致达到最优的效率-性能权衡。
- 在极端压缩下仍能保持高精度的能力,展示了冗余精准识别与关键信息保留的工程价值。在 Qwen2.5-Omni-7B 上,FLOPs 仅剩 6.8% 时性能保留率仍高达 92.9%,说明该方法能有效区分冗余与必要信息,从而为全模态 LLM 的实时推理和资源受限部署提供了可行性,大幅降低了计算开销而不牺牲理解质量。
方法
输入与总体流程
OmniPack 面向 Omni-LLMs 的音视频理解任务,输入为视觉 + 音频 token 序列,输出为大幅压缩后的 token 集合,直接供 LLM 推理。其核心思路是将压缩拆分为两个阶段:LLM 之前的模态级结构压缩 和 LLM 内部的任务语义精炼,全程无需额外训练。
阶段一:预 LLM 结构压缩
在 token 进入 LLM 骨干之前,OmniPack 通过三种策略协同剔除跨模态的结构冗余:
- 重要性选择 (importance selection):按模态特定准则(如视觉的注意力分数、音频的能量分布)保留高信息量 token,丢弃噪声帧与静音段。
- 全局覆盖 (coverage selection):强制保留空间/时序上均匀分布的 token,防止局部区域丢失关键证据,弥补纯重要性筛选的偏置。
- 相似感知合并 (similarity-aware merging):将特征高度相似的相邻 token 融合,抑制重复纹理、背景等冗余,压缩比最高部分常来自此步骤。
经此阶段,token 数量显著下降,但保留结构完整性与全局线索。
阶段二:LLM 内部语义精炼
压缩后的 token 先进入 LLM 前半部进行跨模态交互(视觉与音频充分融合),随后在某一中间层触发查询条件的再压缩:
- 文本引导:利用问题或指令对应的文本 token 作为 queries,计算其与音视频 token 的注意力,动态选择与任务语义最相关的子集。
- 音视频协作:将视觉、音频 token 与文本 queries 的交互得分联合建模,避免各自独立决策导致模态间信息丢失。
精炼后的 token 送入 LLM 剩余层完成推理。这一设计使压缩能适应具体任务,而前期的结构压缩则为内部交互提供更干净的上下文。
与同类方法的差异
不同于单纯的前压缩(易丢弃全局证据)或纯内压缩(缺乏跨模态协作),OmniPack 通过 “结构预过滤 + 语义动态筛选” 双阶段联动,在极低 token 留存率下仍能保持高性能,实测在 Qwen2.5-Omni-7B 上以 16.7% FLOPs 保留 98.0% 原性能。
实验
实验设计
OmniPack 在 5 个音视频理解基准上评估,使用 3 个主流 Omni-LLM backbone(含 Qwen2.5-Omni-7B)。实验覆盖 多种 token 保留率,对比了现有 pre-LLM 压缩(如 FastV、TokenPacker)和 inner-LLM 压缩(如 DPC-KNN)方法。所有实验不进行任何微调,直接测量压缩后的下游任务准确率和计算量(FLOPs)。
关键发现
- 协同压缩优势:Pre-LLM 结构压缩去除视觉 / 音频冗余,保留全局覆盖证据;Inner-LLM 语义细化则利用文本引导和跨模态注意力,进一步融合任务相关 tokens。两者结合在极低预算下(6.8% FLOPs)仍维持 92.9% 性能,远超单一阶段方案。
- 通用性:在多个 backbone 上均取得最佳性能-效率权衡,证明方法不依赖特定模型架构。
- 效率分析:在 Qwen2.5-Omni-7B 上,仅用 16.7% 原始 FLOPs 即可保持 98.0% 原始性能,显著降低部署成本。
与基线对比的深度解读
- Pre-LLM 方法(如 FastV)在低 token 预算时容易丢弃分散但重要的证据,导致性能骤降;Inner-LLM 方法(如 DPC-KNN)虽能利用查询相关性,但缺少前期结构清理,计算浪费仍大。
- OmniPack 的 模态重要性选择 + 全局覆盖 + 相似度合并 前置压缩,确保关键信息不丢失;后续 文本引导的跨模态协作 则聚焦任务相关表示。这种两阶段设计使压缩不再是“丢弃-补充”的零和博弈,而成为逐步提纯,从而在 6.8% 极端预算下仍大幅领先基线。
行业影响
落地场景
全模态大语言模型(Omni-LLM)在音视频理解任务中性能优异,但处理长序列视觉与音频 token 带来巨大计算开销。OmniPack 作为一种训练免提的统一 token 压缩框架,可无缝融入各类音视频 AI 产品,显著降低延迟与成本。典型场景包括:
- 视频理解服务:视频摘要、智能剪辑、内容审核、视频问答等应用需处理高分辨率、长时间输入,压缩后吞吐可提升数倍。
- 实时多模态交互:语音助手结合摄像头、视频会议实时转录与要点提取、AR/VR 环境理解等场景,低时延要求下压缩至关重要。
- 资源受限部署:移动端或边缘设备上的多模态应用,通过大幅缩减 FLOPs 使大模型本地运行成为可能。
商业价值
OmniPack 在 Qwen2.5-Omni-7B 上可将 FLOPs 降至 16.7% 同时保持 98.0% 性能,或在 6.8% FLOPs 下保留 92.9% 性能。这直接带来:
- 推理成本锐减:云 GPU 时租成本与 FLOPs 正相关,同等服务质量可节省 80% 以上算力开销,提升利润率。
- 服务规模扩展:相同硬件资源下吞吐量倍增,便于应对流量高峰,避免过度扩容。
- 用户体验提升:更低延迟带来流畅交互,在实时场景中可显著提高用户留存与满意度。
与现有产品/工作流集成
OmniPack 无需额外训练,作为插件直接应用于现有 Omni-LLM 推理管线:
- 预处理阶段:在 token 输入 LLM 前,通过模态特定重要性、覆盖率选择和相似性合并,削减结构性冗余。
- LLM 内部:在多模态充分交互后,利用文本引导与音视频协作进一步提炼任务相关 token。
- 兼容主流框架:可封装进
vLLM、TGI等推理引擎,或作为模型服务的前置加速模块,对现有系统改动极小。
具体落地用例:
- 短视频内容审核平台:某视频平台每日审核海量用户上传内容,多模态模型需同时理解画面与音频。部署 OmniPack 压缩至 16.7% FLOPs,每年可节省巨额 GPU 成本,且审核准确率几乎无损。
- 智能教育系统:在线教育平台基于视频课程提供自动问答,学生实时提问课程内容。全模态 LLM 经压缩后能在更低延迟下给出答案,提升互动体验,支持更多并发学员。
局限
- OmniPack 需要针对不同 Omni-LLM 骨干和任务手动设定保留比例、相似度阈值等超参数,这使得它缺乏自适应的压缩策略,在动态变化的多模态流式场景中可能难以达到最优的效率和性能平衡;同时,方法虽然无训练,但其模块化设计依赖于对注意力机制和模态重要性的启发式假设,对于未来可能出现的全新 Omni-LLM 架构(例如非 Transformer、稀疏注意力等)的泛化能力尚未被验证。
- 实验仅在五个音频-视觉理解基准上进行测试,未覆盖更复杂的交互(如多轮对话、推理链)或更广泛的模态(如点云、触觉),也未在与生成任务(如图文生成)结合的场景下评估;效率分析以 FLOPs 为主要指标,缺少面向实际部署的延迟、吞吐量和显存占用数据,对工程落地的指导仍有提升空间。