面向大语言模型的高效知识蒸馏:离线Top-K Logits与融合分块KL损失
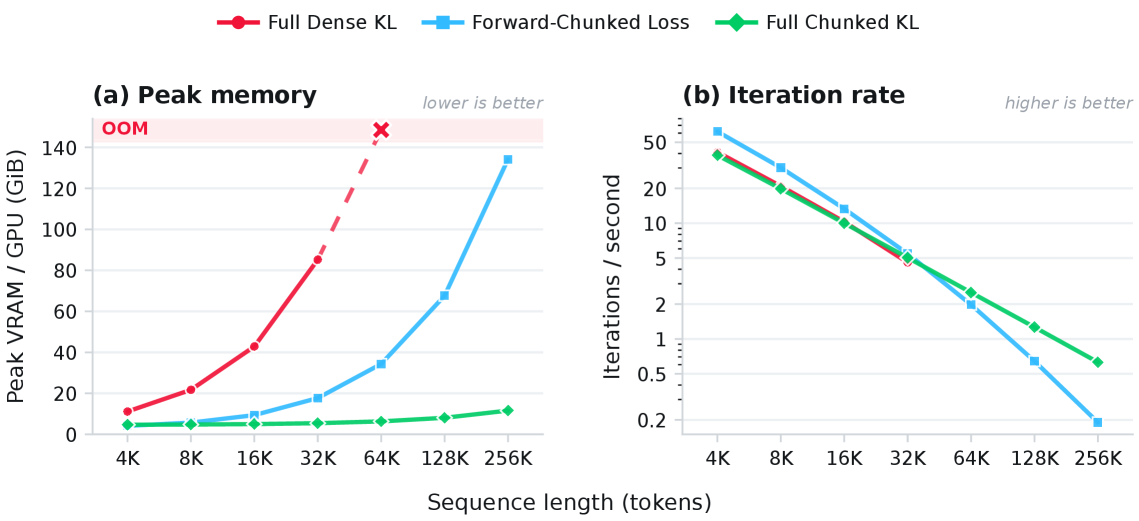
小语言模型在严格延迟、成本和本地部署限制下往往是唯一选择,但很少从零训练:通常通过知识蒸馏(KD) 从压缩模型恢复。该恢复步骤决定了最终质量,但代价高昂。我们围绕两个系统贡献开展了高效的蒸馏训练实践研究。 第一,离线知识蒸馏(缓存教师模型的Top-K logits,训练学生模型对照缓存)在训练损失 上与在线蒸馏几乎一致,同时将教师移出内存,单次迭代约快29%,单张H200 GPU 上吞吐量最高提升41%。第二,我们提出融合分块KL损失,从不实体化完整词表大小的logit张量,使峰值内存与序列长度线性相关,从而消除限制上下文的内存尖峰,并解锁单GPU上4倍上下文(32,768个token) 训练。独立的输出头only基准测试隔离损失核,验证了从4K到256K token的内存与迭代速率扩展。 这些使大规模修复和数百次消融变得可负担。我们还报告了损失设计和序列打包的辅助消融,并开源了分块损失实现。
论文精读
TL;DR 通过离线缓存 top-K 教师 logits 和分块 KL 损失,LLM 蒸馏在质量无损下速度提升 29%,单 GPU 可训 4 倍上下文,显存线性缩放。
问题
问题背景
大语言模型(LLM)部署面临延迟、成本与私有化约束,因此常通过知识蒸馏(knowledge distillation)将大模型能力迁移到小模型。蒸馏训练的质量与成本成为模型落地的关键瓶颈,业界正寻求更高效的蒸馏方案。
现有方法局限
主流在线蒸馏(online KD)要求教师与学生模型同时驻留 GPU 内存,逐 token 计算教师输出,造成:
- 高内存占用:大型教师模型(数十至数百 GB)挤占训练资源,限制学生模型最大可训练规模。
- 计算冗余:每个训练步都需完整的教师前向传播,即使教师参数冻结,GPU 利用率仍因等待教师计算而降低。
- 词汇暴增的内存瓶颈:标准 KL 散度损失需要具体化
[batch, seq, vocab]的 logit 张量。随着上下文长度增长,该张量导致峰值内存与序列长度成正比,迫使实际训练将上下文截断至较短(如 8K 以下),损害长文本蒸馏效果。
为何此问题重要且困难
蒸馏效率直接影响模型迭代速度与成本:
- 成本高昂:一次完整蒸馏可能耗费数千 GPU 小时,对于经常需要 teacher-student 联合调整的场景(如多语言、多任务蒸馏),开销难以承受。
- 长上下文蒸馏需求:现代 LLM 的应用(如长文档理解、多轮对话)要求学生模型支持长上下文,而现有内存瓶颈导致训练上下文长度受限,与服务时的上下文窗口不匹配,造成质量折损。
- 系统优化需权衡精度:加速方案(如离线缓存或分块计算)易引入近似误差,如何在保证蒸馏损失几乎不变的前提下大幅提升吞吐和显存效率,是兼具理论与工程价值的研究方向。
行业类比
类似移动端 ASR 模型通过离线声学蒸馏不断压缩,若每次蒸馏训练能从数天缩短至数小时,将大幅加速端侧智能助手的上线节奏。
核心洞察
- 离线 Top-K 缓存将知识蒸馏从必须同时驻留师生模型的内存限制中解放出来:仅需一次前向提取并缓存教师 Top-K logits,后续训练完全摆脱教师模型,仍能保持与在线蒸馏几乎一致的损失,且单卡训练吞吐量提升高达 41%。该方法真正解决了大模型蒸馏中教师模型显存占用高、无法适应小规模 GPU 部署的核心痛点。
- 融合分块 KL 损失通过按序列维度分块计算并原地聚合损失,消除了中间全量 logit 张量的物化,使峰值内存线性增长于序列长度,而非词汇表大小。这直接突破了过去因 logit 张量巨大而限制上下文长度的瓶颈,首次让单 GPU 上训练 32K 长上下文的小模型成为可能,对需要长上下文理解的应用场景意义重大。
方法
离线 Top-K Logit 缓存
训练开始前,使用教师模型对全部训练数据执行一次前向传播,将每个 token 位置的 top-K logits(值与词汇索引)缓存到磁盘。训练时直接读取缓存,无需再将教师模型驻留在 GPU 显存中,从而 移除在线教师推理的开销。
融合分块 KL 损失(Fused Chunked KL Loss)
该模块是避免显存爆炸的核心。标准 KL 散度需要同时持有学生和教师的完整 [batch, seq_len, vocab_size] 张量,对大词表(如 128K)会造成严重显存峰值。本方法:
- 沿序列长度维度将 logits 切分为小块(chunk)。
- 对每个 chunk,仅利用教师缓存的 top-K logits 计算 稀疏 KL 散度:学生输出中对应教师 top-K 的 logits 参与 softmax 归一化,其余位置的概率质量由一个常数近似项补偿,保证分布完整性。
- 通过 CUDA kernel 融合(fused)将 softmax、top-K 选取、KL 散度求和在单次 GPU 调用中完成,无需生成完整的
vocab_size中间张量。 - 各 chunk 的损失结果最终平均为标量。
输入→输出流程
- 输入:学生模型在训练 batch 上的 logits 输出;对应的教师 top-K logits 缓存。
- 分块融合计算:对序列进行 chunk 划分,每个 chunk 调用融合 kernel 直接产出一个标量损失贡献。
- 输出:标量损失值,反向传播正常进行。
与同类方法的差异
相比于在线蒸馏(需同时加载教师模型、计算完整 logits)或已有的逐 token 稀疏 KL 损失实现,本方法 结合离线缓存与序列分块融合,将显存占用从 O(vocab_size) 降至 O(seq_len),首次在单 GPU 上实现 32K 以上长上下文的蒸馏训练,且训练吞吐显著提升。
实验
实验设计
论文主要对比了两类蒸馏方案:在线蒸馏 (online KD) 与离线蒸馏 (offline KD)。离线方案预先用教师模型计算训练集中每个样本的 top-K logits 并缓存,随后只使用 student 加载缓存进行训练,完全移除对 teacher 的内存占用。实验在标准的自回归语言模型蒸馏任务上进行(数据集未命名),所有对比均在 单块 H200 GPU 上完成。
随后,作者在离线方案基础上引入融合分块 KL 损失 (fused chunked KL loss),该损失将完整的词汇表大小 logit 张量沿序列长度维度切分为若干个 chunk,逐块计算 KL 散度,从而避免一次性显存整个 logit 矩阵。这允许在相同硬件上将上下文长度从基线(受限于 memory spike)扩展到 32K tokens。此外,构建了一个仅含输出头的 玩具基准,独立评估损失核在 4K 到 256K tokens 下的内存与迭代时间,验证线性内存缩放特性。
关键发现
- 离线 top-K 缓存几乎无损:与在线蒸馏相比,离线 KD 的训练损失曲线几乎完全重合,但每次迭代速度提升约 29%,整体吞吐量最高可提升 41%。
- 分块损失消灭内存尖峰:使用全密集 KL 损失时,峰值内存随序列长度平方增长,严重限制可训练上下文;分块损失将内存增长降为线性,允许在单卡上以 4 倍上下文 训练,且不引入性能下降。
- 缩放特性验证:玩具基准表明,从 4K 到 256K tokens,分块损失内存近乎恒定,迭代时间仅随序列长度线性增加,证明该设计可轻松扩展至超长上下文蒸馏。
与基线的深度对比
基线(在线蒸馏 + 全密集 KL)需要在每一步前向传播教师模型,严重占用显存并降低吞吐;离线 top-K 通过一次性缓存彻底解决这一瓶颈,同时保证了近似相同的优化目标。而分块 KL 损失则进一步解耦了损失计算与词汇表大小的耦合,使得原本不可行的长上下文蒸馏变为现实。与在线方案相比,二者的联合使用在 不牺牲质量 的前提下,将蒸馏效率提升了一个数量级,且内存需求完全可控,为后续大规模消融实验和模型修复 (healing) 扫清了资源障碍。
该方法与其它内存友好型损失(如稀疏 softmax、切片损失)的设计思路不同:它既不依赖近似采样,也不要求特殊的教师输出结构,仅通过精细的 kernel 实现完成精确的 chunk 级 KL 计算,因而更易集成到现有训练框架中。
行业影响
落地场景
该工作直接面向小语言模型(SLM)部署的推理瓶颈,适用于对延迟、成本、本地化部署有严格要求的场景:
- 端侧/边缘设备:手机、IoT 设备上的助手、键盘预测、实时翻译,需在极低内存下运行高质量压缩模型。
- 企业私有化部署:金融、医疗、法律等行业的合规需求,必须将模型部署在本地服务器,知识蒸馏是获得可用 SLM 的主要途径。
- 高吞吐在线服务:电商搜索、内容推荐中的轻量级重排序模型,每天处理亿级请求,训练效率直接决定迭代速度和资源开销。
商业价值
- 降本:离线 top-K 缓存将教师模型移出训练内存,单次迭代速度提升约 29%,整体吞吐提升 41%,大幅降低 GPU 时长和训练成本;分块 KL 损失消除词汇量大小的 logit 张量,单卡即可训练 32K 上下文,减少对多卡并行的依赖。
- 体验提升:允许以更高吞吐做更多超参数消融实验,加速模型迭代,间接提升下游任务质量;长上下文支持使 SLM 能处理对话、文档总结等需要长窗口的场景,不因内存限制牺牲能力。
与现有工作流的接口
该方案可无痛集成到主流训练栈:
- 离线蒸馏只需一次前向生成 top-K logit 缓存,可复用现有 teacher 模型,无需修改架构;缓存格式兼容标准数据加载器,可直接替换在线蒸馏流程。
- 分块 KL 损失作为 PyTorch 自定义算子嵌入损失计算,不改变模型 forward 逻辑,支持
torch.compile优化;项目已开源 Full-Chunked-KL-Loss,可直接集成到 Hugging Face Trainer 或自定义训练脚本。
具体落地用例
- 电商搜索重排序:大型电商平台需用 SLM 对召回商品做实时排序,教师模型如多模态大模型生成的软标签(logits)可离线缓存,学生模型训练时直接读取缓存,单卡即可完成蒸馏,省去教师加载,使每日更新的模型训练成本降低 40% 以上。
- 企业内部知识库问答:金融服务公司需将通用大模型能力压缩到本地可部署的 7B 模型,使用离线 top-K 缓存可避免私有数据暴露给外部教师 API,同时分块 KL 损失支持 32K 上下文窗口,覆盖长文档问答,满足合规与性能双重要求。
局限
- 离线 Top-K 教师缓存策略假设 top-K logits 足够捕获教师分布的关键信息,但极端情况下(如 K 较小或长尾任务中稀有 token 的贡献不可忽略)可能丧失分布细节,从而影响学生模型的校准能力与输出多样性。论文仅在固定 K 值和有限模型规模上验证了训练损失与在线蒸馏接近,未系统考察不同 K 对下游任务性能的影响。
- 融合分块 KL 损失通过避免物化完整词表 logits 显著降低内存峰值,但其实现引入了额外的分块计算与归约逻辑,可能增加 kernel 启动开销和实现复杂度,且当前仅通过输出头 toy benchmark 验证了内存和迭代速度的扩展性,未在完整蒸馏训练中细致对比与全量 KL 损失的数值稳定性或收敛速度的差异。
- 实验主要基于单张 H200 GPU 场景,未探讨多 GPU 分布式训练下的适应性(例如结合模型并行或序列并行时 chunked loss 的兼容性);同时上下文扩展至 32K tokens 的结论来自单个 GPU,在更大规模(如 128K+)或不同硬件(如 A100、AMD GPU)上的泛化能力尚不明确。此外与混合精度训练、梯度检查点等常用内存优化技术的耦合效果也缺少讨论。