Lossless Tensor Compression as Program Synthesis
模型检查点在数量和体积上持续增长,给存档、传输和部署带来日益高昂的成本。通用压缩器虽能降低存储需求,却忽略了张量结构;而现有张量专用压缩器依赖固定且格式特定的流水线。我们提出 Brevis,将无损张量压缩建模为程序合成问题。 Brevis 设计了一个类型化领域专用语言(DSL),通过一组可逆算子捕获反复出现的张量结构,如重复区域和浮点字段。给定一个张量,Brevis 合成一个自包含的 DSL 程序,可逐位精确重建原数据。从少量代表性张量样本中学习到的检查点特定生产先验,引导有界 A 搜索合成紧凑程序,之后可直接执行该程序进行逐位精确解压缩。 在涵盖语言、音频和图像生成模型的 10 个公开检查点上,Brevis 将 2.13 TB 检查点数据压缩至 1.41 TB,实现 33.93% 的存储缩减。与 zstd、gzip 等四种通用压缩器相比,其生成的存档体积最多小 30.87% ;同时优于张量专用压缩器 ZipNN 和 DFloat11。在实际并发配置下,Brevis 达到 3.60 GB/s 压缩和 6.61 GB/s 解压缩速度,并保留每一个源字节。
论文精读
TL;DR Brevis 将无损张量压缩视为程序合成,通过领域特定语言与搜索,自合成可逆程序实现比特精确压缩,以 33.93% 的空间节省超越通用与专用压缩器,同时保持高速读写。
问题
问题背景
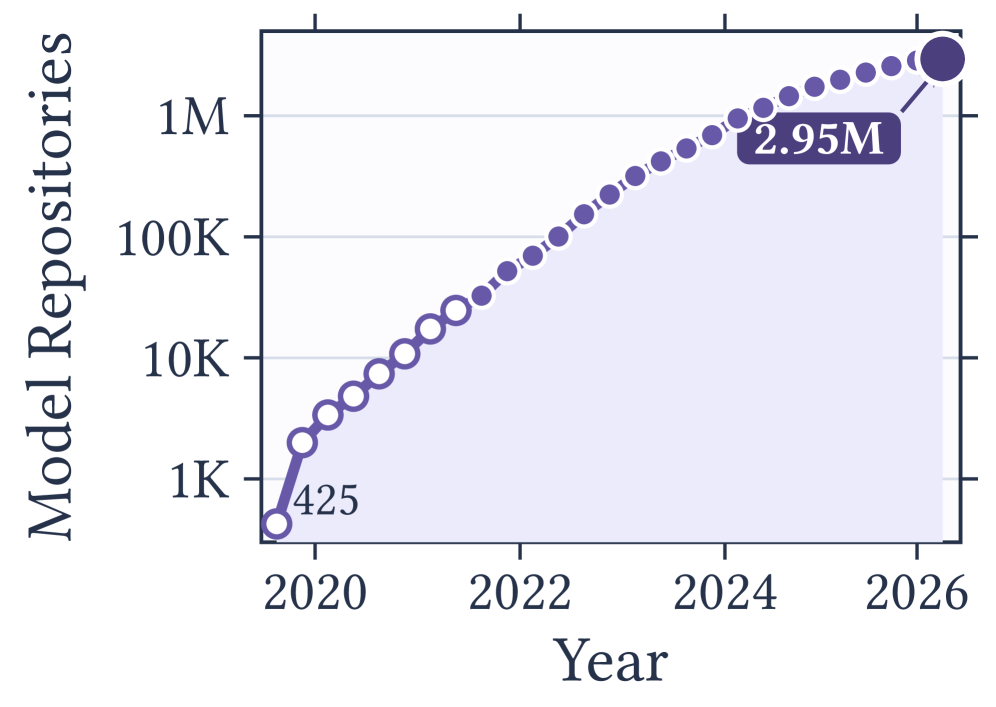
随着大语言模型、扩散模型等大规模神经网络的普及,模型检查点(checkpoint)的规模与数量急剧增长。存储、传输与部署这些检查点的成本日益成为工程瓶颈,无损压缩成为缓解压力的关键技术。
现有方法的局限
- 通用压缩器(如
gzip、zstd)以字节流为处理对象,完全忽略张量内部的数据结构(如维度、类型、重复模式),导致对高冗余张量的压缩率不理想。 - 张量专用压缩器(如
ZipNN、DFloat11)虽然利用了张量格式信息,但通常固化为特定的处理流水线(例如,仅针对浮点数分布或固定分块策略),缺乏对多样化张量模式的适应性。面对不同模型架构中张量的复杂结构(如重复区域、稀疏片断、特定的浮点布局),这些固定流水线无法自动发现并利用最高效的压缩策略。
技术挑战与重要性
张量数据本身蕴含丰富的内部结构——例如,大量重复的权重块、梯度模式、浮点数的特殊分布——但这些结构的表达方式高度异构,难以被人工设计的固定规则覆盖。无损压缩要求逐比特精确还原,任何信息损失都可能导致模型行为退化,这进一步限制了有损方法的可用性。因此,自动化地从张量中提取可复用模式、生成极致压缩的程序,既具备极高的技术难度,又能直接降低大规模模型在存储、分发、迭代中的基础设施开销,对 AI 工程实践具有显著价值。
论文原文指出:“General-purpose compressors can reduce storage requirements but ignore tensor structure, whereas existing tensor-specific compressors rely on fixed and format-specific pipelines.” 这精准概括了突破静态流水线、引入程序合成范式的动因。
行业类比
可以将 Brevis 的压缩过程类比为基于程序的数据抽象——类似于 JIT 编译器动态生成优化代码,Brevis 为每个张量合成一段专用“解压程序”,以代码长度换数据空间。在模型分发(例如将大模型检查点快速同步到边缘节点)或增量训练(快速归档与恢复检查点)等场景中,这种范式能大幅降低带宽占用与延迟。
核心洞察
- **将无损张量压缩重新定义为程序合成问题**,利用可逆操作符捕捉重复区域、浮点场等张量内部结构,从而生成自包含的 DSL 程序来精确重建原始张量。这与传统压缩器(如 zstd、gzip)忽略张量结构、以及现有张量专用压缩器(如 ZipNN、DFloat11)依赖固定格式管道的方法截然不同,开辟了一种灵活、可解释的压缩新范式。
- **引入 checkpoint 特定的产生式先验引导有界 A* 搜索**,从少量代表性张量中学习到的先验能够显著缩小搜索空间,使合成过程既可处理又能针对特定模型优化。这解释了为什么 Brevis 能够在保持无损的前提下,比通用压缩器节省高达 30.87% 的存储空间,并在吞吐量上仍达到 3.60 GB/s 的压缩和 6.61 GB/s 的解压速度,实现了压缩率与效率的实用平衡。
方法
输入与问题抽象
Brevis 将无损张量压缩看作程序合成问题:给定一个张量(如模型 checkpoint 中的权重矩阵),目标是自动生成一段紧凑的 DSL 程序,该程序可逐比特精确重建原始张量。输入是单个张量的原始字节序列,输出是自包含的 DSL 程序,执行即解压。
关键模块:类型化 DSL 与合成搜索
核心创新是一套类型化的领域特定语言(typed DSL),包含一组可逆操作符(如 repeat、pack_bits、transpose),这些操作符能表达张量内部的重复区域、浮点字段模式等结构。每个操作符都保证“执行后可通过逆操作无失真还原”,从而确保无损性。
合成过程采用目标导向的有界 A 搜索*:
- 目标导向扩展:从目标张量出发,逆向应用可逆操作符,逐步约简为更简单的表示。
- 检查点特定的生产先验:从同一模型或同类 checkpoint 的少量张量样本中学习操作符的概率分布,指导搜索偏向常见的压缩模式,显著加速合成并提升压缩率。
- 有界搜索:限制搜索深度与分支,平衡压缩效率与合成时间。
搜索结束后,得到的 DSL 程序即为压缩产物。该程序在解压时直接执行,无需额外的解码器依赖。
输出与归档格式
最终压缩存档包含合成得到的 DSL 程序(文本或紧凑编码形式),解压时由轻量解释器执行,逐操作重建张量,保证比特级精确重建。
与同类方法的差异
与 zstd、gzip 等通用压缩工具相比,Brevis 利用张量内部结构减少冗余;与 ZipNN、DFloat11 等张量专用压缩器依赖固定流水线不同,Brevis 通过程序合成动态适配不同张量的模式,无需为每种格式设计手工压缩方案,在多个模型 checkpoint 上取得了更高的压缩率。
实验
实验设计
Brevis 在 10 个公开检查点 上评估,覆盖语言、音频和图像生成模型,对比的基线包括四款通用压缩器(如 zstd、gzip)及两种张量专用压缩器(ZipNN、DFloat11)。评估维度为压缩率(存储缩减比例)与吞吐量(压缩/解压速度),所有实验在实用并发配置下测量,确保结果反映真实部署性能。压缩过程通过有界 A* 搜索合成 DSL 程序,搜索由从少量代表性张量中学习到的产生先验引导,最后输出自包含、可比特精确重建的归档格式。
关键发现
- 存储缩减显著:2.13 TB 原始数据压缩至 1.41 TB,整体缩减 33.93% ,且 archive 体积比通用压缩器最优结果还小 30.87% ,说明 DSL 捕获的重复区域与浮点字段等结构有效提升了压缩率。
- 超越专用压缩器:Brevis 产生的归档均小于 ZipNN 和 DFloat11,证明了程序合成范式比固定管道更能挖掘张量内部冗余。
- 吞吐量实用:压缩速度达 3.60 GB/s,解压 6.61 GB/s,在保持无损与高压缩率的同时,满足模型快速存储与部署需求。
基线对比解读
与通用压缩器相比,Brevis 的核心优势在于感知张量结构——它不是把张量当字节流处理,而是通过类型化 DSL 显式建模重复模式;这与 ZipNN、DFloat11 等专用压缩器也不同,后者依赖特定格式(如浮点数位宽缩减),而 Brevis 的程序合成可动态发现任意结构。然而,该方法依赖小样本学习的产生先验,面对全新架构时可能需要更新先验,实际部署中需权衡先验泛化性与合成搜索开销。其 A* 搜索的并发吞吐量表现良好,为模型检查点管理提供了一种灵活、高效的无损压缩方案。
行业影响
落地场景
Brevis 通过程序合成实现无损张量压缩,适用于大规模模型检查点(checkpoint)的存储与传输。典型的落地场景包括:
- 模型注册中心与制品库:例如 Hugging Face、企业内部模型仓库,需要长期归档海量检查点,深度压缩可节省存储成本。
- 跨区域/跨云模型分发:在边缘-云协同、联邦学习中,频繁传输完整权重,压缩可显著降低带宽占用。
- 版本化实验管理:MLOps 平台(如 MLflow、Kubeflow)保留每次实验的检查点,自动压缩可缓解存储膨胀。
- 自动部署与 CI/CD 管线:将压缩后的模型工件直接注入推理服务,解压速度需与部署延迟平衡。
商业价值
核心商业价值在于存储成本优化和传输效率提升。Brevis 在 2.13 TB 检查点数据上取得 33.93% 的空间节省,优于 zstd、gzip 等通用压缩器,也优于 ZipNN、DFloat11 等专用方案。这直接转化为云存储和网络带宽的支出下降。相比于现有固定流程的张量压缩器,Brevis 自动合成压缩程序,无需手动为不同模型架构设计处理管线,降低维护开销。3.60 GB/s 压缩和 6.61 GB/s 解压的吞吐能力(在并发配置下)保证了生产环境下的低延迟需求,不会成为训练或部署流水线的瓶颈。
与现有产品/工作流的接口
Brevis 输出自包含的 DSL 程序,解码时无需外部依赖,可轻易嵌入现有工具体系:
- 序列化与反序列化钩子:在 PyTorch
save/load或 TensorFlowSavedModel存档前后,插入 Brevis 压缩/解压步骤。 - Opaque binary 接口:将压缩后的字节流与格式无关地存入对象存储(如 S3),读取时通过 Brevis 解压后重建张量。
- 插件式集成:有望成为类似张量压缩领域的 LLVM 中间层,将不同格式的张量数据转换为紧凑的程序表示,再由 Python / C++ 运行时执行。
具体落地用例
1. 全球电商平台的推荐模型更新
大型电商的推荐系统每晚训练新模型,产生数百个检查点,需分发给几十个区域的推理集群。使用 Brevis 压缩后,分发时间缩短 30% 以上,且无需改变现有的模型服务框架(如 Triton Inference Server);解压步骤可在模型加载时通过自定义 model.py 完成。
2. 自动驾驶感知模型的多团队协作
感知模型(如多模态 Transformer)每轮迭代产生多份检查点,上传至内部模型中心供仿真和评测团队拉取。通过 Brevis 压缩存储成本降低约三分之一,同时解压延迟完全满足离线评测流程,团队无需额外调整 CI 脚本。
局限
- **检查点特定先验依赖** :Brevis 需要从少量代表性张量中学习一个检查点特定的生成先验,以引导 A* 搜索。对不同模型或同一模型的不同架构变体,可能需要重新采样和训练先验,这会增加部署成本。如果新模型的张量结构模式与样本集差异较大,先验质量下降可能直接影响合成程序的紧凑性,进而降低压缩率。论文未量化先验训练的时间开销及对整体压缩吞吐量的影响,也未讨论先验的迁移或复用策略。
- **搜索效率与可扩展性** :尽管使用了有界 A* 搜索,随着单张量规模增大(例如千亿参数模型的 embedding 层),DSL 表达空间可能极度膨胀,搜索时间和内存消耗会显著增加。实验中的压缩吞吐量 3.60 GB/s 是在特定并发配置下测得,在资源受限或单线程场景中可能有明显下降。论文未提供搜索失败或超时的处理机制,也未分析极端情况下的压缩时延尾部分布。
- **评估范围有限** :实验仅基于 10 个公开检查点,涵盖语言、音频和图像生成模型,但缺少对推荐系统、图神经网络等结构差异较大的模型的覆盖,也未包含百亿以上参数的超大模型。对比的张量特定压缩器仅 ZipNN 和 DFloat11,未纳入其他可能的无损张量压缩方法(如单位无关压缩、块排序压缩)或针对模型检查点的专用工具,使得实验结论的普适性有待进一步验证。