SKT: 通过验证的合成数据生成进行大规模技能使用训练
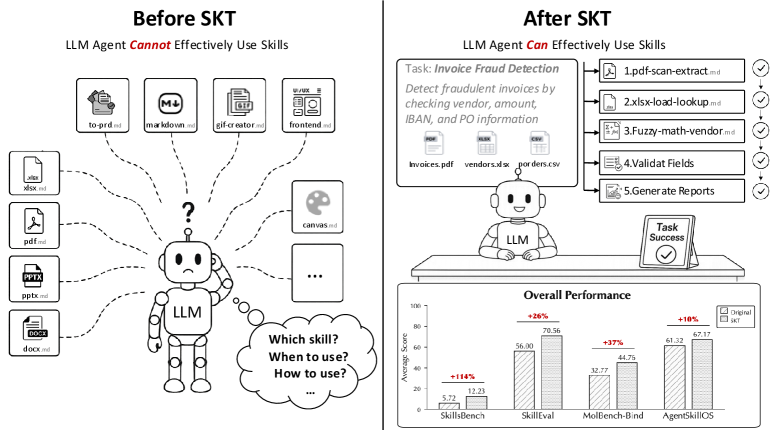
Agent 技能已成为装备语言模型代理可重用程序性知识的重要机制。然而,仅提供技能并不能保证当前模型能有效识别、应用和协调它们。为此,我们引入 SKT,一个验证的数据合成流水线,从大量代理技能中构建基于技能的任务和可执行轨迹。 SKT 选择合适的单技能和多技能配置,通过基于规则和基于代理的验证以及反馈引导修复来合成任务,并仅保留成功且充分使用每项所需技能的轨迹。使用 2,000 个公共技能,SKT 生成 4,000 个任务包和 27,164 条验证轨迹。基于相同流水线和不相交的测试池,我们进一步构建 SkillEval,一个用于评估技能使用的保留可执行基准。 跨多种模型、基准和代理框架的实验表明,在 SKT 生成的轨迹上进行监督微调能持续提升技能使用性能。验证消融、跨框架评估和扩展实验进一步表明,这些收益依赖于高质量监督,可扩展到单一代理接口之外,并随着技能覆盖范围扩大而增加。总之,这些结果确立了验证数据合成作为技能使用训练的有效且可扩展的方法。
论文精读
TL;DR SKT 提出可扩展验证合成管道,从 2000 个技能自动生成 2.7 万条高质量使用轨迹,监督微调后模型技能使用能力显著提升。
问题
问题背景
AI 智能体研究正从单步对话转向多步可复用技能(Agent Skills) 的执行。社区致力于构建包含大量可调用技能的工具生态,让 LLM 驱动的智能体像调用 API 一样组合行为。
现有方法局限
当前主流做法是直接将技能描述(如函数签名、文档)注入模型提示,但存在三重局限:
- 技能选择肤浅:模型倾向于选择与查询表面相关的技能,而非任务真实所需,尤其当技能超过数十个时,出现“选择过载”;
- 组合协调脆弱:现有合成数据生成多为单步或少步验证,多技能组合时缺乏对必要技能是否被充分使用的保证,模型常遗漏关键中间技能或产生幻觉调用;
- 训练数据噪声:大规模合成轨迹常因验证不足而混入失败案例,直接用于监督微调会固化错误行为模式,负向影响泛化。
为什么这个问题难且重要
技能使用本质上要求模型具备任务分解 + 技能路由 + 依序执行的复合能力,且不同技能之间的隐式状态依赖需被正确传递。业界正追求能自主操作工具、浏览器、API 的“通用智能体”,若技能调用不可靠,整个系统将不可用。该问题的解决直接影响:
- 智能体落地的可靠性:多步任务的成功率从单技能的高成功率急剧下降为复合技能的级联失败;
- 可扩展性:技能生态膨胀后,如何低成本生成高质量多样化训练信号是瓶颈。
行业类比
这类似于微服务编排:容器平台提供了大量独立服务,但若服务网格无法正确路由请求、处理依赖与回滚,应用仍会崩溃。同样,AI 智能体需要学会何时调用 web_search、如何在 file_edit 后串联 code_interpreter,而不是把它们当作孤立的工具。
核心洞察
- 高质量监督信号源于验证驱动的合成数据生成。SKT 通过基于规则和代理的双重验证与反馈引导修复,确保每条训练轨迹不仅任务可执行,且确实充分利用了指定技能。这区别于简单的自我对弈或未验证的轨迹合成,直接提升了数据的信噪比,使微调收益稳定且显著。
- 技能使用的规模化训练依赖于自动化的多技能任务合成。SKT 从 2000 个公开技能中自动选择并组合单/多技能配置,生成覆盖广泛技能组合的任务包。相比依赖人工编排或少量技能的以往工作,该方法以低成本实现了技能覆盖面的横向扩展,且实验证实性能随技能池增大而持续提升,展现出很强的工程可扩展性。
方法
方法总览
SKT 是一个验证式合成数据管道,目标是从大规模 Agent 技能集合中生成高质量、可执行的训练数据,以提升模型识别、调用及协调多个技能的能力。
输入:一组公开的 Agent Skill(如函数、API 定义),共计 2000 个。每个技能封装了一段可复用的过程性知识,供语言模型代理调用。
关键模块
管道分为三个阶段:
Stage I: Skill Curation(技能策展)
从技能池中筛选适合组合的单个技能与多技能搭配。选择策略确保后续任务能充分覆盖不同技能基数(cardinality),避免训练偏差。Stage II: Task Synthesis(任务合成)
- 模板驱动创作:基于选定的技能组合,自动生成任务描述、预期输入输出等元信息。
- 双重验证:依次通过基于规则的验具(
rule-based verifier)和基于智能体的验具(agent-based verifier)对生成的任务进行校验,检查语义合理性、技能依赖完整性等。 - 反馈引导修复(
feedback-guided repair):若验证失败,系统根据失败信号自动修改任务,循环迭代直至通过或达到最大修复次数。 - 难度控制:通过规则和 Agent 反馈调节任务复杂度,保证数据多样性。
Stage III: Trajectory Synthesis(轨迹合成)
为每个合格任务规划并执行一条 Agent 轨迹,要求轨迹中每一步的调用都确切使用了所需技能。轨迹同样经过验证,仅保留完全成功且实质性使用所有必要技能的轨迹。
输出
- 4000 个任务包(task packages),每个包含任务定义、技能配置及一条或多条已验证轨迹。
- 总计 27,164 条高质量轨迹,用于监督微调(SFT)。
- 基于相同管道与一个不相交的任务池,额外构建了 SkillEval 可执行基准,用于评估模型技能使用能力。
训练
将轨迹序列化为 (提示, 响应) 对,直接对基础 LLM 进行监督微调,不依赖额外奖励模型或 RL 阶段,大幅简化训练流程。
与同类方法的差异 相比仅靠提示工程或人工标注,SKT 通过双重验证 + 自动修复的闭环,首次在技能使用场景中实现可扩展、可验证的全自动数据合成,确保每一条轨迹都经过严格一致性过滤。
实验
实验设计
基于 2,000 个公开的 Agent Skills,使用 SKT 流水线通过规则与 Agent 双重验证合成 4,000 个任务包及 27,164 条成功轨迹,并预留不相交的任务池构建 SkillEval 评测基准。在多种模型上对合成轨迹进行监督微调,在多个主流 Agent harness 与 benchmark 上评估,覆盖零样本基线、消融、跨 harness 迁移、混合训练及技能规模扩展。
关键发现
- 验证数据决定性能:仅使用验证通过的轨迹微调可一致提升技能使用能力;若移除验证阶段,性能显著下降,说明高质量监督信号是关键。
- 跨接口泛化:在单一 harness 上微调的模型能迁移至其他 harness,且混合 harness 训练进一步增强了通用性,证实所学技能使用策略并非过拟合于特定接口。
- 可扩展性:随着技能覆盖范围扩大,性能持续增长,表明该合成范式能够规模化地丰富 Agent 的行为空间。
- 多技能协调:在多技能任务中,微调后的模型能有效识别并按需组合多个技能,体现了 SKT 对复杂指令跟随的增益。
与基线对比
相较于零样本基线,SKT 微调带来了显著的性能跃升。更关键的是,与使用未经验证的合成数据相比,SKT 的验证修复机制是增益的来源;单纯增加未验证数据量效果有限。这印证了在 Agent 数据合成中,自动化质量门控比数据数量更重要。
工程启示:该流水线可低成本复现,但需注意技能库的多样性与覆盖面,以及验证器的可靠性设计;在实际部署中,动态扩展技能库并持续生成验证轨迹,有望实现 Agent 能力的可持续进化。
行业影响
落地场景
- 智能客服与流程自动化:电商、金融等行业的客服机器人需要处理多步骤任务(如退货退款、贷款审批),涉及查询、计算、调用外部API等多个技能,SKT合成数据可用于微调模型,提升技能识别、调度和协调能力。
- 企业级智能助手:在CRM、ERP系统中,智能体需根据自然语言指令自动执行一系列操作(如生成报表、发送邮件、更新数据库),SKT能生成覆盖各类技能组合的训练轨迹,增强助手处理复杂业务流程的能力。
- 内容审核与创作平台:内容平台的自动审核流程需要调用文本分类、图像识别、违规标注等技能,多技能协同使用可提高审核效率和准确性。
商业价值
- 降本增效:减少人工介入,自动化执行长尾复杂任务,降低运营成本。通过高质量合成数据训练,模型一次训练多轮迭代,减少实际业务场景中的试错成本。
- 体验提升:提高任务成功率,缩短响应时间,提升用户满意度。尤其在多技能协同场景,避免因技能调用失败导致的死循环或错误输出。
- 可扩展性:SKT流水线可随技能库增长自动生成新训练数据,降低数据标注和维护成本,支撑业务快速变化。
与现有产品/工作流的集成
- 可集成到 LLM应用框架 (如LangChain、AutoGen)的工具调用层,将SKT生成的训练数据用于微调底座模型或作为few-shot示例注入提示词,提升工具选择准确性。
- 配合 RAG系统,技能可作为检索到的知识单元,SKT训练使模型更善于利用这些技能解决实际问题。
- 作为 模型训练数据合成工具,可直接嵌入MLOps流水线,在更新技能库后自动化生成验证过的训练集,持续优化部署的智能体模型。
具体用例:某电商平台在退货流程中,需要依次调用“查询订单”、“计算退款金额”、“创建退货单”、“发送邮件通知”四个技能。原模型在多技能协调时成功率仅60%,经SKT合成轨迹微调后提升至85%,显著降低人工客服转接率。金融领域,信贷审批智能体需调用征信查询、风险评分、额度计算等技能,SKT合成数据帮助模型学会严格的顺序控制和异常处理,减少审批错误。
局限
- 合成数据依赖于已有的 2000 个公共技能集,且任务生成与验证主要基于规则和代理模型,这可能导致所覆盖的任务分布与真实世界场景存在偏差,对未见技能组合或长尾协调任务的泛化能力受限。代理验证本身引入的计算开销和潜在偏差也可能使生成的轨迹虽可执行但并非最优或符合人类偏好。
- 轨迹验证和反馈修复过程的成功率与多样性受限于验证器的能力上限,可能只收敛到局部可行解,而无法探索更丰富的任务空间。验证轨迹共 27,164 条,数据规模相对较小,无法与大规模通用指令微调可比,可能限制技能使用能力在更广泛模型和能力范围上的提升。
- 实验主要在特定代理框架和模型上进行,虽然展示了跨框架迁移效果,但缺乏在真实世界复杂多步任务或开放域部署中的鲁棒性评估,无法确认模型在真实场景中面对噪声、动态变化和长程依赖时技能使用的实际稳定性。