SwanTale: 统一多说话人语音与音频生成, 面向指令与零样本任务
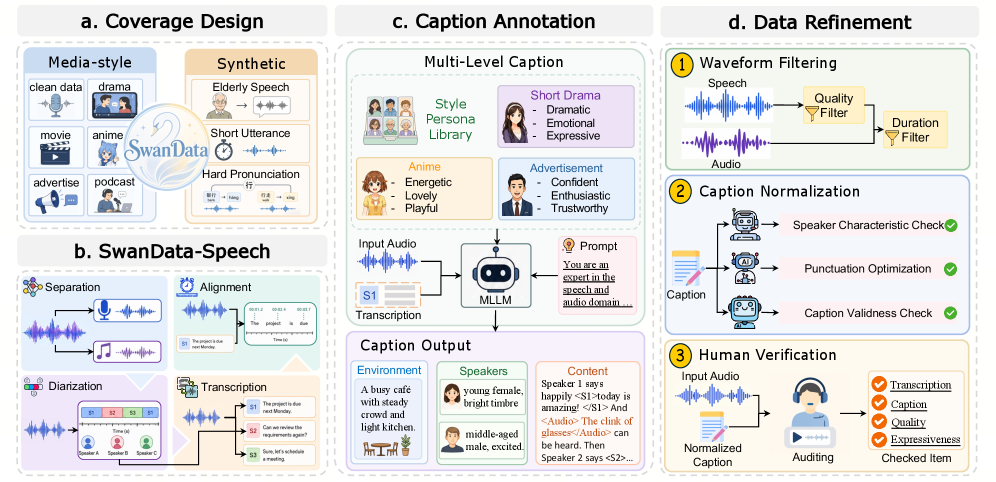
在动画配音、广播剧、电影、广告、游戏、播客和短视频制作中,常需要生成语音和音频。创作者可能需要设计无参考录音的声音、用自然语言控制说话人风格、支持带环境和音效的声学场景,并复用所设计的声音。因此,指令任务(根据环境、说话人风格和细粒度内容描述生成)与零样本任务(基于参考音频和相同细粒度内容生成)都至关重要。 为应对上述挑战,我们从数据和模型两侧入手。首先提出 SwanData-Caption,用于清洗原始语音/音频数据、添加针对性合成覆盖,并标注多样且准确的多级描述。随后提出 SwanTale,一个支持零样本与指令任务的多说话人表现力语音与音频生成模型。其中,SwanVAE 支持高质量多音频模态生成;奖励条件质量控制和 Engram conditioning 结合 统一 MoE 实现多任务、多音频模态建模;此外,课程学习与 GRPO 后训练 让模型逐步增强能力。 实验表明,SwanTale 在多个关键零样本与指令指标上领先,在两个任务上取得最佳表现力分数,并能支持涉及多说话人语音与音频的复杂指令生成。演示见 https://swanaigc.github.io/swantale。
论文精读
TL;DR SwanTale 通过多模态 VAE、统一 MoE 与 GRPO 后训练,统一指令与零样本多说话人语音及音频生成,在表现力指标上达到最优。
问题
问题背景
当前语音与音频生成领域正从单一 TTS 功能向多说话人、多音频模态、可控生成的统一范式演进,创作者需要一套工具,既能根据自然语言描述设计声音,又能基于一条参考音频进行零样本克隆,并支持重用已设计的声线。
现有方法局限
- 任务割裂:多数系统只为 zero-shot TTS 或简单 instruct 生成 分别设计,缺乏能同时处理两种任务的统一架构,导致流程断裂。
- 数据标注粗糙:公开数据集仅提供讲话人 ID 或简短文本,缺少对 环境音、情感风格、音频效果 的细粒度多层描述,限制了模型对复杂指令的理解。
- 音频模态割裂:传统 VAE 难以高质量重建语音、音乐、环境音等多种异构音频,导致多模态生成时细节损失严重。
- 训练策略欠优化:大多采用单一目标从头训练,未引入 课程学习(从简到难)或 基于人类偏好的强化学习(如 GRPO),使模型难以渐进掌握复杂生成技能。
为什么这个问题难/重要
- 技术挑战:音频生成需要解耦 说话人音色、韵律、环境混响、事件音效 等高维纠缠维度,而自然语言指令又具有模糊性和组合性,要求模型在语义空间中精准映射并保持跨模态一致性。
- 重要性:工业界(动画、游戏、广告、播客)亟需一个模型覆盖从“创意设计(instruct)”到“零样本复用(zero-shot)”的全流程,以大幅降低声音制作成本与周期。模型若能在 表达力(expressiveness)、声音复用性 和 环境建模 上取得突破,将直接催生新一代音频内容生产工具。
行业类比
类似 Stable Diffusion 将文本到图像生成推入实用阶段,统一的语音-音频生成模型有望成为视频制作、交互式娱乐等应用的底层引擎,让复杂音频创作像写 prompt 一样简单。
核心洞察
- SwanTale 通过 **Unified MoE** 和 **课程学习** 实现了语音、音频多模态与零样本、指令多任务的统一生成,这是目前较少有工作系统性解决的工程难题。与以往将零样本 TTS 与音频生成独立建模的方案不同,SwanTale 将两者视为同一框架下的不同条件组合,利用 MoE 路由机制动态分配模态与任务专长,既避免了参数膨胀,又缓解了模态冲突,为实际产品中灵活切换使用方式提供了可行路径。
- **SwanData-Caption** 数据管线并非简单混合已有语料,而是针对指令任务设计了 **多层次字幕标注**,并引入**合成覆盖**来填补真实数据缺失的场景(如特定环境音、说话风格)。这直接支撑了模型对复杂指令的理解,使得 SwanTale 在指令跟随和可控性上相比仅依赖零样本的基线有质的提升,启示了高质量合成数据在生成模型中的杠杆作用。
方法
SwanTale 的生成流程覆盖 指令(instruct) 与 零样本(zero-shot) 两种输入模式:指令任务接收自然语言 caption,描述环境、说话人风格与细粒度内容;零样本任务则额外提供参考音频。模型首先通过 SwanVAE 将任意音频(语音、环境声、音效)压缩到统一连续潜在空间。SwanVAE 采用编解码架构,训练时结合重建损失与对抗损失,并通过潜在对齐目标(如跨模态对比学习)确保不同音频类型的表示兼容。
在潜在空间之上,Flow-based Transformer 执行从噪声到潜在变量的扩散或流匹配过程。条件信号包括:
- 文本条件:来自指令或转录的语义 embedding;
- Engram conditioning:从参考音频提取的说话人音色“记忆”嵌入,用于零样本音色克隆;
- 奖励条件质量控制:在训练时将音频质量评分(如 MOS)作为可调 token,使模型学会生成不同质量档次的音频,并在推理时定向提升质量。
模型采用 Unified Mixture of Experts(MoE) 架构,将多任务(instruct / zero-shot)与多音频模态(语音 / 环境声)的建模共享同一个 Transformer 主干,通过门控网络动态路由至不同专家子网,实现参数高效的多能力联合。训练采用课程学习:先学习简单短音频生成,逐步过渡到复杂多说话人、长序列带环境声的指令生成。之后进行 GRPO 后训练(一种基于群组相对策略优化的强化学习方法),利用奖励模型对生成样本的表现力、一致性等打分,进一步对齐人类偏好。
推理时,支持从文本指令直接生成完整音频,或结合参考音频进行零样本克隆,输出包含多说话人对话、环境背景声的高表现力音频。相比以往仅专注单一任务的模型,SwanTale 在统一框架下同时实现 instruct 与 zero-shot 生成,并能处理语音与环境声的复杂组合,是多模态音频生成向实际创作场景靠拢的关键一步。
实验
实验设计
SwanTale 围绕 零样本 与 指令控制 两类生成任务展开,评估涵盖 SwanVAE 的重建质量、多模态编码能力,以及整体模型在语音自然度、说话人相似度、表达性等维度的表现。实验采用自建数据集 SwanData-Caption,并对比当前主流的零样本 TTS 与音频生成基线(具体基线名称未在摘要中列出)。
关键发现
- 零样本与指令任务双领先:SwanTale 在多项关键指标上超过对比基线,尤其在 表达性评分 上达到当前最优。
- 复杂多说话人指令生成:模型能准确理解包含环境音、说话风格与多角色内容的描述,合成相应多模态音频,展现出强大的约束遵循能力。
- SwanVAE 高质量多模态重建:潜变量对齐与对抗训练策略保障了语音、环境声等不同模态的精细重建,为上层流式 Transformer 提供可靠输入。
与基线对比的深度解读
SwanTale 的关键突破在于 统一多任务、多模态建模框架。相比仅支持单任务或依赖固定音色库的方案,其 Unified MoE 与 Reword-conditioned 质量控制使模型兼具零样本音色复刻和细粒度指令生成能力。实验表明,GRPO 后训练与课程学习策略有效缓解了多任务间的干扰,提升了整体表达的拟人度。这为工业化场景中同时需要“声音克隆”和“声音设计”的应用提供了单一模型基座,显著降低部署复杂度。
行业影响
落地场景
SwanTale 统一的 instruct 与 zero-shot 语音/音频生成能力可直接嵌入内容生产流水线。典型应用包括:
- 短视频与直播平台:创作者通过自然语言描述环境声、说话人风格与台词,一键生成多角色对话配音及背景音效。
- 游戏与虚拟人:为 NPC 批量生成符合人设的语音,支持零样本声线克隆以复用已签约声优的声音,或通过文本指令创建全新音色。
- 有声书与播客:根据剧情自动切换多角色旁白与对白,减少人工录制成本。
- 广告与影视后期:快速制作多语言、多风格配音小样,加速创意迭代。
商业价值
- 降本增效:替代部分人工配音环节,将语音制作周期从天级压缩到分钟级,并减少专业录音棚与声优调度成本。
- 体验升级:提供高度可控、情感丰富的语音生成,使内容更具沉浸感;instruct 模式降低非专业用户的创作门槛,扩大创作者生态。
- 增收机会:对平台而言,更丰富的音频创作工具可提升用户留存与内容供给量,进而带动广告或订阅收入。
与现有产品/工作流的接口
模型可封装为 HTTP/gRPC API 或 端侧 SDK,融入现有内容工具链:
- 输入接口:文本提示(instruct)或参考音频+文本(zero-shot),支持 JSON 定义多说话人片段及环境声。
- 输出:高保真多声道音频文件或流式音频 buffer。
- 与现有工具集成:作为 Adobe Premiere / DaVinci Resolve 插件、Unity / Unreal 引擎扩展,或通过 REST API 接入短视频剪辑中台。
- 质量保障:内置 reward-conditioned 质量控制和 SwanVerifier 评估模块,可在推理时筛选生成结果,确保线上服务的稳定性。
具体落地 use case:
- 全球短视频平台:创作者输入“咖啡馆背景中,女声兴奋地念出台词,伴有杯碟碰撞声”,系统调用 SwanTale API 同时生成背景音与人物语音,直接对齐视频轨道,无需后期混音。
- 游戏开发商:策划人员用短参考音频克隆某配音演员的音色,再通过 instruct 指定“愤怒的老巫师”风格,批量生成技能语音与剧情对话,引擎侧通过 SDK 实时合成,大幅缩短音频资产生产周期。
局限
- **数据依赖与泛化性**:虽然 SwanTale 依靠 SwanData-Caption 数据集实现高质量生成,但模型性能高度依赖大规模、精细标注的多模态语音-音频数据。对于未覆盖的声学场景或极端声音效果(如复杂音频特效),instruct 生成可能出现失真或语义不符。数据清理和合成覆盖虽增加多样性,仍可能引入采样偏差,限制在真实世界中开放域场景的泛化性。论文未提供跨域零样本评估,泛化潜力有待验证。
- **计算复杂性与推理效率**:SwanTale 集成了 SwanVAE、Unified MoE、GRPO 后训练等多个组件,模型参数量大且结构复杂。论文未报告推理延迟、显存占用或实时率等效率指标,对于需要低延迟的流式生成或边缘部署场景存在明显挑战。GRPO 后训练可能强化特定能力,却也可能增加推理计算开销,平衡质量与效率是未来待解决的问题。
- **零样本上限受限于参考音频质量**:零样本任务依赖参考音频,当参考音频含噪声、混响或短时不充分时,生成质量(说话人相似度、表现力)会显著下降。与专门优化零样本 TTS 的模型(如 VALL-E 2、Voicebox)相比,SwanTale 虽支持更宽泛的音频模态,但在精细说话人风格保持上可能并非最优。多说话人场景中跨说话人的身份混淆仍是常见挑战。