LongHorizon-Harness:推进面向真实世界任务的长时程智能体
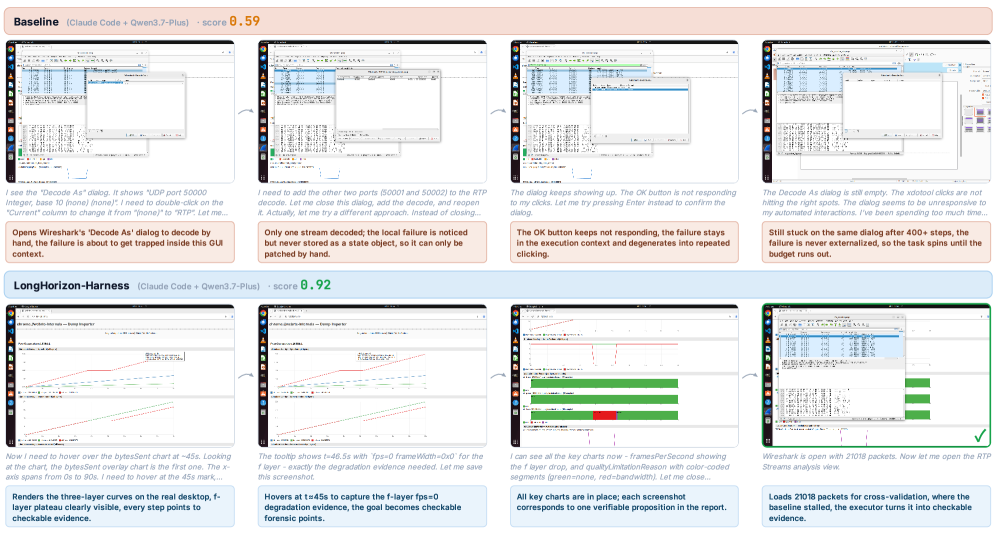
大语言模型(LLM)智能体日益承担长时程任务,这些任务需要跨多个相互依赖步骤的持续推理、工具使用和修正。然而,现有智能体框架将任务执行、任务状态和完成评估一并保存在不断增长的上下文中,导致状态难以追踪,并可能让错误的自我评估影响后续决策。 我们将长时程执行重构为任务状态管理问题,并提出 LongHorizon-Harness。该框架将任务状态显式地维护在执行过程之外,仅用从环境中独立验证的事实来更新。其 Manage-Execute-Audit(MEA)循环 包含:一个管理器用于维护任务状态并决定下一个子任务,一个全新上下文的执行器负责执行,以及一个只读审计器在下一轮前验证环境状态。轻量级的 AgentAdapter 支持在不修改原生智能体循环的情况下,灵活切换模型与框架后端。 实验表明,LongHorizon-Harness 将 Qwen3.7-Plus 在 WeaveBench 上的准确率从 51.8% 提升到 80.7%,在 Terminal-Bench2.1 上从 69.7% 提升到 77.2%,在 OSWorld2.0 上从 2.8% 提升到 8.3%。它还将 Claude Opus4.7 在 OSWorld2.0 子集上的表现从 20.0% 提高到 34.3%,展示了跨模型、框架和交互领域的一致性能提升。
论文精读
TL;DR LongHorizon-Harness 将长链任务执行重构为显式任务状态管理,通过 MEA 循环独立验证环境状态,避免错误累积,在多个基准上将不同模型性能提升 8-29 个百分点。
问题
领域背景
LLM agent 正从单步问答演进至需持续推理、工具调用和修正的长周期任务(long-horizon tasks)。业界关注如何让 agent 在真实场景(如桌面自动化、终端运维)中稳定完成上百步的复杂流程。
现有方法局限
当前主流 agent 框架(如 AutoGPT、LangGraph)将任务执行、状态追踪、完成判断全部塞入不断膨胀的上下文窗口:
- 长上下文导致状态遗忘或混淆,agent 难以准确跟踪全局目标;
- 自评估偏差:agent 自行判定子任务完成,但缺乏环境验证,错误的自评会污染后续决策(如论文原文指出“incorrect self-assessments propagate into later decisions”);
- 一旦执行偏离,缺乏独立回退机制,往往需要从头重试。
为什么困难且重要
- 技术挑战:长周期任务涉及数十步依赖,错误会累积放大。需要将规划、执行、验证解耦,并引入只读的、可复现的环境审计(如 LongHorizon-Harness 的 Auditor),这在 GUI/CLI 等交互域中实现复杂。
- 业界关注:企业级自动化(如 RPA、CI/CD、软件部署)要求 agent 运行数小时仍保持可靠;任何一步失败若不可恢复,链条即断裂。该问题直接制约 AI agent 从 demo 走向生产。
行业类比
本质类似软件持续交付流水线——每个阶段需要独立验证与状态存档,错误即时隔离,否则整个发布失败。LLM agent 同样需要“流水线编排+检查点”机制,而非依赖一次性会话记忆。
核心洞察
- **显式任务状态管理替代上下文累积**:现有 LLM agent 框架(如 AutoGPT、TaskWeaver、CrewAI)通常在不断扩展的上下文中隐式维护任务状态与完成评估,状态漂移和错误自评极易传播并导致后续决策失败。LongHorizon-Harness 将任务状态显式外置于执行循环,通过 Manage-Execute-Audit(MEA)架构以独立验证的环境事实更新状态,从根源上切断了错误级联的可能性。这一重构将长周期执行视为状态管理问题,为 agent 可靠性提供了新的设计范式。
- **执行-审计分离确保进展基于事实**:该工作将任务执行器(Executor)与审计器(Auditor)完全解耦,审计器只读检查环境状态,不参与任何决策或操作,输出仅作为下一轮管理的输入。相比依赖 LLM 内部自评估或最终状态检查的方法,这种分离用环境事实替代自我判断,杜绝了自我评估的偏差累积。在 WeaveBench、OSWorld 等复杂长周期测试中,该机制显著提升了成功率,并展示了跨模型、跨 harness 的泛化能力,证明了审计回路是长周期 agent 可靠性的关键组件。
方法
方法概述:将长程任务执行建模为显式状态管理
LongHorizon-Harness 将长程 Agent 执行从隐式上下文记忆重构为显式任务状态管理,核心是一个 MEA 循环(Manage-Execute-Audit) 。任务状态独立于执行上下文维护,仅通过环境独立验证的事实更新,从根本上阻断错误自评估的传播。
输入与任务状态初始化
- 输入:用户指令、初始环境状态(GUI 截图/终端输出等)。
- 任务状态(Task State) 是一个结构化记录,包含已完成子任务、验证证据、当前进度等,由 Manager 模块专责维护。
关键模块:MEA 循环
1. Manager(管理模块)
- 根据当前任务状态与审计结果,决定下一子任务或判定整体完成。
- 负责更新任务状态:仅当 Executor 执行后,由 Auditor 提供的独立验证事实才会被合并到状态,避免不可靠的自我评估写入状态。
- 产出:下一个子任务描述(如“安装 Python 3.10 并验证版本号”)。
2. Executor(执行模块)
- 无状态、每次使用新上下文(fresh context),仅接收当前子任务与环境快照,执行 GUI/CLI 操作。
- 解耦执行与状态记忆,防止上下文膨胀和幻觉传播。
- 后端适配:通过轻量级 AgentAdapter 支持不同模型和原生 Agent 循环(如 CodeAct、ReAct),无需修改其内部循环。
3. Auditor(审计模块)
- 只读权限,独立检查环境状态(如截图、文件内容、进程列表),生成结构化审计结果(成功/失败/证据)。
- 审计结果作为唯一可信信号反馈给 Manager,用于状态更新和下一步决策。
输出与闭环
审计结果驱动 Manager 更新任务状态并产生下一子任务,形成 执行-验证-规划 闭环。最终,当 Manager 判定整个任务完成时,输出包含完整证据链的任务记录。
与同类方法的差异
与传统将状态嵌入上下文窗口的 Agent 框架(如 AutoGPT、CrewAI)不同,LongHorizon-Harness 将状态作为一等公民(explicit state),通过读写分离的审计机制确保状态可靠性,尤其适用于多步骤、易累积错误的真实任务。
实验
实验设计
论文在三个长周期任务基准上评估 LongHorizon-Harness:
- WeaveBench:多步骤网页交互与信息检索任务;
- OSWorld 2.0:真实操作系统 GUI 操作任务;
- Terminal-Bench 2.1:终端命令执行与系统管理。
基线为各模型的原生 agent harness,如 Qwen 3.7-Plus 直接使用工具执行。实验还测试了更强模型 Claude Opus 4.7 在 OSWorld 2.0 子集上的表现,验证框架对不同骨干模型的兼容性。框架核心为 Manage-Execute-Audit (MEA) 循环,显式分离任务状态管理、执行与审计。
关键发现
LongHorizon-Harness 在所有基准上均带来一致且显著的性能提升:
- 在 WeaveBench 上,Qwen 3.7-Plus 准确率从 51.8% 跃升至 80.7%(+28.9 pp),说明审计机制有效抑制了自我评估错误;
- 在 Terminal-Bench 2.1 上,从 69.7% 提升至 77.2%(+7.5 pp),表明终端类任务也受益于状态追踪;
- 在 OSWorld 2.0 上,从 2.8% 提升至 8.3%(+5.5 pp),相对提升接近 200%,即使绝对数值不高,也证明了在极低基线下的可改进空间;
- 对于 Claude Opus 4.7,在 OSWorld 子集上由 20.0% → 34.3%(+14.3 pp),验证了框架的模型无关性。
与基线对比解读
原生 harness 将任务状态、执行和历史上下文混杂在单一上下文中,导致错误累积与无效决策。LongHorizon-Harness 将长周期执行重新定义为任务状态管理问题:
- Manager 维护显式状态并规划子任务;
- Executor 每次用全新上下文执行,避免历史干扰;
- Auditor 只读验证环境状态,阻断错误传播。
这种解耦使得状态更新仅基于环境验证的事实,显著提升了复杂多步任务的鲁棒性。提升幅度因任务类型而异:WeaveBench 的多步推理与证据验证更契合审计机制,故收益最大;OSWorld 虽绝对数值低,但相对提升巨大,说明即使是目前最弱的 agent 也能通过结构化 harness 获得实质性改进。这一发现强调:长周期 agent 的能力不应仅归因于模型本身,而应视为模型与执行架构共同决定的系统属性。
行业影响
落地场景
该框架直接赋能需要长周期、多步骤、多工具协同的自动化产品,例如:
- RPA/智能助手:处理涉及GUI、CLI、API 混合交互的复杂业务(如订单履行、跨系统数据录入)。
- IT 运维与 DevOps:自动化软件部署、故障排查、配置管理,确保每个操作后的环境状态经独立审计。
- 自动化测试:端到端测试场景中,验证图形界面与后端状态的一致性,避免误判。
- 数据分析与报告:需多轮查询、融合、验证的研究型任务。
商业价值
核心价值在于 提升长周期任务的成功率与可靠性,直接降低人工兜底成本:
- 降本:减少因错误自评导致的连锁失败和人工干预,Agent 可自主收敛到正确结果。
- 增收:支撑更复杂的自动化服务(如无人值守的云端运维),扩展可售卖能力边界。
- 体验提升:任务完成更稳定,端到端耗时缩短(避免重复或错误路径),对外部客户承诺的 SLA 更有保障。
与现有产品/工作流的接口
LongHorizon-Harness 定位为 Agent 编排层,非侵入式设计易于集成:
- AgentAdapter 机制允许对接不同模型(Qwen、Claude 等)和现有 Agent 框架(LangChain、CrewAI),无需改造原生循环。
- 可作为独立状态管理模块嵌入工作流引擎(如 Temporal、Airflow),通过「Manager-Executor-Auditor」模式替换原有的线性执行+上下文累积模式。
- 可验证环境状态的设计天然适合与确定性接口(数据库、文件系统、API)结合,审计器可设计为轻量脚本,重用现有监控/校验组件。
具体落地用例
电商订单异常处理
一个订单支付超时但用户误以为已付款的场景。Agent 需:查支付网关 → 查内部流水 → 若不一致则发起退款或补单 → 更新 CRM。传统 Agent 可能错误评估“已支付”并跳过退款。LongHorizon-Harness 在每步后由 Auditor 对比支付网关真实状态与 Manager 预期,发现不一致则触发修正子任务,确保最终状态闭环。金融合规报告自动生成
需从交易系统、风控系统、监管上报平台采集数据,经计算、校验、盖章后生成报告。Auditor 在每个数据聚合步骤后验证数据完整性(如行数、关键字段非空),防止坏数据污染后续汇总。Manager 保留中间状态,允许局部重新执行,避免从头开始,显著降低计算成本与延迟。
局限
- 对环境独立验证的依赖:MEA 循环的核心是审计员从环境获取事实并验证执行结果,这要求任务环境能提供可提取的结构化或非结构化证据。当任务涉及主观判断或环境反馈嘈杂时,审计标准难以定义,审计员可能产生误判,从而影响状态更新与后续规划。
- 计算开销与延迟增加:每个执行步骤都需额外审计,增加了 token 消耗和端到端延迟。论文虽分析了成本–性能权衡,但在实时交互或延迟敏感场景(如终端命令行快速操作)中,频繁的审计轮次可能降低系统响应速度,限制实际部署的适用性。
- 状态定义与适配成本:方法要求针对不同任务域预先设计任务状态表示和审计准则,这需要领域专家投入。对于新任务或罕见场景,开箱即用的泛化能力有限,可能需要大量人工适配工作,阻碍了在开放世界中灵活扩展。