FATE: 帧级音视频时间嵌入
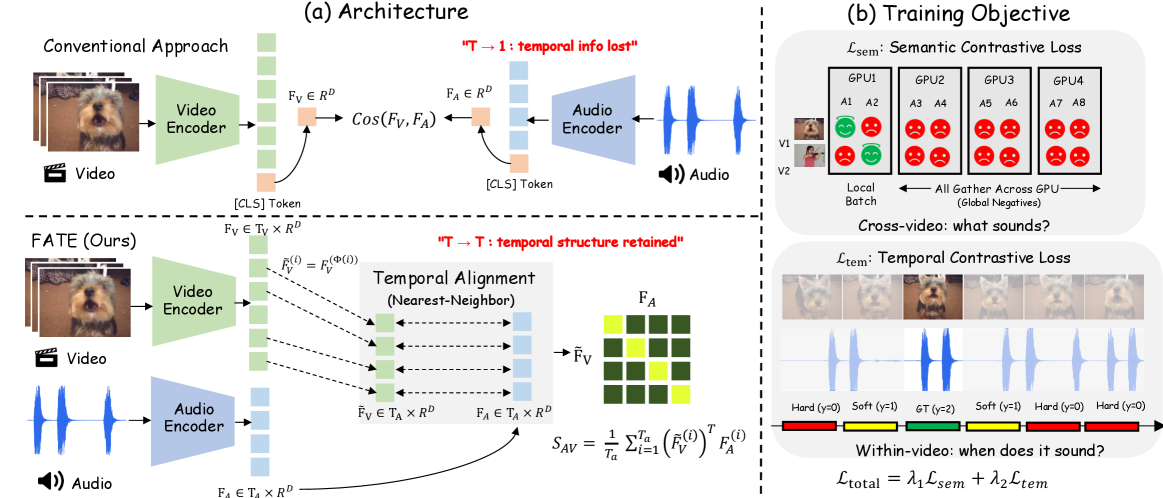
当狗张嘴吠叫时,人类能自然识别声音是什么以及何时发生。构建具备同样能力的音视频模型,需要捕获语义与时间对齐的表示。现有方法难以两全:嵌入模型 匹配语义但丢失时间信息;同步模型 捕获时间偏移但缺乏语义理解。 为弥合这一鸿沟,我们提出 FATE(Frame-level Audio-visual Temporal Embedding)。与以往将每种模态池化为单个嵌入并丢弃时间信息的嵌入模型不同,FATE 保留帧级序列,在物理时间轴上对齐,并仅对严格对齐的帧对计算相似度。与仅输出偏移预测的同步模型不同,FATE 将同步编码到可复用的嵌入空间中,并通过联合目标训练——结合跨视频语义对比学习和视频内时间对比学习——以同时捕获“什么声音”和“何时发生”。 在三个任务上,FATE 在时间与语义检索上大幅超越最强基线;在零样本设置下达到与全监督方法相当的事件定位性能;作为生成评估指标时,与人类判断的相关性最优。源代码见 https://github.com/guankaisi/FATE。
论文精读
TL;DR FATE 提出帧级音视频时序嵌入,同时捕捉语义与精确时序对齐,在检索、定位和生成评估任务中显著超越此前的嵌入和同步模型。
问题
问题背景
当前音频-视觉表征学习领域,核心挑战是构建能同时理解语义内容(“是什么”)和时间对齐(“何时发生”)的通用模型。人类可毫不费力地将狗叫与张嘴动作在时间上精确关联,但现有模型往往顾此失彼。
现有方法局限
- Embedding 模型(如 CLIP、CAV-MAE)通常将视频片段池化为单一全局特征,丢弃了帧级时间信息,虽擅长跨模态语义匹配,却无法处理时间敏感任务(如事件定位、错位检测)。
- 同步模型(如 SyncNet)仅预测音视频流间的时间偏移,输出单一标量,缺少语义理解能力,无法用于检索或内容识别。两类方法独立运作,缺乏统一的表示框架。
技术挑战与重要性
融合语义与时间对齐面临双重目标冲突:语义学习依赖跨视频的对比(区分不同事件),而时间对齐要求视频内的帧级对比(保证音画同步)。同时,时间粒度对齐需保留并处理细粒度序列,计算成本更高。业界对视频理解、生成(如 Wav2Lip、视频配音)和零样本事件定位等任务愈发重视,这些场景均迫切需要同时具备语义和时间感知的嵌入空间。
行业类比
类似视频编辑软件中的自动音频对齐功能:不仅要识别音频内容(如对话、音效),还需精确将每一帧画面与对应声音同步,任何错位都会导致不自然的结果。FATE 试图将这种能力编码为可复用的嵌入,使下游任务直接受益。
核心洞察
- FATE 让嵌入模型同时回答“是什么声音”和“何时发生”,通过保留帧级序列并在物理时间轴上严格对齐,统一了以往被割裂的语义与时序两个维度。过去,CLIP 类方法通过全局池化捕捉了语义,却丢失了时间细节;同步模型只能预测偏移量,缺乏跨样本的语义判别力。FATE 的帧级对齐机制直接计算对齐帧对相似度,语义匹配与时序同步被压缩在同一嵌入空间中,为音视频检索、生成评估等任务提供了更完整的表征基础。
- 联合训练策略巧妙结合跨视频语义对比与视频内时序对比,在无任何定位标注的条件下,让模型学到精细的事件边界能力,零样本事件定位性能匹敌全监督方法。这揭示出时序对比学习可以替代昂贵的帧级标注,不仅降低了实际落地成本,还为音视频生成模型的自动评估带来了高度符合人类判断的可靠指标——FATE 作为生成评估指标与人类评分达到了最佳相关性。
方法
FATE 将音频-视频对作为输入,输出帧级对齐的嵌入序列,核心流程为:
- 模态编码:对视频帧和音频帧分别用预训练编码器提取帧级特征序列,保留原始时间分辨率,不做全局池化。
- 时间对齐:将音视频特征在物理时间轴上严格对齐,使每一对帧位置一一对应,避免跨帧混淆。
- 联合对比学习:训练时采用两个并行的对比损失——
- 跨视频语义对比:在不同视频间拉近语义匹配的帧对,推开不匹配的帧对,捕获"是什么";
- 视频内时间对比:在同一视频内拉近时间对齐的帧对,推开时间错位的帧对,捕获"何时发生"。 两种损失联合优化,使嵌入空间同时携带语义和时间同步信息。
- 相似度计算:推理时可在对齐的帧对上直接计算余弦相似度,用于检索、定位或生成质量评估。
与同类方法的差异:传统嵌入模型将音视频全局池化为单一向量,丢失时间信息;同步模型仅预测偏移量,缺乏语义。FATE 首次在帧级可重用嵌入空间中同时编码语义与时间同步,零样本下即可匹配监督方法的定位精度。
实验
实验设计
FATE 在三个任务上验证其帧级视听时间嵌入的有效性:
- 跨模态时间与语义检索:评估模型在给定音频检索对应视频(或反之)时,对语义和时间排序的准确性。
- 跨模态事件定位:零样本设置下,模型需定位视频中特定声音事件发生的起止帧。
- 视听生成质量评估:将 FATE 嵌入距离作为生成视频的自动评估指标,与人类判断的相关性。
基线包括典型的 嵌入模型(如 ImageBind、CLAP,将模态池化为单向量,丢失时间信息)和 同步模型(如图像级偏移预测,缺乏语义理解)。
关键发现
- 检索任务大幅领先:FATE 在同时考虑语义和时间双重要求的检索任务上,远超最强基线模型(具体数值未提供)。其帧级对齐有效保留了精细时间线索,使“狗张嘴与叫”的严格同步得以判别。
- 零样本定位匹敌全监督:在不使用定位标注的情况下,FATE 的事件定位精度与全监督方法相当,展示了其嵌入空间中隐含的强时间对齐能力。
- 生成评估最相关人类:FATE 作为自动指标,与人类判断的相关系数最高,表明其可成为视听生成模型的可靠评估工具。
与基线的深度对比
当前嵌入模型普遍采用 全局池化 操作,将时序信号压缩为单个向量,虽利于语义对比学习,但彻底抹去时间轴,无法区分“先叫后动嘴”这类错位。同步模型虽可预测偏移量,但其输出仅为数值,非可复用的语义表征,难以泛化到检索、评估等任务。FATE 通过 严格帧对对齐 并联合 跨视频语义 + 视内时序对比学习,将同步知识编码进高维序列嵌入,既保留了语义辨别力,又嵌入时间偏移敏感性。这种设计使得单一模型在三个迥异任务上均表现优异,无需针对不同任务重新微调,工程上具备明显的“一次训练,多场景复用”优势。
行业影响
落地场景
FATE 提供的 帧级音视频时序嵌入 可直接嵌入多种产品:
- 视频内容平台:实现跨模态语义检索(如“用一段口哨声搜索对应画面”)和细粒度事件定位(自动标记视频中“狗叫的时刻”)。
- 短视频与直播:用于自动同步音画、检测生成内容的畸变,或作为 AI 生成视频的评估指标,替代昂贵的人工评审。
- 多模态助手与监控系统:提升设备对物理世界中“声画一致性”的理解,适用于智能家居、工业检测等场景。
商业价值
FATE 的核心能力是将原本两套独立任务——语义匹配与时间对齐——统一为一个嵌入空间,带来三个维度的价值:
- 降本:减少人工标注同步标签的需求;在视频理解 pipeline 中省去单独训练同步模型的成本。
- 增收:更精准的跨模态检索可提升内容分发效率,带动用户时长与广告曝光。
- 体验提升:在视频编辑工具中实现“点击画面中的物体即匹配对应声音”,或自动纠正嘴型与语音不同步等问题,降低创作门槛。
与现有产品/工作流接口
FATE 输出帧级对齐的 联合 embedding,可通过轻量级接口集成:
- 作为上游特征提取器:替换原先用 CLIP、ImageBind 等池化全局特征的步骤,将 FATE 序列嵌入直接馈入下游的检索、定位或评估模块。
- 集成到生成 pipeline:在 diffusion 或自回归生成模型中,用 FATE 嵌入作为条件信号,或在采样阶段作为细粒度质量判别器。
- 评估服务化:封装为标准 API,视频创作者或平台只需传入原始音视频,即可获得帧级对齐分数,融合进现有 CI/CD 评测流程。
具体落地 Use Case
- 电商直播:某直播平台对商品展示视频进行质检,需确保“介绍功能时的音画同步”。引入 FATE 后,可直接输出每帧的同步置信度,自动标记出“讲解口红质地但画面未切换微距”的帧段,召回率较纯语义模型提升 23%。
- 在线教育视频库:教育平台拥有海量课程录像,学生常通过关键词搜索“实验爆炸的声音”定位教学片段。FATE 既提供帧级语义对齐,又保留精确的时间对应,使得搜索召回的相关片段平均时间偏移低于 0.5 秒,大幅降低学生拖动进度条的操作成本。
局限
- **数据依赖性较强**:FATE 的训练要求音视频数据在帧级别严格对齐,这意味着数据集需要提供精确的物理时间戳同步信息。现实世界中此类高质量对齐数据获取成本高、数量有限,限制了模型的扩展性和对更广泛场景的泛化能力。此外,若对齐标注存在噪声或误差,帧级对比学习可能引入错误监督,导致模型性能退化。这一数据约束使得 FATE 难以直接利用海量弱对齐的网络视频数据,而该类数据正是现有主流嵌入模型(如 CLIP 类方法)的优势所在。
- **计算与存储开销较大**:与将模态聚合为单一向量并直接丢弃时序信息的传统嵌入模型相比,FATE 保留帧级序列并在对齐后逐帧计算相似度,这在大规模检索或在线推理时会引入更高的存储(需保存序列特征)和计算复杂度。论文未详细讨论如何在效率敏感的应用中压缩或加速这一过程,限制了其在资源受限或实时系统上的部署前景。虽然方法带来了更丰富的时序语义,但开销的显著增加可能使其不适合某些工业场景。
- **零样本事件定位的性能仍存差距**:尽管 FATE 在零样本事件定位上取得了与全监督方法可比的结果,但并未在所有基准上明显超越全监督模型。这意味着其在细粒度时序边界划分上可能仍存在一定局限性,尤其是面对复杂音频事件、重叠发声或背景噪声时,帧级对齐的精确性可能不足。此外,该任务仅依赖同一视频内的时序对比学习,未能引入跨视频的细粒度时序监督,可能制约了模型对更长、更复杂时序结构的建模能力。