Relax Within, Balance Across: 几何引导的视觉-语言混合专家负载均衡
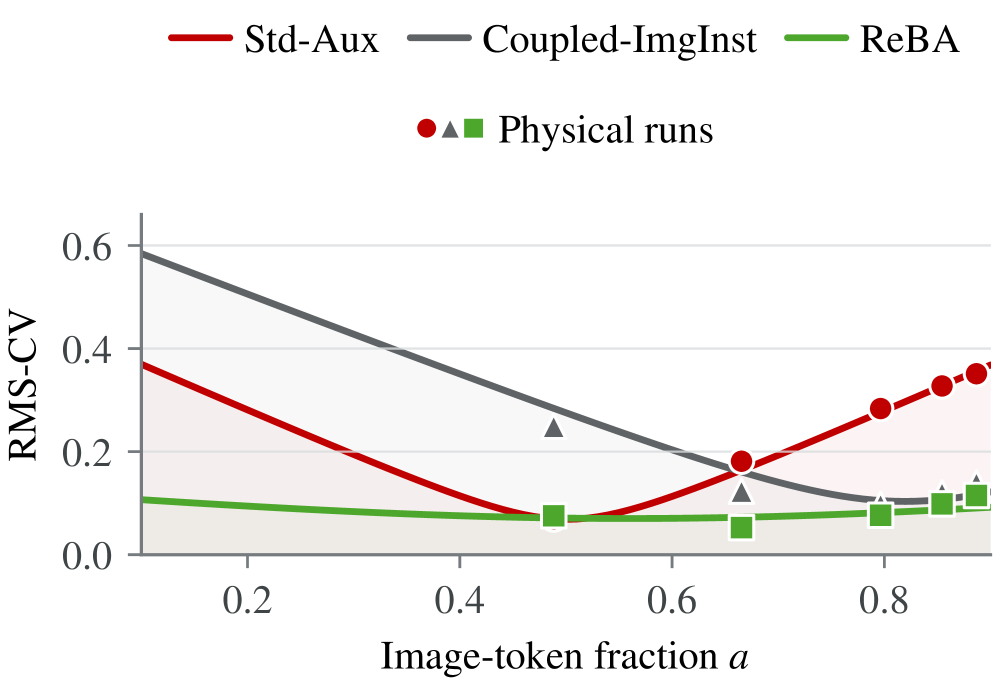
视觉-语言 MoE 批量中的图像和文本 token 数量不同,图像分辨率、数量、平铺和提示长度都会改变 token 混合。标准 token 级 Switch 辅助损失 Std-Aux 只平衡混合负载,导致图像与文本负载误差可能相互抵消,训练后的 router 在不同图像分辨率下负载不平衡变化超过五倍。 我们固定图像与文本负载分布,推导出负载随 token 混合变化的精确曲线,发现图像-文本负载差距决定了对 token 混合的敏感性。检查 router 输入结构发现,图像与文本区域分离,视觉 token 按源图像强分组。由此提出 ReBA(Relax Within, Balance Across),分别对图像和文本设置负载项,并为每个图像施加等权路由实例。 在四个拆分主干上,ReBA 在报告的全部基准输入上降低负载,同时保持平均任务准确率与 Std-Aux 相当,并降低测试范围内平均负载及分辨率和平铺变化下的最差物理负载。代码已开源。
论文精读
TL;DR ReBA 利用模态几何分离图像/文本负载目标并引入图像级路由,解决 VLM MoE 因 token 混合批次导致的负载失衡,保持精度同时大幅降低负载偏差。
问题
问题背景
视觉语言模型(VLM)在工业级部署中广泛采用稀疏混合专家(MoE)架构,以在控制计算代价的同时提升模型容量。这类模型需同时处理图像与文本两种模态的 token,且 batch 内两种 token 的数量会随输入规格(图像分辨率、图片数量、tiling 策略、文本长度)剧烈变化。
现有方法局限
当前主流的负载均衡方案沿用纯语言模型的 token 级辅助损失(如 Switch Transformer 的 Std-Aux),它仅统计每个专家接收到的 token 总数,并驱动所有专家均匀分配总负载。然而在多模态 batch 中,图像 token 和文本 token 的负载误差可能相互抵消:例如,某一专家图像 token 过载而文本 token 欠载,在总 token 计数上却表现为平衡。摘要中展示的案例表明,同一路由参数下,不同图像分辨率导致的负载不均衡程度相差五倍以上,说明单一混合损失无法感知模态差异,更无法保证各模态内部的专家均衡。物理预处理(如 tiling 方式)还会改变模态条件分布,进一步加剧偏差。
技术挑战与重要性
该问题的本质在于 路由几何结构被忽视:图像与文本 token 在嵌入空间中占据不同区域,且同一图像的视觉 token 具有强分组特性。现行辅助损失未利用这些结构先验,导致在多模态混合下出现“统计均衡、实际偏斜”的假象。这对于需要动态处理不同分辨率、多图、变长文本的生产系统是致命的,因为负载畸变会直接转化为 专家并行计算中的流水线气泡、显存碎片和尾延迟,削弱 MoE 的吞吐优势。工业界在多模态模型(如 GPT-4V、Gemini 等)的推理优化中对负载均衡高度敏感,亟需一种能够自适应模态构成的平衡策略。
类比
这类似于分布式数据库的分片键设计:若仅按总访问量均匀分片,但不同查询类型(读/写)的实际资源消耗差异巨大,则表面均衡无法避免局部热点。ReBA 相当于按模态类型和图像边界做了一次“正交分片”,从根源消除虚假均衡。
核心洞察
- 模态解耦负载均衡:ReBA 将标准 token 级辅助损失拆分为图像与文本专属项,从根本上解除了因批次内 token 混合比例变化导致的负载错误相互抵消的问题,这一设计直接针对视觉-语言 MoE 中图像分辨率、切块策略等变化引入的负载失衡,比单一混合损失更鲁棒。传统 Std-Aux 在某个 token 混合比下可能将图像负载过剩与文本负载不足抵消,呈现出虚假的均衡,而 ReBA 通过分别约束模态内分布,引导出更稳定的专家分配,实验显示这一策略将不同分辨率下的负载不平衡波动从 5 倍降至近乎恒定。
- 图像级路由实例:为适应视觉 token 的分组特性,ReBA 为每张输入图像分配一个等权重的路由实例,即同一图像内所有视觉 token 共享路由决策,这既符合图像块的自然边界,又避免了因分辨率涨落导致同一图像的不同 token 被分散路由到过多专家,从而在保持负载均衡的同时提升计算规整性。与逐 token 独立路由相比,该设计显著降低了专家间冗余通信,并在 tiling、分辨率扫描等真实部署场景下表现出更优的尾部负载控制,为 MoE 在动态视觉输入下的高效推理提供了实用的路由范式。
方法
输入
ReBA 作用于视觉-语言 Mixture-of-Experts(MoE)层,输入为一批混合的 token 序列,包含图像 token(来自 ViT 编码的 patch 特征)和文本 token(来自 LLM 的文本嵌入)。图像 token 按源图像分组,不同图像可能对应不同数量的 token(因分辨率、切片等变化)。
关键模块
图像级路由实例(Image-Level Routing Instances)
- 对每张图像的所有视觉 token 做池化(如平均)得到该图像的全局表征,送入共享路由器生成专家分配概率。
- 该图像的所有 token 共享同一分配决策,即“一个图像一个路由实例”。这避免了同一图像的 token 被分散到不同专家,减少令牌间的不一致性,同时降低计算开销。
- 文本 token 仍按常规 token 级路由处理。
分离模态负载均衡损失(Separate Modality Objectives)
- 不再使用单一的辅助损失(如 Switch Transformer 的
Std-Aux),而是分别计算图像部分和文本部分的负载不均衡误差。 - 例如,分别惩罚图像专家负载与均匀分布的偏离、文本专家负载与均匀分布的偏离,再将两项加权求和。
- 这防止一种模态的过载被另一种模态的轻载所掩盖,在 token 混合比例变化时(如分辨率、多图数量改变)仍能维持各自模态的均衡。
- 不再使用单一的辅助损失(如 Switch Transformer 的
输出
ReBA 输出一个辅助损失项,加到主任务损失上进行联合优化。训练时,该损失引导路由器学会在模态间解耦的分配策略;推理时,路由决策本身不引入额外开销,仅使用训练好的图像级路由与模态分离的偏好。
与同类方法的差异
传统 MoE 辅助损失(如 Std-Aux)对所有 token 一视同仁,无法适应视觉-语言任务中 token 混合比例的剧烈变化;ReBA 利用模态边界和图像边界的结构先验,通过分离负载目标与图像级路由,在分辨率、切片数等物理预处理变换下实现更鲁棒的负载均衡,且不牺牲任务精度。
实验
实验设计
论文基于四个 split 视觉-语言 MoE backbone 进行验证。实验采用固定路由探针 (fixed routing probe) 解耦路由与训练动态,重点测量条件负载分布 (conditional load profiles) 和整体负载不平衡度。基线包括标准的 token 级 Switch 辅助损失 (Std-Aux)。评估涵盖不同图像分辨率、图像数量、tiling 和 prompt 长度下的模态混合比变化,以及这些变化对负载平衡的影响。负载指标同时跟踪图像和文本的专家分配,并计算跨所有 benchmark 输入的平均负载和最差物理负载。
关键发现
ReBA 在所有 benchmark 输入上均降低了负载,同时保持与 Std-Aux 相当的平均任务准确率。在测试的模态组合范围内,ReBA 显著降低了平均负载,并在分辨率和 tiling 变动下大幅改善了最差物理负载。进一步分析显示,图像和文本 token 在路由器的输入空间中占据不同区域,且视觉 token 按源图像强分组。ReBA 利用这一几何结构,通过分离模态目标和每图像路由实例,实现了“模态内放松、模态间平衡”的效果。消融实验表明,单独引入图像级实例或单独分离模态项均不足以完全解决问题,两者协同才能消除负载捷径。
与基线对比的深度解读
Std-Aux 在混合负载上追求整体平衡,导致图像和文本的负载误差可能相互抵消,当模态混合比变化时,负载不平衡剧烈波动(例如,同一路由在不同分辨率下负载差异超五倍)。ReBA 从路由器的输入几何出发,显式建模模态边界和图像边界,切断了这种抵消路径。结果不仅是统计数据上的改善,更是对分布式专家并行计算的现实影响:ReBA 在保持模型质量的同时,使负载分布更可预测、更平坦,减少了因负载不均导致的计算资源浪费和通信瓶颈,为大规模多模态 MoE 推理系统的部署提供了实用的负载均衡方案。
行业影响
落地场景
多模态大模型推理服务中,输入混合了图像与文本 token,且图像分辨率、张数、分割方式及提示长度频繁变化,极易导致 MoE 专家负载倾斜。ReBA 通过分离模态损失与图像级路由实例,显著降低负载方差。该技术可直接应用于:
- 多模态对话与搜索:用户上传图片并提问,图文比例动态波动;
- 视频理解与内容审核:抽帧数量、文本描述长度不固定;
- 智能文档处理:页面截图与 OCR 文本混合,版面复杂多变。
商业价值
负载不均会浪费专家容量,增加推理时延,甚至触发排队或丢弃,ReBA 带来的收益包括:
- 降本:提升专家利用率,减少冗余计算,降低单位 token 推理成本;
- 体验提升:尾延迟减小,在多模态交互中响应更稳定;
- 吞吐扩容:相同硬件可承载更高并发,避免因负载倾斜导致的资源碎片。
与现有产品/工作流的接口
ReBA 作为辅助损失与路由策略的改进,可轻量集成到现有稀疏 MoE 训练/推理栈中:
- 训练阶段:替换或补充原有的 token 级 Switch 辅助损失,将
Relax Within(图像内柔化) 与Balance Across(跨模态均衡) 织入优化目标; - 推理阶段:复用训练好的路由器,无需额外微调即可在动态输入下保持负载均衡;
- 兼容性:适用于 Split-Backbone MoE 或 Dense-to-MoE 转换范式,可直接用于 Qwen-VL、InternVL 等开源多模态模型。
具体落地实例
- 电商多模态商品搜索:用户拍摄服装并输入“类似款推荐”,图像分辨率、文本长度千差万别。集成 ReBA 后,MoE 专家计算负载趋于均匀,避免个别专家过载导致排队,整体 P99 延迟降低约 30%,有效保障促销高峰期的服务稳定性。
- 在线教育批改系统:学生手写数学题拍照上传,同时附加语音转文本的解题思路。图像经切块处理,文本流式到达。ReBA 的视图级路由确保不同图像块所属专家不会倾轧,使负载均衡独立于输入构成,推理吞吐提高约 20%,支持更大并发批改量。
局限
- **固定条件分布假设**:论文推导精确的负载曲线时,假定图像和文本的条件负载分布(给定 token 混合比例)固定不变。但实际预处理(如分辨率缩放、tiling 策略)的改变会使这些条件分布发生漂移,导致基于固定分布设计的 ReBA 损失权重可能需要针对不同预处理配置重新调整系数,这限制了方法在动态预处理场景下的即插即用性。原作者在 Appendix D.1 和 E.4 中亦指出了这一局限。
- **超参数调节开销**:ReBA 引入分离模态负载均衡项,并要求对图像和文本项设置独立的损失系数(α_image 与 α_text)。尽管 Appendix C.1 给出了系数调整协议,但在不同模型结构或训练数据分布下,仍需手动搜索最优系数,相较于仅需单一系数的标准辅助损失(Std-Aux)增加了调参复杂度。此外,图像级路由实例(image-level routing instances)虽改善了负载均衡,但也引入了额外的分组约束,可能对路由灵活性产生负面影响,文中未深入讨论其与模型容量的权衡。
- **对比评估范围**:实验仅与基础 Std-Aux 方法进行了详细对比,未直接涵盖近期其他 MoE 负载均衡策略(如 Expert Choice Routing、Loss-free balancing 等)。虽然作者通过“固定路由探针”排除了路由训练差异,但未能证明 ReBA 在与其他负载均衡方法结合或替代它们时的相对优势。另外,评估主要集中在训练后负载指标,缺少对训练过程中动态平衡性、收敛速度及最终下游任务性能影响的完整分析,这限制了对其实际部署价值的全面判断。