ST-WAM: 语义-时间世界动作模型用于视觉分布偏移下的鲁棒操控
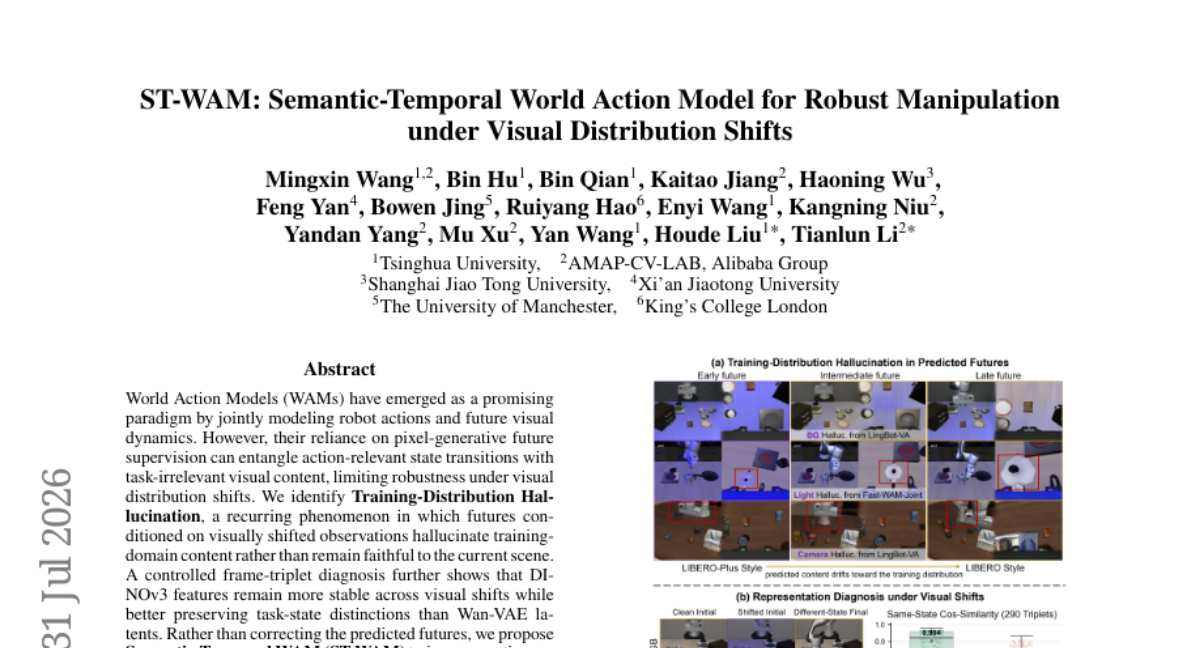
世界动作模型(WAMs)通过联合建模机器人动作与未来视觉动态,成为一种有前景的范式。然而,它们对像素生成式未来监督的依赖,会将动作相关的状态转移与任务无关的视觉内容纠缠在一起,限制了其在视觉分布偏移下的鲁棒性。我们识别出训练分布幻觉(Training-Distribution Hallucination)这一反复出现的现象:在视觉偏移观测条件下生成的未来会幻觉出训练域内容,而非忠实反映当前场景。 受控帧三元组诊断进一步表明,DINOv3 特征在视觉偏移下更稳定,同时比 Wan-VAE 潜变量更好地保留任务状态区分。我们提出 语义-时间世界动作模型(ST-WAM),使用 DINOv3 作为共享语义表征,用于未来预测与历史检索,同时保留细粒度的 VAE 动态。其 双空间未来专家(DSFE)联合预测未来 VAE 潜变量和 DINO 特征,当前锚定意图检索(CAIR)在当前视觉-语言上下文下从近期 DINO 历史中检索任务相关证据。ST-WAM 端到端训练,无需额外的具身预训练或任务特定标注,推理时也不要求显式未来生成。 实验结果表明,ST-WAM 在 LIBERO 上达到 98.7%,在 RoboTwin 2.0 上达到 92.8%;更重要的是,与 Fast-WAM 相比,它将在零样本 LIBERO-Plus 上的性能提升了 21.3 个百分点,并将真实世界视觉偏移下的成功率从 25.8% 提高至 61.5%,提升了一倍以上。这些结果证明,语义-时间建模能有效补充像素生成式动态,实现稳健操控。
论文精读
TL;DR ST-WAM 将 DINOv3 语义特征注入世界动作模型,通过语义-时序建模缓解视觉偏移下的训练幻觉,大幅提升机器人操控在零样本与真实场景中的鲁棒性。
问题
问题背景
机器人操控领域中,World Action Models (WAMs) 通过联合建模动作序列与未来视觉动态,在多种基准上取得显著进展,但其对视觉外观变化的鲁棒性仍有待提升。
现有方法的局限性
主流 WAMs(如 Fast-WAM)依赖像素生成式未来监督,以 VAE 潜变量 为预测目标。这导致模型会将任务无关的视觉细节(如背景纹理、光照)与真实状态转移纠缠。作者观察到一个关键现象——Training-Distribution Hallucination:当观测出现视觉偏移时,模型预测的未来帧会“幻视”出训练域中的视觉内容,而非保持对当前场景的忠实。诊断实验显示,DINOv3 特征 在视觉变化下比 VAE 潜变量更稳定,且能更好地区分任务状态,但现有方法未显式利用这种语义不变性。
问题挑战与重要性
视觉分布偏移(如光照、背景变化)是机器人从受限数据学习到开放世界部署的核心障碍。真实环境视觉多样性极高,训练数据难以穷举所有可能,因此模型必须学习对任务关键状态不变的表示。然而,将动作预测与全量视觉动态紧密耦合,极易导致过拟合训练外观。如何在不牺牲精细动态建模的前提下引入语义不变性,是一个技术难点。该问题直接影响操控模型的现实部署鲁棒性,也是产业界降本增效(减少数据采集依赖)的关键需求。
行业类比
这一挑战类似于计算机视觉中自监督预训练模型(如 DINO)在未见过场景下保持物体分割一致性——本工作将类似的不变性能力注入机器人动作预测,以对抗视觉域偏移。
核心洞察
- 训练分布幻觉是 WAM 在视觉偏移下失效的核心原因:模型在偏移输入上生成的未来帧会混入训练域视觉元素,而非忠实于当前场景。通过帧三元组诊断,作者定量证明了 DINOv3 语义特征对任务无关的视觉变化更稳定,且能更好地区分任务状态,这一发现直接颠覆了“通过改善未来帧质量来提升鲁棒性”的传统思路,为用语义不变性取代像素级生成监督提供了理论依据。
- ST-WAM 提出了双空间未来专家 (DSFE) 和当前锚定意图检索 (CAIR),将 DINOv3 语义表示作为未来预测和历史检索的统一媒介,在保留 VAE 细粒度动态的同时避免了显式未来生成。这一设计使推理极其高效,却在零样本 LIBERO-Plus 和真实世界视觉偏移下将成功率提升了超过一倍,证明了语义-时间建模能有效弥补像素生成式世界模型在鲁棒性上的短板,为后续模型设计提供了轻量而强大的新范式。
方法
ST-WAM 以当前视觉观测和自然语言指令为输入,输出低层机器人动作。其设计核心在于将语义表示(DINOv3 特征)与细粒度动力学表示(Wan-VAE 隐变量)解耦,并通过两个互补模块协同建模未来状态与历史意图。
双空间未来专家(Dual-Space Future Experts, DSFE)
DSFE 采用 三分支 MoE Transformer(Three-Branch Mixture-of-Transformers)架构,以结构化跨分支注意力掩码(Structured Cross-Branch Attention Mask)控制信息交互:
- VAE 分支:预测未来时刻的 Wan-VAE 隐变量,保留像素级动力学细节;
- DINO 分支:预测未来时刻的 DINOv3 语义特征,提供视觉偏移下更稳定的任务状态表征;
- 文本分支:编码语言指令,通过交叉注意力向视觉分支注入任务语义。 所有分支共享 Transformer 层,但注意力掩码确保 VAE 与 DINO 之间的交互经过文本调制,避免特征纠缠。
当前锚定意图检索(Current-Anchored Intent Retrieval, CAIR)
CAIR 不依赖未来生成,而是从近期观测历史中检索与当前任务相关的证据:
- 将当前帧 DINOv3 特征与语言指令融合,形成当前锚定语义查询(Current-Anchored Semantic Query);
- 在 DINOv3 历史缓存中通过注意力检索相似语义片段,提取任务进度线索(如物体移动、夹爪开合)。 该机制让模型在视觉突变时仍能“回忆”正确的任务上下文,从而稳定动作输出。
联合流匹配训练与推理
训练时,DSFE 和 CAIR 的输出共同输入到联合流匹配目标(Joint Flow-Matching Objective)中,端到端优化动作预测与未来表示预测。推理阶段无需显式生成未来图像,直接由当前语义和检索到的历史意图驱动动作头输出动作。
与同类方法的关键差异:相较于 Fast-WAM 等像素生成式 World Action Model,ST-WAM 不追求在视觉偏移下纠正未来图像,而是通过语义 - 时间建模将动作鲁棒性提升到新水平——DINOv3 未来预测与历史检索的结合,使得动作决策免受训练域视觉幻觉干扰,在零样本泛化与真实场景中显著优于仅依赖 VAE 潜变量的方案。
实验
实验设计
ST-WAM 在 LIBERO、RoboTwin 2.0 标准基准上评估,测试零样本泛化时引入 LIBERO-Plus(包含视觉分布偏移,如光照、背景变化)。真实世界实验则专门构造视觉分布偏移场景,对比基线为 Fast-WAM 等主流 WAM。模型训练端到端,无需额外具身预训练或任务特定标注,推理时无需显式生成未来帧。
关键发现
- 标准基准性能:ST-WAM 在 LIBERO 上达到 98.7% 成功率,RoboTwin 2.0 上达到 92.8%,均取得领先。
- 分布偏移鲁棒性:在更具挑战的 LIBERO-Plus 上,零样本性能相对 Fast-WAM 提升 21.3 个百分点;真实世界中,视觉偏移下的成功率从 25.8% 翻倍至 61.5%。
- 定性分析显示,DINOv3 语义特征在视觉变化下比 Wan-VAE latent 更稳定,且能更好保留任务状态区分,从而减少“训练分布幻觉”。
基线对比深度解读
对比 Fast-WAM 等像素生成式 WAM,ST-WAM 的核心差异在于用 DINOv3 构建共享语义时间表示,而非单纯依赖 VAE latent 预测未来。其 双空间未来专家(DSFE) 联合预测 VAE latent 与 DINO 特征,当前锚定意图检索(CAIR) 则从近期历史中提取任务相关证据,有效解耦动作相关状态与任务无关视觉内容。这使得模型在未见视觉场景下仍能保持正确意图,大幅提升实际部署的鲁棒性。这一结果表明,语义时间建模是对像素生成式动态模型的有力补充,为视觉泛化提供了新方向。
行业影响
落地场景
ST-WAM 所提升的视觉泛化能力,可直接赋能需要在非结构化环境中长期部署的机器人系统。典型场景包括:
- 仓储与物流:机器人拣选与分拣任务中,货架、包装、光照条件频繁变化,模型需无视外观干扰,关注任务状态。
- 家庭服务:家用机器人执行整理、摆桌等任务时,必须适应不同家居环境与物体摆放。
- 工业装配:产线换型或视觉传感器老化引起的数据分布偏移,可通过 ST-WAM 减少停产调参成本。
商业价值
对机器人解决方案商而言,ST-WAM 的核心价值在于 降低维护成本 和 提升部署成功率。
| 价值维度 | 具体表现 |
|---|---|
| 降本 | 减少因为视觉偏移导致的抓取失败、重复操作和人工复位,尤其在大规模仓储中,一次调整可能节省数十万成本。 |
| 增收 | 高鲁棒性使机器人能在更多客户现场成功部署,缩短 “现场调试→验收” 周期,加快回款。 |
| 体验 | 家庭或商用服务机器人更少 “犯傻”,提升用户信任和复购率。 |
论文数据显示,真实世界中视觉偏移下成功率从 25.8% 翻倍至 61.5%,这种提升可直接转化为商业指标。
与现有产品/工作流的接口
ST-WAM 的设计易于集成进现有机器人学习栈:
- 无额外预训练:仅需任务演示数据即可端到端训练,不依赖大规模 embodied 预训练,适合资源有限的企业。
- 即插即用的动作预测头:可替换现有 World Action Model (如 Fast-WAM) 的动作推理部分,保持 VAE 等 fine-grained 动态模块不变。
- 推理无生成开销:测试时不需显式预测未来帧,仅通过检索历史语义特征与当前上下文计算动作,适合边缘部署。
例如,一个已使用 Diffusion Policy 或 ACT 的机器人应用,可将策略网络替换为 ST-WAM 的动作解码器,同时保留原有的视觉编码器与任务定义,快速评估提升效果。项目页 ST-WAM 提供了代码与模型,降低集成门槛。
局限
- 依赖 DINOv3 语义表征,可能引入预训练分布偏差。DINOv3 基于互联网图像预训练,与机器人操作场景的视觉分布存在差距。当面临极端光照或全新背景等强烈偏移时,其任务状态区分能力可能退化,进而影响动作预测的鲁棒性。论文仅验证了在当前实验设定下的特征稳定性,未讨论语义表征本身失效时的退化情况。
- 训练目标复杂,且未展示对长序列规划的支持。ST-WAM 联合学习 VAE 潜变量与 DINO 特征预测,使用双空间流匹配目标,相较于单空间方法训练难度和计算开销可能更高。此外,工作聚焦于单步动作预测,没有利用所学未来动态进行多步规划或显式视觉预测,限制了在需要前瞻推理的任务中的应用价值。
- 真实世界实验范围有限,且与最先进视频生成 WAM 的对比较少。虽然真实世界成功率提升显著,但实验场景和视觉偏移类型的多样性有限。论文主要与 Fast-WAM 对比,缺少与基于扩散的规划器等先进视频生成世界模型的深入比较,难以全面体现 ST-WAM 在视觉偏移鲁棒性上的独特优势。